
 AI项目博客
Graph 是 Agent Framework 的底层运行时。我们建议开发者使用Agent Framework,但直接使用Graph API也是完全可行的。
Graph 是一个低级工作流和多智能体编排框架,使开发者能够实现复杂的应用程序编排。
Spring AI Alibaba Graph 是 Agent 编排背后的核心引擎,在底层,Spring AI Alibaba 框架会将 Agent 编排为 Graph,组成一个由节点串联而成的 DAG 图。
Graph 引擎核心概念与定义
Spring AI Alibaba Graph 有以下三个核心概念:
- 状态(State):定义了在 Node 与 Edge 之间传递的数据结构,是整个 Agent 上下文传递的核心载体,具体实现上是一个 Map<String, Object>。
- 节点(Node):Graph 中的每个 Node 是执行逻辑单元,接受当前 State 作为输入,执行某些操作(如调用 LLM 或自定义逻辑),并返回对 State 的更新。
- 边(Edge):定义 Node 间的控制流,可为固定连接,也可依据状态条件动态决定下一步执行路径,实现分支逻辑
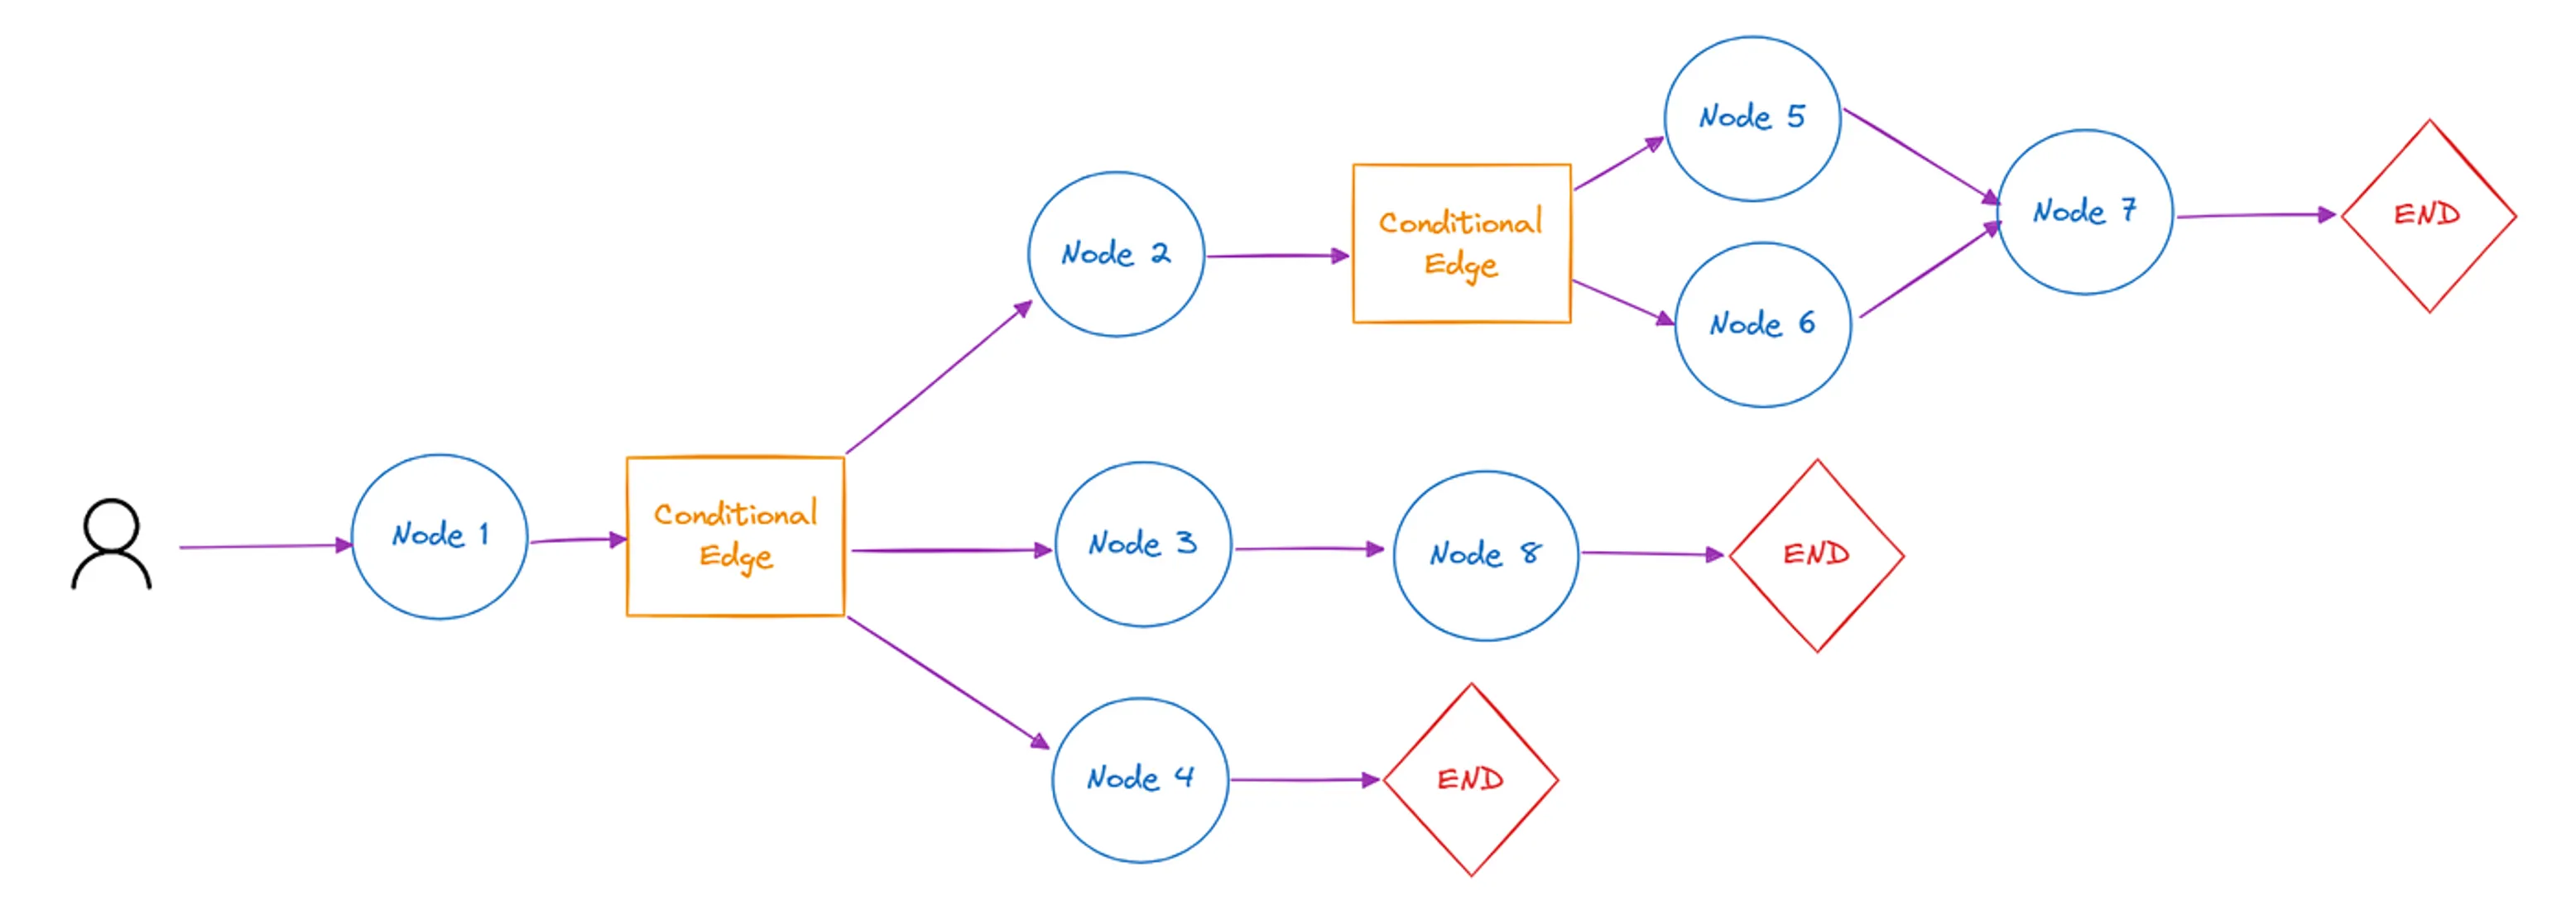
通过组合 Node 和 Edge,开发者可以创建复杂的循环工作流,随着时间的推移不断更新 State 状态。然而,真正的力量来自 Spring AI Alibaba 如何管理这种 State 状态。
简而言之:Node 完成工作,Edge 告诉下一步该做什么。
Graph 引擎提供的 Low-level API
Spring AI Alibaba 同时提供了声明式的 Agentic API 与底层原子化的 Graph API,两种模式都对开发者开发,**Agentic API vs Graph API **应该怎么选?前文我们已经重点介绍了 Agentic API 的开发模式,相比于 Agentic API,Graph API 可以让开发者对流程有更全面的控制,开发者可以独立定义每个 Node 的逻辑、每条边的逻辑,最终按照业务需要编排成完成的流程图。
以下是 Spring AI Alibaba 项目中使用 Graph API 实现 DeepResearch 的流程图定义,演示了 Graph API 的具体使用方法:
Graph 引擎提供更多运行时特性
整个 Spring AI Alibaba 框架底层基于 Spring AI 实现(下图绿色部分),因此在 Augmented LLM 层次提供了 Model、Tool Calling、MCP、RAG 等原子能力的完善定义,具备厂商无关、易用性高、可扩展性强的特点。
在 Agentic Framework 这一层(下图蓝色部分),是 Spring AI Alibaba 框架提供的核心抽象。定义了 Graph 引擎将以及面向开发者的 Agentic API、Graph API 来实现智能体流程编排。
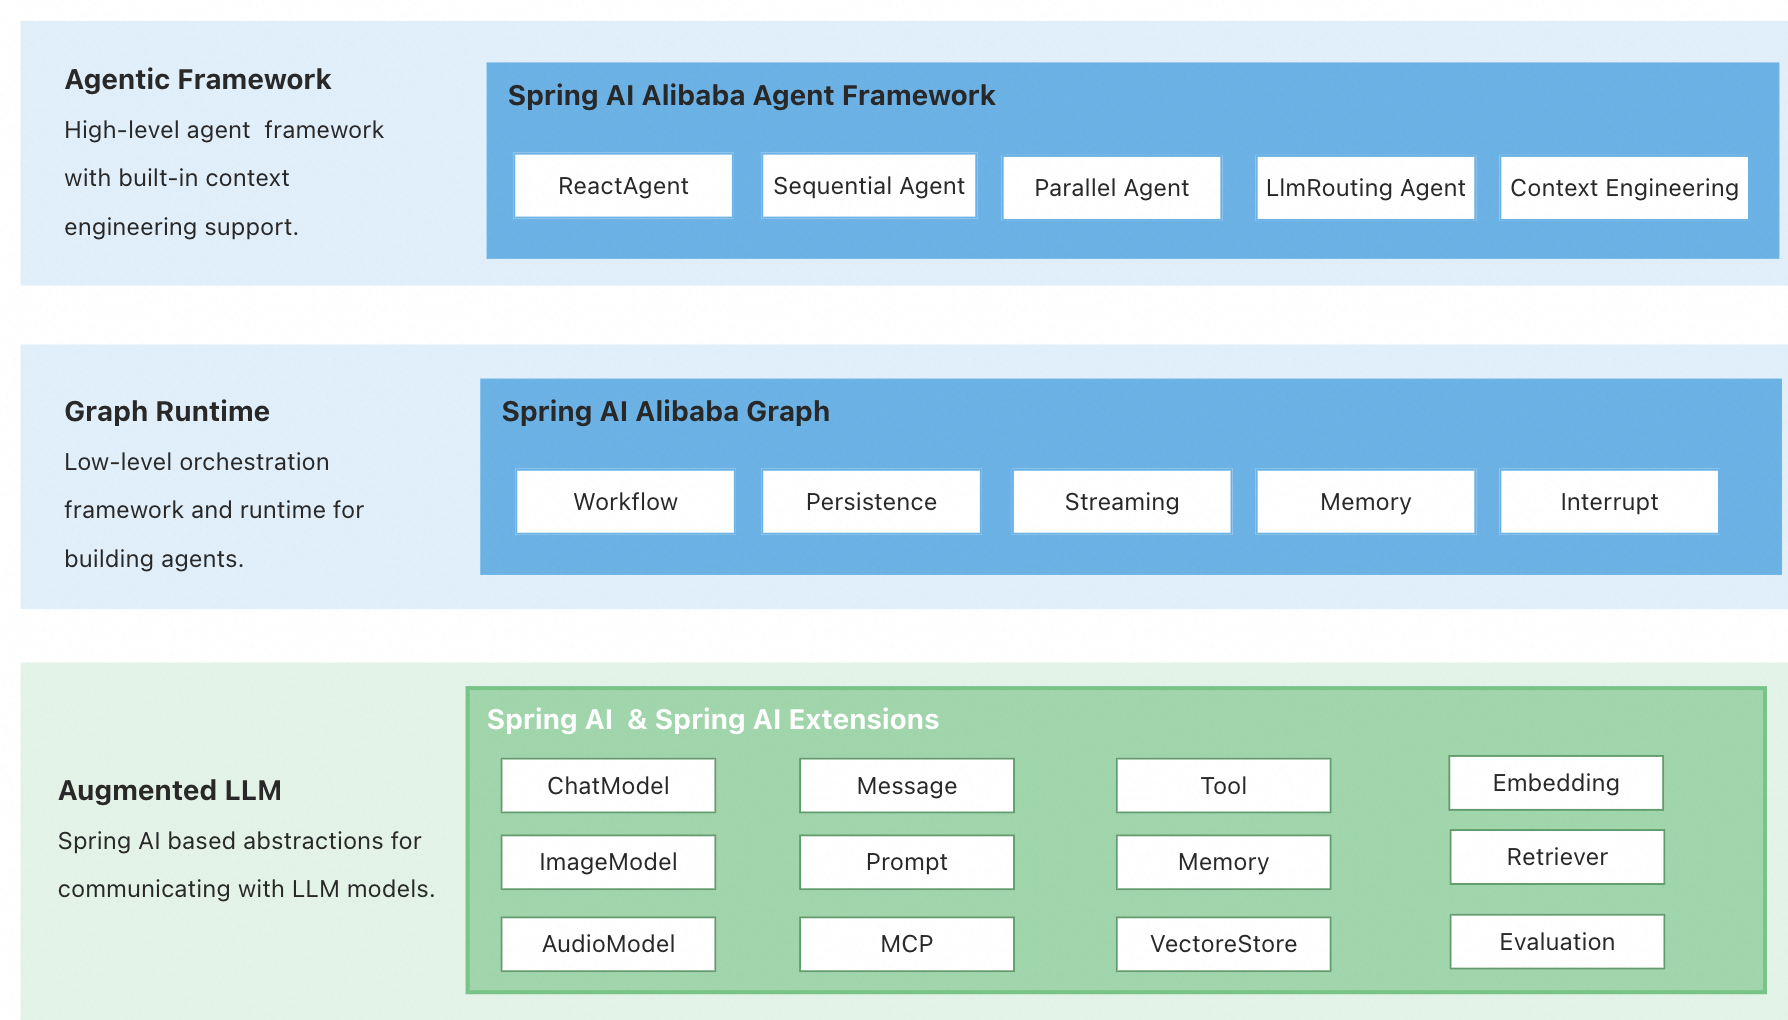
除了流程编排之外,Graph 引擎还原生支持 Streaming、Human In the Loop、Memory & Context 等智能体核心能力。
- **Streaming:**流式响应对于 Agent 交互非常关键,同时与模型生成式的特性非常契合,框架可以将每个 Node 节点的运行情况、LLM Token 实时的发送到用户端。
- **Human In the Loop:**允许对 Agent 运行过程中的工具调用进行评估、修改、批准。在模型驱动的应用中特别有用,让用户具备为 Agent 验证有效性、纠正错误、增加上下文的能力。
- **Memory & Context:**框架可以处理Agent应用运行期的 短期记忆 与 长期记忆。短期记忆是指一个会话周期内的数据、历史消息传递;长期记忆指跨多个会话时,Agent 可以了解历史用户偏好与信息。
在 Spring AI Alibaba Graph 中,Node 是工作流的基本执行单元。每个 Node 负责处理特定的业务逻辑,接收状态(State)作为输入,并返回更新后的状态。
Node 接口
自定义 Node 需要实现 NodeAction 或 NodeActionWithConfig 接口:
public interface NodeAction {
  Map<String, Object> apply(OverAllState state) throws Exception;
}

public interface NodeActionWithConfig {
  Map<String, Object> apply(OverAllState state, RunnableConfig config) throws Exception;
}
主要区别:
- NodeAction:只接收状态作为参数,适用于简单的业务逻辑
- NodeActionWithConfig:额外接收运行配置,可以访问元数据、线程ID等信息,适用于需要上下文信息的场景
基础 Node 示例
以下是一个简单的文本处理 Node:
import com.alibaba.cloud.ai.graph.OverAllState;
import com.alibaba.cloud.ai.graph.action.NodeAction;
import java.util.HashMap;
import java.util.Map;

public class TextProcessorNode implements NodeAction {

  @Override
  public Map<String, Object> apply(OverAllState state) throws Exception {
      // 1. 从状态中获取输入
      String input = state.value("query", "").toString();

      // 2. 执行业务逻辑
      String processedText = input.toUpperCase().trim();

      // 3. 返回更新后的状态
      Map<String, Object> result = new HashMap<>();
      result.put("processed_text", processedText);
      return result;
  }
}
高级 Node 示例:带配置的 AI Node
以下示例展示如何创建一个调用 LLM 的 Node:
import com.alibaba.cloud.ai.graph.OverAllState;
import com.alibaba.cloud.ai.graph.RunnableConfig;
import com.alibaba.cloud.ai.graph.action.NodeActionWithConfig;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.chat.prompt.PromptTemplate;

import java.util.Arrays;
import java.util.HashMap;
import java.util.List;
import java.util.Map;

public class QueryExpanderNode implements NodeActionWithConfig {

  private final ChatClient chatClient;
  private final PromptTemplate promptTemplate;

  public QueryExpanderNode(ChatClient.Builder chatClientBuilder) {
      this.chatClient = chatClientBuilder.build();
      this.promptTemplate = new PromptTemplate(
          "你是一个搜索优化专家。请为以下查询生成 {number} 个不同的变体。
" +
          "原始查询:{query}

" +
          "查询变体:
"
      );
  }

  @Override
  public Map<String, Object> apply(OverAllState state, RunnableConfig config) throws Exception {
      // 获取输入参数
      String query = state.value("query", "").toString();
      Integer number = state.value("expanderNumber", 3);

      // 调用 LLM
      String result = chatClient.prompt()
          .user(user -> user
              .text(promptTemplate.getTemplate())
              .param("query", query)
              .param("number", number))
          .call()
          .content();

      // 处理结果
      String[] variants = result.split("
");

      // 返回更新的状态
      Map<String, Object> output = new HashMap<>();
      output.put("queryVariants", Arrays.asList(variants));
      return output;
  }
}
条件评估 Node
用于工作流中的条件分支判断:
import com.alibaba.cloud.ai.graph.OverAllState;
import com.alibaba.cloud.ai.graph.action.NodeAction;

import java.util.HashMap;
import java.util.Map;

public class ConditionEvaluatorNode implements NodeAction {

  @Override
  public Map<String, Object> apply(OverAllState state) throws Exception {
      String input = state.value("input", "").toString().toLowerCase();

      // 根据输入内容决定路由
      String route;
      if (input.contains("错误") || input.contains("异常")) {
          route = "error_handling";
      } else if (input.contains("数据") || input.contains("分析")) {
          route = "data_processing";
      } else if (input.contains("报告") || input.contains("总结")) {
          route = "report_generation";
      } else {
          route = "default";
      }

      Map<String, Object> result = new HashMap<>();
      result.put("_condition_result", route);
      return result;
  }
}
并行结果聚合 Node
用于收集和聚合并行执行的多个 Node 的结果:
import com.alibaba.cloud.ai.graph.OverAllState;
import com.alibaba.cloud.ai.graph.action.NodeAction;

import java.util.*;

public class ParallelResultAggregatorNode implements NodeAction {

  private final String outputKey;

  public ParallelResultAggregatorNode(String outputKey) {
      this.outputKey = outputKey;
  }

  @Override
  public Map<String, Object> apply(OverAllState state) throws Exception {
      // 收集所有并行任务的结果
      List<String> results = new ArrayList<>();

      // 假设并行任务将结果存储在不同的键中
      state.value("result_1").ifPresent(r -> results.add(r.toString()));
      state.value("result_2").ifPresent(r -> results.add(r.toString()));
      state.value("result_3").ifPresent(r -> results.add(r.toString()));

      // 聚合结果
      String aggregatedResult = String.join("
---
", results);

      Map<String, Object> output = new HashMap<>();
      output.put(outputKey, aggregatedResult);
      return output;
  }
}
集成自定义 Node 到 StateGraph
import com.alibaba.cloud.ai.graph.StateGraph;
import com.alibaba.cloud.ai.graph.KeyStrategyFactory;
import com.alibaba.cloud.ai.graph.KeyStrategy;
import com.alibaba.cloud.ai.graph.state.strategy.ReplaceStrategy;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

import java.util.HashMap;
import java.util.Map;

import static com.alibaba.cloud.ai.graph.action.AsyncNodeAction.node_async;
import static com.alibaba.cloud.ai.graph.action.AsyncEdgeAction.edge_async;

@Configuration
public class WorkflowConfiguration {

  @Bean
  public StateGraph customWorkflowGraph(ChatClient.Builder chatClientBuilder) {
      // 定义状态管理策略
      KeyStrategyFactory keyStrategyFactory = () -> {
          HashMap<String, KeyStrategy> strategies = new HashMap<>();
          strategies.put("query", new ReplaceStrategy());
          strategies.put("processed_text", new ReplaceStrategy());
          strategies.put("queryVariants", new ReplaceStrategy());
          strategies.put("final_result", new ReplaceStrategy());
          return strategies;
      };

      // 构建 StateGraph
      StateGraph graph = new StateGraph(keyStrategyFactory);

      // 添加自定义 Node
      graph.addNode("processor", node_async(new TextProcessorNode()));
      graph.addNode("condition", node_async(new ConditionNode()));

      // 定义边(流程连接)
      graph.addEdge(StateGraph.START, "processor");
      graph.addEdge("processor", "condition");

      // 条件边:根据 condition node 的结果路由
      graph.addConditionalEdges(
          "condition",
          edge_async(state -> state.value("_condition_result", "short").toString()),
          Map.of(
              "long", "processor",  // 长文本重新处理
              "short", StateGraph.END  // 短文本结束
          )
      );

      return graph;
  }
}
Node 开发最佳实践
- 单一职责:每个 Node 应该只负责一个明确的任务
- 状态不可变:不要直接修改输入的 state,而是返回新的状态更新
- 异常处理:在 Node 内部处理可预见的异常,避免中断整个流程
- 日志记录:添加适当的日志以便调试和监控
- 参数验证:在处理前验证从状态中获取的参数
public class RobustNode implements NodeAction {
  private static final Logger logger = LoggerFactory.getLogger(RobustNode.class);

  @Override
  public Map<String, Object> apply(OverAllState state) throws Exception {
      try {
          // 参数验证
          String input = state.value("input")
              .orElseThrow(() -> new IllegalArgumentException("Missing 'input' in state"));

          logger.info("Processing input: {}", input);

          // 业务逻辑
          String result = processInput(input);

          // 返回结果
          Map<String, Object> output = new HashMap<>();
          output.put("output", result);
          return output;

      } catch (Exception e) {
          logger.error("Error in RobustNode", e);
          // 返回错误信息而不是抛出异常
          Map<String, Object> errorOutput = new HashMap<>();
          errorOutput.put("error", e.getMessage());
          return errorOutput;
      }
  }

  private String processInput(String input) {
      // 具体业务逻辑
      return input;
  }
}
在复杂的工作流场景中,可以将 ReactAgent 作为 Node 集成到 StateGraph 中,实现更强大的组合能力。Agent 作为 Node 可以利用其推理和工具调用能力,处理需要多步骤推理的任务。
本文整理自 Spring AI Alibaba 官方文档《工作流编排》:https://java2ai.com/docs/frameworks/agent-framework/advanced/workflow








