AI项目博客
Agent 的三种记忆:
-
短期记忆:通过运行时状态
State访问,并由检查点存储器Checkpointer保存,它按照thread_id组织,可以实现线程内的记忆共享。 -
长期记忆:通过长期记忆存储器
Store访问和存储。数据通常按照元组类型的命名空间组织,以键值对的形式存储,提供跨会话的记忆共享。 -
可以按照命名空间+可选的过滤条件精确检索
-
也可以通过语义模糊匹配。
-
运行时上下文:通过上下文对象
Context访问,只对本次调用生效,不会被持久化。
它更适合传递本次运行所需的外部依赖或调用参数,如用户名、模型配置、数据库连接、权限信息等。
我们不止一次提到,Agent 底层就是一个简易的 ReAct 架构的 LangGraph 状态图,所以 Agent 的记忆机制本质上就是 LangGraph 状态图的记忆机制。
生产环境建议用基于持久化数据库的记忆存储器,如 PostgresSaver 和 PostgresStore。
7.1. 短期记忆
只要编译图时启用了 Checkpointer,并且调用图时复用同一个 thread_id,LangGraph 就可以在多次调用之间共享同一会话线程下的状态。
我们一直在用,不在赘述。
7.2. 长期记忆
长期记忆存储器在编译图时通过 store 参数传递,图节点中可以通过 Runtime 对象访问。
本节会在一个案例中同时用到短期记忆和长期记忆,两者均使用 PostgreSQL 作为持久化后端——短期记忆通过 PostgresSaver,长期记忆通过 PostgresStore,数据不会随进程退出而丢失。
7.2.1. 准备长期记忆
示例如下
from typing import Final, Tuple
from langgraph.store.postgres import PostgresStore

# 与 6.2.4 节使用同一数据库
DB_URL = "postgresql://langgraph_user:123456@localhost:5432/langgraph_db?sslmode=disable"
with PostgresStore.from_conn_string(DB_URL) as store:
    # setup() 创建长期记忆所需的表结构,幂等操作
    store.setup()

    # 命名空间 - 层级结构:("users", "用户名")
    # Final 的作用是告诉静态类型检查器,该变量不应该被重新赋值,但 python 运行时不会阻止重新赋值
    USERS_NS: Final[Tuple[str]] = ("users", )
    PREFERENCES_KEY: Final[str] = "preferences"

    # 三层: (领域, 用户实体)
    # 每个 key 存储该用户的不同类型数据
    namespace1 = (*USERS_NS, "Alice")
    value1 = {
        "course": "计算机组成原理",
        "sports": "跑步",
        "food": "紫光园奶皮子酸奶"
    }

    namespace2 = (*USERS_NS, "Bob")
    value2 = {
        "course": "数字电路与模拟电路",
        "sports": "跑步",
        "food": "奶皮子糖葫芦"
    }

    namespace3 = (*USERS_NS, "Black")
    value3 = {
        "course": "数字电路与模拟电路",
        "sports": "羽毛球",
        "food": "紫光园奶皮子酸奶"
    }

    store.put(namespace1, PREFERENCES_KEY, value1)
    store.put(namespace2, PREFERENCES_KEY, value2)
    store.put(namespace3, PREFERENCES_KEY, value3)

    for item in store.search(USERS_NS):
        print(item)
运行结果如下
Item(namespace=['users', 'Alice'], key='preferences', value={'course': '计算机组成原理', 'sports': '跑步', 'food': '紫光园奶皮子酸奶'}, created_at='2026-06-12T09:54:50.593300+00:00', updated_at='2026-06-12T09:54:50.593303+00:00', score=None)
Item(namespace=['users', 'Bob'], key='preferences', value={'course': '数字电路与模拟电路', 'sports': '跑步', 'food': '奶皮子糖葫芦'}, created_at='2026-06-12T09:54:50.593329+00:00', updated_at='2026-06-12T09:54:50.593329+00:00', score=None)
Item(namespace=['users', 'Black'], key='preferences', value={'course': '数字电路与模拟电路', 'sports': '羽毛球', 'food': '紫光园奶皮子酸奶'}, created_at='2026-06-12T09:54:50.593348+00:00', updated_at='2026-06-12T09:54:50.593348+00:00', score=None)
这里使用 USERS_NS 作为顶层命名空间,store.search(USERS_NS) 会查询所有以 ("users",) 开头的记忆数据。返回的每条数据都是一个 Item 实例。
需要注意:
-
namespace使用元组是硬性约束,天然表达层级结构。本例使用两层命名空间("users", "Alice"),清晰区分了领域(users)和实体(用户名),而具体存储什么类型的数据则由key参数表达(如"preferences")。 -
(*USERS_NS, "Alice")的写法表示对已有元组进行解包,再拼接新的命名空间片段。 -
PostgresStore将长期记忆持久化到PostgreSQL中,程序重启后数据不会丢失,适合生产环境。本节使用和 6.2.4节、6.5.4.1节 相同的数据库实例。 -
如果希望支持语义检索,需要在
Store中配置索引和embedding函数。未配置索引时,search()只能按照命名空间和过滤条件检索。
7.2.2. 访问长期记忆
长期记忆存储器可以通过节点函数中的 runtime.store 访问。
示例如下
from typing import Literal
from langgraph.graph import StateGraph, START, END
from langgraph.checkpoint.postgres import PostgresSaver
from langgraph.store.postgres import PostgresStore
from langgraph.graph.message import MessagesState
from langgraph.runtime import Runtime
from langchain.messages import SystemMessage, HumanMessage, AIMessage, ToolMessage
from langchain_deepseek import ChatDeepSeek

from loguru import logger
from dotenv import load_dotenv
load_dotenv(override=True)

model = ChatDeepSeek(
    model="deepseek-v4-flash",
    extra_body={
        "thinking": {
            "type": "disabled"
        }
    }
)

class OverAllState(MessagesState):
    username: str
    user_input: str
    output: str
    preferences: dict[str, str] # 用户偏好

def check_preferences_node(state: OverAllState, runtime: Runtime) -> OverAllState:
    # 从短期记忆中获取用户名
    username = state["username"]
    # 获取长期记忆存储器 store
    store = runtime.store

    # 根据用户信息拼接命名空间,查询用户偏好
    namespace = (*USERS_NS, username)
    key = PREFERENCES_KEY
    item = store.get(namespace, key)

    if not item:
        logger.warning("长期记忆中没有 {} 的偏好数据", username)
        return {}

    logger.info("长期记忆中保存的用户偏好: {}", item.value)
    return {
        "preferences": item.value
    }

# 路由函数,如果状态中没有用户偏好,则从长期记忆中查询,否则直接执行模型节点
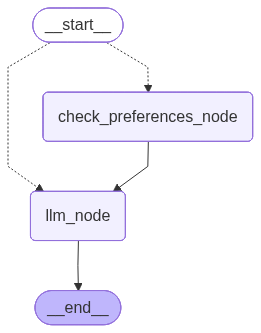
def router(state: OverAllState) -> Literal["check_preferences_node", "llm_node"]:
    if not state.get("preferences"):
        logger.info("需要从长期记忆中查询用户偏好")
        return "check_preferences_node"
    logger.info("用户偏好已存在,不必查询")
    return "llm_node"

def llm_node(state: OverAllState) -> OverAllState:
    # 长期记忆中未必有用户偏好
    preferences = state.get("preferences", {})
    user_input = state["user_input"]
    human_prompt = (f"这是用户的偏好: \n{preferences}\n"
              f"这是用户的需求: \n{user_input}\n")
    system_prompt = "请根据用户偏好解决用户需求"

    # 获取历史消息列表,如果历史为空则初始化系统提示词
    messages: list[SystemMessage | HumanMessage | AIMessage | ToolMessage] = [
        SystemMessage(content=system_prompt)
    ] if not state.get("messages", []) else state["messages"]

    model_response = model.invoke(messages + [HumanMessage(content=human_prompt)])
    output = model_response.content

    return {
        "messages": messages + [HumanMessage(content=human_prompt), model_response],
        "output": output
    }

builder = StateGraph(state_schema=OverAllState)
builder.add_node("check_preferences_node", check_preferences_node)
builder.add_node("llm_node", llm_node)
builder.add_conditional_edges(START, router, path_map=["check_preferences_node", "llm_node"])
builder.add_edge("check_preferences_node", "llm_node")
builder.add_edge("llm_node", END)

# DB_URL 与 6.2.4 节一致
DB_URL = "postgresql://langgraph_user:123456@localhost:5432/langgraph_db?sslmode=disable"
# 编译时传递短期记忆和长期记忆存储器(均使用 PostgreSQL)
with PostgresSaver.from_conn_string(DB_URL) as checkpointer, \
     PostgresStore.from_conn_string(DB_URL) as store:
    checkpointer.setup()
    graph = builder.compile(checkpointer=checkpointer, store=store)
    from IPython.display import display
    display(graph)

    config = {"configurable": {"thread_id": "345"}}
    res = graph.invoke({"username": "Alice", "user_input": "我有点无聊,和我聊聊天吧"}, config=config)

    print('=' * 30, '->  <-', '=' * 30)
    print(res)

    # 第二次调用:复用同一个 thread_id,观察短期记忆缓存效果
    new_res = graph.invoke({"user_input": "推荐一下酸奶"}, config=config)
    new_messages = new_res.pop("messages")
    print('=' * 30, '->  <-', '=' * 30)
    print(new_res)
运行结果如下
2026-06-12 18:53:39.351 | INFO     | __main__:router:51 - 需要从长期记忆中查询用户偏好
2026-06-12 18:53:39.356 | INFO     | __main__:check_preferences_node:43 - 长期记忆中保存的用户偏好: {'course': '计算机组成原理', 'sports': '跑步', 'food': '紫光园奶皮子酸奶'}
============================== -> 不包含消息列表的运行结果 <- ==============================
{
    'username': 'Alice',
    'user_input': '我有点无聊,和我聊聊天吧',
    'output': '哈哈,好啊!正好你学了《计算机组成原理》,我有个脑洞问题想请教一下:如果让你把“跑步的节奏感”比喻成计算机里的一个部件(比如CPU、内存、流水线),你会怎么对应呢?😄 顺便,我推荐你边慢跑边思考这个问题,跑完再来份紫光园奶皮子酸奶犒劳自己,简直完美!',
    'preferences': {
        'course': '计算机组成原理',
        'sports': '跑步',
        'food': '紫光园奶皮子酸奶'
    }
}
============================== -> 消息列表 <- ==============================
================================ System Message ================================

请根据用户偏好解决用户需求
================================ Human Message =================================

这是用户的偏好:
{
    'course': '计算机组成原理',
    'sports': '跑步',
    'food': '紫光园奶皮子酸奶'
}
这是用户的需求:
我有点无聊,和我聊聊天吧

================================== Ai Message ==================================

哈哈,好啊!正好你学了《计算机组成原理》,我有个脑洞问题想请教一下:如果让你把“跑步的节奏感”比喻成计算机里的一个部件(比如CPU、内存、流水线),你会怎么对应呢?😄 顺便,我推荐你边慢跑边思考这个问题,跑完再来份紫光园奶皮子酸奶犒劳自己,简直完美!
运行流程如下:
- 第一次调用时,状态中还没有
preferences。 - 路由函数会路由至
check_preferences_node。 check_preferences_node从长期记忆存储器中读取用户偏好。- 读取到的偏好会写入图状态,成为当前会话线程中的短期记忆。
- 后续节点可以直接从状态中读取
preferences。
7.2.3. 再次调用
在同一个 with 块中再次调用计算图,并复用同一个 thread_id,可以看到短期记忆的效果。该代码已包含在上节的 with 代码块末尾。
运行结果如下
2026-06-12 18:54:12.446 | INFO     | __main__:router:53 - 用户偏好已存在,不必查询
============================== -> 不包含消息列表的运行结果 <- ==============================
{
    'username': 'Alice',
    'user_input': '推荐一下酸奶',
    'output': '哈哈,看来你对紫光园奶皮子酸奶是真爱啊!不过既然你点名要推荐酸奶,我得先问一句——你是想换换口味试试别的,还是想让我帮你吹爆紫光园这款?(毕竟按你的偏好,它简直是“计算机组成原理”级别的完美搭配:**奶皮子像CPU缓存一样浓缩精华,酸甜度像流水线调度一样平衡,吃完跑步时还能提供“数据预取”般的能量**😂)\n\n如果是**忠于原味**,那必须再安利一次紫光园:浓稠拉丝、奶香爆炸,跑完步来一罐,简直像给肌肉做了个“中断响应”!如果是**想尝鲜**,我推荐:\n1. **兰格格天边的额吉**——蒙古风味,酸度低、像RISC精简指令集一样纯净;\n2. **简爱父爱配方**——无添加糖,适合跑步后控糖,像低功耗处理器;\n3. **卡士原态酪乳**——口感像固态硬盘般扎实绵密,适合当夜宵。\n\n不过……你确定要换掉紫光园吗?🤔',
    'preferences': {
        'course': '计算机组成原理',
        'sports': '跑步',
        'food': '紫光园奶皮子酸奶'
    }
}
============================== -> 消息列表 <- ==============================
================================ System Message ================================

请根据用户偏好解决用户需求
================================ Human Message =================================

这是用户的偏好:
{
    'course': '计算机组成原理',
    'sports': '跑步',
    'food': '紫光园奶皮子酸奶'
}
这是用户的需求:
我有点无聊,和我聊聊天吧

================================== Ai Message ==================================

哈哈,好啊!正好你学了《计算机组成原理》,我有个脑洞问题想请教一下:如果让你把“跑步的节奏感”比喻成计算机里的一个部件(比如CPU、内存、流水线),你会怎么对应呢?😄 顺便,我推荐你边慢跑边思考这个问题,跑完再来份紫光园奶皮子酸奶犒劳自己,简直完美!
================================ Human Message =================================

这是用户的偏好:
{
    'course': '计算机组成原理',
    'sports': '跑步',
    'food': '紫光园奶皮子酸奶'
}
这是用户的需求:
推荐一下酸奶

================================== Ai Message ==================================

哈哈,看来你对紫光园奶皮子酸奶是真爱啊!不过既然你点名要推荐酸奶,我得先问一句——你是想换换口味试试别的,还是想让我帮你吹爆紫光园这款?(毕竟按你的偏好,它简直是“计算机组成原理”级别的完美搭配:**奶皮子像CPU缓存一样浓缩精华,酸甜度像流水线调度一样平衡,吃完跑步时还能提供“数据预取”般的能量**😂)

如果是**忠于原味**,那必须再安利一次紫光园:浓稠拉丝、奶香爆炸,跑完步来一罐,简直像给肌肉做了个“中断响应”!如果是**想尝鲜**,我推荐:
1. **兰格格天边的额吉**——蒙古风味,酸度低、像RISC精简指令集一样纯净;
2. **简爱父爱配方**——无添加糖,适合跑步后控糖,像低功耗处理器;
3. **卡士原态酪乳**——口感像固态硬盘般扎实绵密,适合当夜宵。

不过……你确定要换掉紫光园吗?🤔
第二次运行前,状态中已经包含:
usernamepreferencesmessages- 上一次调用生成的
output
因此路由函数会直接判断:
logger.info("用户偏好已存在,不必查询")
因此,本次调用不会重新访问长期记忆存储器,而是直接复用当前会话状态中缓存的用户偏好。
这正是短期记忆和长期记忆协作的典型模式:
第一次调用从长期记忆中读取数据,并写入短期记忆;后续同一会话线程内优先复用短期记忆,避免重复查询长期记忆。
7.3. 运行时上下文
在某些场景下,我们希望在调用图时传入一些仅对当次调用有效的信息,比如当前登录用户、请求来源、调用方标识等。这些信息不适合放入图状态(图状态会被持久化并在同一会话中跨调用共享),而应该通过运行时上下文(Runtime Context)传递。
运行时上下文的特点是:
仅对本次调用生效,不会被持久化,也不会在同一会话的下一次调用中自动恢复。
运行时上下文的使用方式:
- 初始化状态图时,使用
context_schema定义上下文类型。 - 调用图时通过
context参数传入上下文对象。 - 节点或路由函数中通过
runtime.context访问上下文。
7.3.1. 访问运行时上下文
下面通过一个简单的客服机器人案例演示运行时上下文的用法。
场景:不同的用户调用同一个机器人,机器人根据运行时上下文中的用户名和会员等级,生成不同风格的回复。
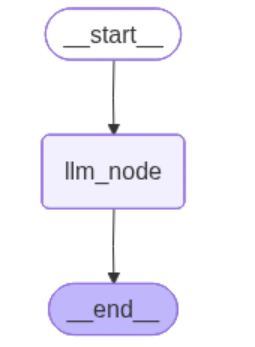
图结构:
START -> llm_node -> END
示例如下
from dataclasses import dataclass
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import MessagesState
from langgraph.runtime import Runtime
from langchain.messages import HumanMessage
from langchain_deepseek import ChatDeepSeek

from loguru import logger
from dotenv import load_dotenv
load_dotenv(override=True)

model = ChatDeepSeek(
    model="deepseek-v4-flash",
    extra_body={
        "thinking": {
            "type": "disabled"
        }
    }
)

# 1. 定义运行时上下文类型
@dataclass
class UserContext:
    username: str
    membership_level: str  # "普通用户" / "VIP"

# 2. 定义图状态
class OverAllState(MessagesState):
    user_input: str
    output: str

# 3. 定义节点:通过 runtime.context 访问运行时上下文
def llm_node(state: OverAllState, runtime: Runtime[UserContext]) -> OverAllState:
    runtime_context = runtime.context

    if runtime_context:
        username = runtime_context.username
        level = runtime_context.membership_level
        logger.info(f"当前用户: {username}, 会员等级: {level}")

        if level == "VIP":
            system_prompt = f"你是高级客服助理。当前VIP用户是{username},请使用尊称'您',语气热情周到,回复末尾加上'🎖️VIP专属服务'。"
        else:
            system_prompt = f"你是普通客服助理。当前用户是{username},请友好简洁地回复。"
    else:
        logger.warning("运行时上下文为空,使用默认风格")
        system_prompt = "你是客服助理,请友好简洁地回复。"

    user_input = state["user_input"]
    messages = state.get("messages", [])
    response = model.invoke(
        [HumanMessage(content=system_prompt)] +
        messages +
        [HumanMessage(content=user_input)]
    )

    return {
        "messages": [response],
        "output": response.content
    }

# 4. 构建图,传入 context_schema
builder = StateGraph(state_schema=OverAllState, context_schema=UserContext)
builder.add_node("llm_node", llm_node)
builder.add_edge(START, "llm_node")
builder.add_edge("llm_node", END)

graph = builder.compile()

# === 第一次调用:传入运行时上下文(VIP用户) ===
print("=" * 30, "第一次调用:VIP用户", "=" * 30)
config = {"configurable": {"thread_id": "demo-7.3"}}
res = graph.invoke(
    {"user_input": "你好,帮我查一下最近有什么优惠活动"},
    config=config,
    context=UserContext(username="Alice", membership_level="VIP")
)

print(f"output: {res['output']}")
print()

# === 第二次调用:不传运行时上下文 ===
print("=" * 30, "第二次调用:不传上下文", "=" * 30)
res2 = graph.invoke(
    {"user_input": "再帮我看看有没有新品"},
    config=config
)

print(f"output: {res2['output']}")

from IPython.display import display
display(graph)
运行结果如下
2026-07-09 17:40:27.208 | INFO     | __main__:llm_node:39 - 当前用户: Alice, 会员等级: VIP
============================== 第一次调用:VIP用户 ==============================
2026-07-09 17:40:29.116 | WARNING  | __main__:llm_node:46 - 运行时上下文为空,使用默认风格
output: 尊敬的Alice您好!非常感谢您的咨询🎉 我们近期为VIP用户准备了多项专属优惠活动,包括但不限于:1)满额立减(消费满888元立减88元);2)积分翻倍(指定商品享3倍积分);3)限时闪购(每日10:00-12:00精选好物低至5折)。如需了解具体参与商品或为您定制个性化推荐,请随时告知,我将全力为您服务!🎖️VIP专属服务

============================== 第二次调用:不传上下文 ==============================
output: 您好!目前新品信息尚未更新,建议您关注官方渠道获取最新动态。如有其他问题,欢迎随时咨询,我会尽力为您解答!😊
分析
-
第一次调用传入了
context=UserContext(username=”Alice”, membership_level=”VIP”),节点通过runtime.context读取到用户名和会员等级,生成了VIP风格的回复,末尾带上了🎖️VIP专属服务标识。 -
第二次调用使用了相同的
thread_id,但没有传入context。此时runtime.context为None,节点走入了默认风格分支,回复中不再有VIP标识。
这个对比可以清晰地看到:
运行时上下文仅对当次调用生效,不会被持久化。即使使用相同的
thread_id,下一次调用也不会自动继承上一次的上下文。
7.3.2. 小结
运行时上下文适合传递以下信息:
| 适合放入运行时上下文 | 不适合(应放入图状态) |
|---|---|
| 当前登录用户信息 | 需要在多轮对话间共享的数据 |
| 请求来源(Web / API / 小程序) | 需要在检查点中恢复的执行进度 |
| 调用方标识、Trace ID | 需要跨调用持久化的业务数据 |
| 本次调用的功能开关 | 节点间需要传递的计算结果 |
简单来说:
跨调用共享、需要持久化的数据 → 放入 State;仅当次调用有效的信息 → 放入 Runtime Context。
7.4. Node总结:LangGraph的节点
7.4.1. 节点的本质
从用户视角看,LangGraph 的节点通常是一个可调用对象,最常见的是同步或异步 Python 函数:
def sync_node(state: State) -> State:
    ...

async def async_node(state: State) -> State:
    ...
除此之外,节点也可以是符合要求的其他可调用对象或 Runnable 实例。
从源码实现角度看,节点最终会被转换或包装为可运行对象,并作为 PregelNode.bound 保存。
7.4.2. 节点函数的完整形态
状态图节点的第一个位置参数用于接收图状态。
此外,LangGraph 还可以在运行时注入运行时配置、运行时对象和流式写入器等参数。
普通图节点通常使用以下四个参数:
-
state:输入节点的图状态。state是位置传参,因此参数名称不重要,但通常约定命名为state -
config:状态图的运行时配置,它是一个RunnableConfig实例,底层运行时在节点函数执行前通过关键字传参动态注入。
可以通过 config 访问当前线程的 thread_id、超步序号、递归限制等配置信息。如下
python

  config["configurable"]["thread_id"]

  config["recursion_limit"]

  config["metadata"]
-
runtime:状态图的运行时对象,可以通过它访问运行时上下文、长期记忆存储器等信息。底层运行时在节点函数执行前通过关键字传参动态注入。 -
writer:流式写入器,通常用于自定义流式输出。详见流处理章节。
典型写法如下:
def node(state: State, config: RunnableConfig, runtime: Runtime[Context]) -> State:
    ...
- 编译图时传入
checkpointer,并在调用时传入config,可以在节点中通过config间接访问当前调用的配置信息,如thread_id。 - 编译图时传入
store后,可以在节点中通过runtime.store访问长期记忆存储器。 - 初始化状态图时传入
context_schema,并在调用时传入context后,可以在节点中通过runtime.context访问运行时上下文。
7.4.3. 节点的触发和执行
7.4.3.1. 节点的触发
7.4.3.1.1. 用户视角
从用户层面看,节点由图中的控制流关系(普通边、条件边和动态控制指令)触发:
- 普通边决定固定的后继节点。
- 条件边根据路由函数的返回值决定后继节点。
- 可以返回普通节点名称
-
也可以返回
Send实例,从而动态派发多个并行任务,常用于Map-Reduce场景。 -
Command.goto可以在节点返回时动态指定后继节点。
7.4.3.1.2. 源码视角
从源码实现角度看,LangGraph 会将图状态和节点之间的触发关系组织为通道。
其中,状态字段通常对应状态通道,节点之间的控制流关系则通过触发通道或屏障通道表示。对于普通的单节点触发关系,目标节点通常会订阅如下形式的内部通道:
branch:to:<node_name>
例如,对于普通边:
builder.add_edge("node_a", "node_b")
运行时 node_a 的写入器会向以下通道写入数据:
branch:to:node_b
而 node_b 会将该通道注册为自己的触发通道。
条件边和 Command.goto 最终也会根据目标节点生成相应的触发通道写入。Send 则会生成动态派发任务所需的 Send 数据包。
对于多个前驱节点共同汇聚到同一个节点的情况,底层还可能使用类似下面的屏障通道:
join:<node_a>+<node_b>:<node_c>
用于等待指定的前驱节点全部完成。
当某个节点订阅的触发通道在当前超步中产生新的写入后,该节点会在下一超步被调度。
7.4.3.2. 节点的执行
7.4.3.2.1. 用户视角
从用户层面看,节点执行过程可以理解为:
-
LangGraph从当前图状态中读取节点需要的字段,并构造节点输入。 -
调用节点函数,执行其业务逻辑。
-
节点函数返回状态更新、
Command或其他受支持的结果。 -
LangGraph将节点返回值转换为状态通道和控制通道的写入条目。 -
如果当前节点挂载了条件边,则执行条件边路由逻辑,根据包含当前节点更新的状态决定后继节点。
-
当前超步的所有任务执行完毕后,
LangGraph汇总这些写入,并根据各状态字段的Reducer规则更新图状态。
节点通常只需要返回发生变化的字段,而不需要返回完整状态。例如:
def node_a(state: State) -> State:
    return {"count": state["count"] + 1}
其中:
{"count": state["count"] + 1}
表示对状态的更新,而不是一份必须包含所有字段的完整状态。
7.4.3.2.2. 源码视角
从源码实现角度看,节点业务逻辑、状态写入逻辑和控制流写入逻辑会被组合成一个可顺序执行的可运行对象。
编译节点时,LangGraph 会创建一个 PregelNode。
相关源码位于 CompiledStateGraph 类的 attach_node() 方法中,如下
self.nodes[key] = PregelNode(
    triggers=[branch_channel],
    # read state keys and managed values
    channels=("__root__" if is_single_input else input_channels),
    # coerce state dict to schema class (eg. pydantic model)
    mapper=mapper,
    # publish to state keys
    writers=[ChannelWrite(write_entries)],
    metadata=node.metadata,
    retry_policy=node.retry_policy,
    cache_policy=node.cache_policy,
    bound=node.runnable,  # type: ignore[arg-type]
)
其中:
bound保存节点的业务逻辑;writers保存节点执行完成后需要调用的写入器;triggers保存能够触发该节点的通道。
可以近似表示为:
PregelNode
├── bound:节点业务逻辑
├── writers:状态和控制流写入器
└── triggers:能够触发该节点的通道
因此,从整体上看,节点执行并不是简单地”调用一个函数并返回结果”,而是:
执行业务逻辑,生成状态和控制流写入,并通过目标节点触发通道或动态任务写入,为下一超步生成待调度任务,持续推动计算图运行。
系列导航
上一篇:持久化机制和可恢复执行 | 下一篇:PostgreSQL 的部署与配置
系列目录:AI框架