AI项目博客
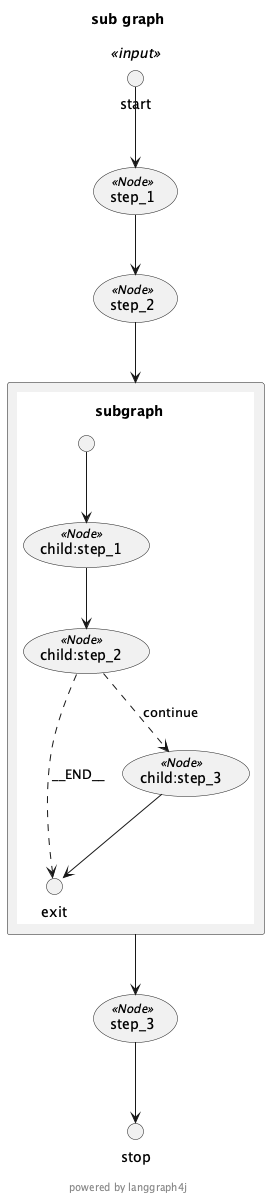
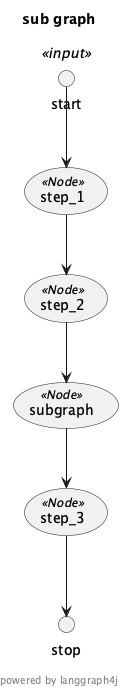
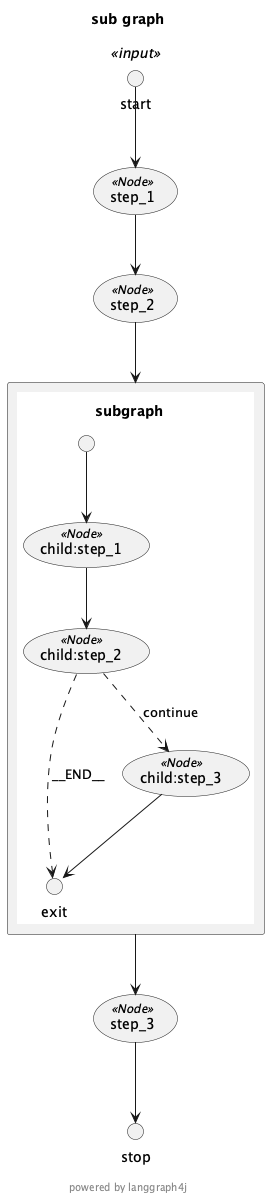
为了克服并行分支中仅支持单步的问题,我们可以使用子图。
示例 – 混合节点和子图
import com.alibaba.cloud.ai.graph.CompiledGraph;
import com.alibaba.cloud.ai.graph.StateGraph;
import static com.alibaba.cloud.ai.graph.StateGraph.END;
import static com.alibaba.cloud.ai.graph.StateGraph.START;
import static com.alibaba.cloud.ai.graph.action.AsyncNodeAction.node_async;

// 创建子图 A3
StateGraph subgraphA3Builder = new StateGraph(keyStrategyFactory)
      .addNode("A3.1", makeNode("A3.1"))
      .addNode("A3.2", makeNode("A3.2"))
      .addEdge(START, "A3.1")
      .addEdge("A3.1", "A3.2")
      .addEdge("A3.2", END);

CompiledGraph subgraphA3 = subgraphA3Builder.compile();

// 创建子图 A1
StateGraph subgraphA1Builder = new StateGraph(keyStrategyFactory)
      .addNode("A1.1", makeNode("A1.1"))
      .addNode("A1.2", makeNode("A1.2"))
      .addEdge(START, "A1.1")
      .addEdge("A1.1", "A1.2")
      .addEdge("A1.2", END);

CompiledGraph subgraphA1 = subgraphA1Builder.compile();

// 主图:混合使用节点和子图
StateGraph workflow = new StateGraph(keyStrategyFactory)
      .addNode("A", makeNode("A"))
      .addNode("A1", node_async(state -> subgraphA1.invoke(state.data()).orElseThrow().data()))
      .addNode("A2", makeNode("A2"))
      .addNode("A3", node_async(state -> subgraphA3.invoke(state.data()).orElseThrow().data()))
      .addNode("B", makeNode("B"))
      .addEdge("A", "A1")
      .addEdge("A", "A2")
      .addEdge("A", "A3")
      .addEdge("A1", "B")
      .addEdge("A2", "B")
      .addEdge("A3", "B")
      .addEdge(START, "A")
      .addEdge("B", END);

CompiledGraph graph = workflow.compile();
图示:
START
          |
          A
        / |
    ┌────┐ ┌────┐ ┌────┐
    │ A1 │ │ A2 │ │ A3 │
    │子图│ │节点│ │子图│
    └────┘ └────┘ └────┘
         | /
          B
          |
         END
示例 – 仅使用子图
// 创建三个子图
CompiledGraph subgraphA1 = new StateGraph(keyStrategyFactory)
  .addNode("A1.1", makeNode("A1.1"))
  .addNode("A1.2", makeNode("A1.2"))
  .addEdge(START, "A1.1")
  .addEdge("A1.1", "A1.2")
  .addEdge("A1.2", END)
  .compile();

CompiledGraph subgraphA2 = new StateGraph(keyStrategyFactory)
  .addNode("A2.1", makeNode("A2.1"))
  .addNode("A2.2", makeNode("A2.2"))
  .addEdge(START, "A2.1")
  .addEdge("A2.1", "A2.2")
  .addEdge("A2.2", END)
  .compile();

CompiledGraph subgraphA3 = new StateGraph(keyStrategyFactory)
  .addNode("A3.1", makeNode("A3.1"))
  .addNode("A3.2", makeNode("A3.2"))
  .addEdge(START, "A3.1")
  .addEdge("A3.1", "A3.2")
  .addEdge("A3.2", END)
  .compile();

// 主图:仅使用子图
StateGraph workflow = new StateGraph(keyStrategyFactory)
  .addNode("A", makeNode("A"))
  .addNode("A1", node_async(state -> subgraphA1.invoke(state.data()).orElseThrow().data()))
  .addNode("A2", node_async(state -> subgraphA2.invoke(state.data()).orElseThrow().data()))
  .addNode("A3", node_async(state -> subgraphA3.invoke(state.data()).orElseThrow().data()))
  .addNode("B", makeNode("B"))
  .addEdge("A", "A1")
  .addEdge("A", "A2")
  .addEdge("A", "A3")
  .addEdge("A1", "B")
  .addEdge("A2", "B")
  .addEdge("A3", "B")
  .addEdge(START, "A")
  .addEdge("B", END);

CompiledGraph graph = workflow.compile();
import com.alibaba.cloud.ai.graph.StateGraph;
import com.alibaba.cloud.ai.graph.CompiledGraph;
import java.util.concurrent.ForkJoinPool;
// 定义状态
KeyStrategyFactory keyStrategyFactory = () -> {
Map<String, KeyStrategy> keyStrategyMap = new HashMap<>();
keyStrategyMap.put("data", new ReplaceStrategy());
keyStrategyMap.put("results", new AppendStrategy());
return keyStrategyMap;
};
// 数据处理节点
var processTypeA = node_async(state -> {
String data = (String) state.value("data").orElse("");
String result = "Type A processed: " + data;
return Map.of("results", List.of(result));
});
var processTypeB = node_async(state -> {
String data = (String) state.value("data").orElse("");
String result = "Type B processed: " + data;
return Map.of("results", List.of(result));
});
var processTypeC = node_async(state -> {
String data = (String) state.value("data").orElse("");
String result = "Type C processed: " + data;
return Map.of("results", List.of(result));
});
// 聚合结果
var aggregateResults = node_async(state -> {
List<String> results = (List<String>) state.value("results").orElse(List.of());
String aggregated = String.join(", ", results);
return Map.of("final_result", aggregated);
});
// 构建图
StateGraph stateGraph = new StateGraph(keyStrategyFactory)
.addNode("process_a", processTypeA)
.addNode("process_b", processTypeB)
.addNode("process_c", processTypeC)
.addNode("aggregate", aggregateResults)
.addEdge(START, "process_a")
.addEdge(START, "process_b")
.addEdge(START, "process_c")
.addEdge("process_a", "aggregate")
.addEdge("process_b", "aggregate")
.addEdge("process_c", "aggregate")
.addEdge("aggregate", END);
CompiledGraph graph = stateGraph.compile();
// 配置并行执行器
RunnableConfig config = RunnableConfig.builder()
.addParallelNodeExecutor("process_a", ForkJoinPool.commonPool())
.addParallelNodeExecutor("process_b", ForkJoinPool.commonPool())
.addParallelNodeExecutor("process_c", ForkJoinPool.commonPool())
.build();
// 执行
Map<String, Object> result = graph.invoke(
Map.of("data", "Sample Data"),
config
);- 合理使用并行:仅在节点之间没有数据依赖时使用并行执行。
- 线程池管理:使用适当大小的线程池,避免过度并发。
- 错误处理:确保并行节点都有适当的错误处理。
- 状态同步:使用适当的状态策略(如 AppendStrategy)来合并并行结果。
- 性能监控:监控并行执行的性能收益,确保它确实提高了性能。
通过并行节点,您可以显著提高工作流的执行效率,特别是在处理独立任务时。
更多详细示例,请参阅 parallel-node 示例。
本文整理自 Spring AI Alibaba 官方文档《并行节点定义》:https://java2ai.com/docs/frameworks/graph-core/examples/parallel-branch