
 AI项目博客
本系列共 9 篇,从空目录搭到可部署的 Python RAG 知识库。这是第 5 篇。
切片有了,但还只是一堆文本。这一篇把每张切片变成一串 1024 个数字的向量,存进 PostgreSQL 的 pgvector,并处理失败重试、状态回写和卡死任务。
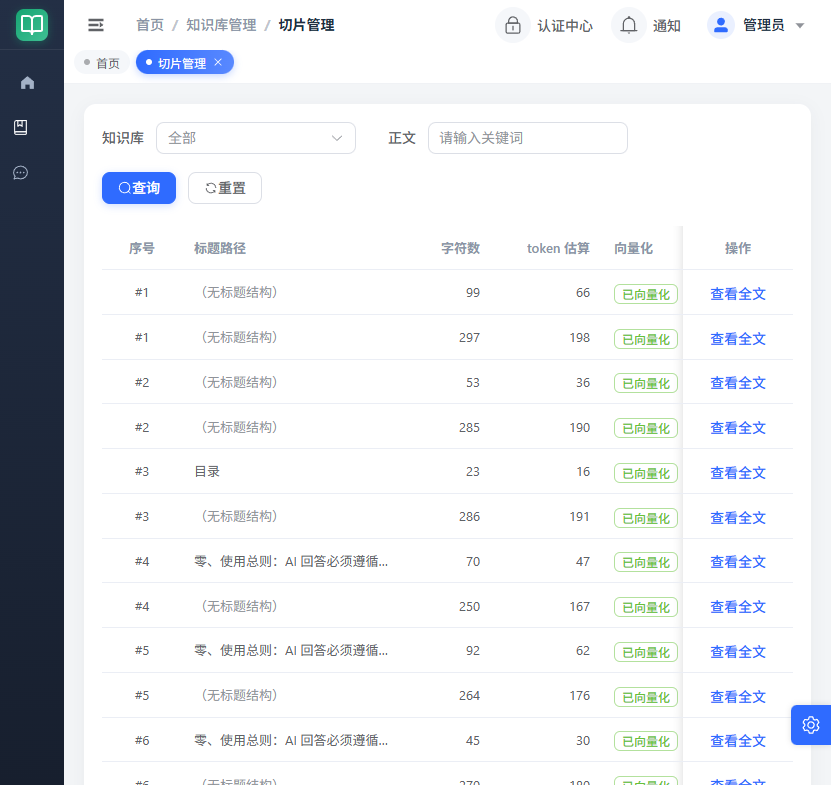
图:切片管理,每条切片显示字符数、token 估算与向量化状态。
一、Embedding:把“意思”变成数字
调用的是 OpenAI 兼容的 /v1/embeddings 接口,本机 Ollama、云端供应商都能接。一次可以传多段文本,这里按 64 条一批。
async def embed_texts(texts: list[str]) -> tuple[list[list[float]], int]:

    response = await client.post(

        f"{settings.embed_base_url.rstrip('/')}/v1/embeddings",

        json={"model": settings.embed_model, "input": texts},

        headers=headers,

    )

    body = response.json()

    data = sorted(body["data"], key=lambda item: item.get("index", 0))

    vectors = [item["embedding"] for item in data]

    if vectors and len(vectors[0]) != settings.vector_dim:

        raise PlatformException(

            f"向量维度不符:模型返回 {len(vectors[0])},"

            f"配置 KB_VECTOR_DIM={settings.vector_dim}"

        )

    return vectors, tokens
两个细节:返回结果一定要按 index 排序,供应商乱序时不会报错,但向量会和切片错配,检索结果会变得莫名其妙;维度必须校验,1024 的表塞不进 768 的向量。
二、pgvector:向量就是普通的一列
向量表和切片表同库,主键 chunk_id 唯一,一个切片一条向量。除了 embedding,还冗余存一份 content,召回后拼提示词时就不用再回表。
CREATE TABLE kb_chunk_vec (

    id          BIGINT GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,

    chunk_id    BIGINT NOT NULL UNIQUE,

    tenant_id   BIGINT,

    base_id     BIGINT NOT NULL,

    doc_id      BIGINT NOT NULL,

    version     INT DEFAULT 1,

    content     TEXT,

    embedding   vector(1024) NOT NULL

);

CREATE INDEX idx_kb_vec_embedding ON kb_chunk_vec

    USING hnsw (embedding vector_cosine_ops);
写入用 ON CONFLICT (chunk_id) DO UPDATE,同一个切片重算向量时直接覆盖,不会产生重复行。SQL 里用 CAST(:embedding AS vector) 把参数转成向量字面量:
sql = text("""

    INSERT INTO kb_chunk_vec

        (chunk_id, tenant_id, base_id, doc_id, version, content, embedding)

    VALUES

        (:chunk_id, :tenant_id, :base_id, :doc_id, :version, :content,

         CAST(:embedding AS vector))

    ON CONFLICT (chunk_id) DO UPDATE

    SET embedding = EXCLUDED.embedding,

        content   = EXCLUDED.content,

        version   = EXCLUDED.version

""")
三、批量向量化:一批失败不影响其他批
把待处理切片按 64 条分组,每批单独调用、单独提交。某批失败只把这一批标成失败,下一批继续跑。
for start in range(0, len(rows), batch_size):

    batch = rows[start:start + batch_size]

    batch_ids = [row["chunk_id"] for row in batch]

    try:

        vectors, tokens = await embeddings.embed_texts([row["content"] for row in batch])

        await vector_store.upsert_many(session, [

            {**row, "embedding": vector} for row, vector in zip(batch, vectors)

        ])

        await session.execute(update(KbChunk)

            .where(KbChunk.id.in_(batch_ids))

            .values(embed_status=2))

        await session.commit()

        await ai_log.record(scene=1, model=settings.embed_model,

                            tokens=tokens, success=True, ...)

    except Exception as exc:

        await session.rollback()

        await session.execute(update(KbChunk)

            .where(KbChunk.id.in_(batch_ids))

            .values(embed_status=3))

        await session.commit()

await ai_log.record(..., success=False, error_msg=str(exc))失败也要记流水,因为请求已经发出,多数供应商照样计费。还有一个容易忽略的点:rollback() 会让 ORM 实例全部过期,失败分支再访问字段会报 MissingGreenlet。所以进循环前先把 chunk_id/content/tenant_id 拷成普通字典。
四、补偿任务:谁没向量化,自己会补
上传成功只意味着“待向量化”。后台任务每 30 秒扫一批 embed_status=0 的切片,流程是:
- 先把卡在“向量化中”超过 10 分钟的切片重置为待处理;
- 捞 200 条待处理切片;
- 按租户分组,检查租户的月度 token 配额;
- 把这一组标记为“向量化中”,防止多副本重复调用模型;
- 调 Embedding、写 pgvector、回写状态;
- 按切片结果重算文档级状态:还有待处理就是待处理,有失败就是失败,全成功就是成功。
“标记中”这一步是省钱的关键:模型调用是外部计费动作,不能让两个副本同时处理同一批。状态卡在“中”也要有兜底,否则进程一崩,这批切片永远不会再被扫到。
五、验证一下
-- 切片数和向量数应该一致(当前版本)

SELECT count(*) FROM kb_chunk;

SELECT count(*) FROM kb_chunk_vec;

-- 看一眼最近写入的向量

SELECT chunk_id, doc_id, version,

       1 - (embedding <=> (SELECT embedding FROM kb_chunk_vec LIMIT 1)) AS similarity

FROM kb_chunk_vec

ORDER BY embedding <=> (SELECT embedding FROM kb_chunk_vec LIMIT 1)

LIMIT 5;
如果两个 count 对不上,先看切片状态:失败(3)会重试,待处理(0)说明补偿任务没跑或配额被拦。
六、本篇踩坑
- 维度不一致。 换 Embedding 模型必须先确认维度,否则写入直接失败。
- 向量表报错会污染整个事务。 在 PostgreSQL 里,一条语句失败后整个事务变成 aborted,后面的关键词查询也会连坐。向量操作包一层 SAVEPOINT,失败只降级。
- HNSW 索引不是无条件生效。 查询必须带
ORDER BY 距离和LIMIT,否则可能走全表扫描。 - 状态卡死。 “向量化中”必须有超时重置,不然一次进程崩溃会留下永久积压。
下一篇
向量有了,接下来回答一个关键问题:用户提问时,怎么在几秒内从成千上万张切片里找出最相关的几段?下一篇讲向量 + 关键词的双路召回和 RRF 融合。
上一篇:解析、切片与补偿任务 | 下一篇:混合检索:向量 + 关键词








