AI项目博客
这一篇实现交卷之后的所有环节:判分、人工阅卷、成绩展示、错题归集、统计分析。核心矛盾是——怎么在「给考生更多信息」和「不泄露答案」之间找平衡。
一、判分器的完整实现
先把判分器整个放出来,因为这个类的设计决定了后面所有环节的正确性。
package com.laijun.exam.take.grader;

/**

 * 客观题自动判分器。

 *

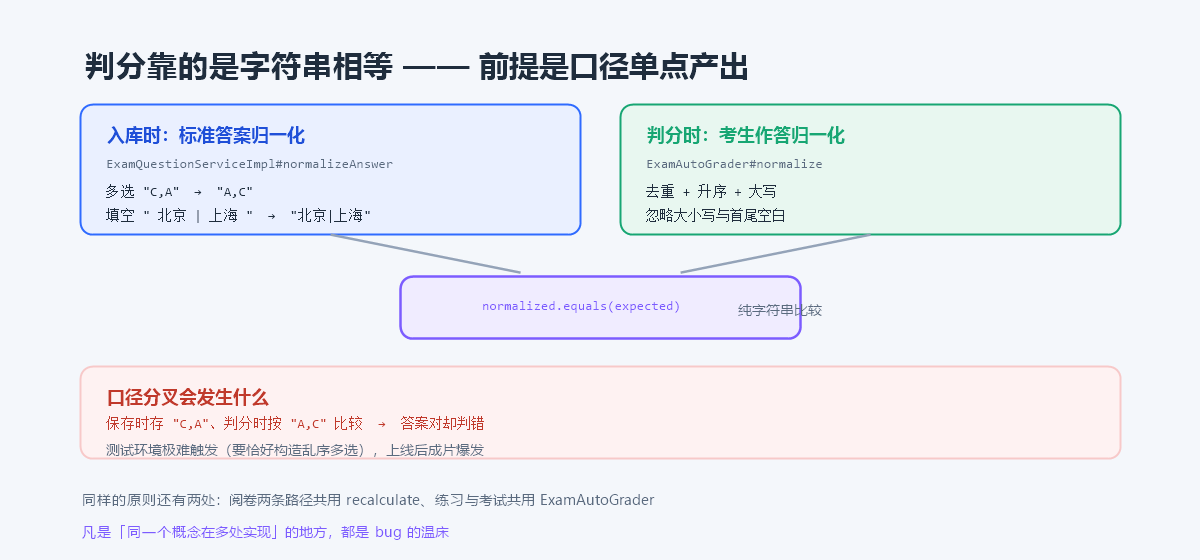
 * <p>判分口径必须与题库保存时的「答案归一化」完全一致

 * (见 ExamQuestionServiceImpl#normalizeAnswer),否则会出现「答案对却判错」:</p>

 * <ul>

 *   <li><b>单选</b>:单个选项 key,转大写后字符串比较</li>

 *   <li><b>多选</b>:选项 key 去重后按字母升序逗号拼接,字符串比较</li>

 *   <li><b>判断</b>:1 对 / 0 错</li>

 *   <li><b>填空</b>:各空答案用 | 分隔;按空逐一对齐比较,忽略大小写与首尾空白</li>

 * </ul>

 *

 * <p>判分策略默认「全对给分」;当考试开启「多选半对给分 / 填空按空给分」时,

 * 多选漏选得半分、填空按答对空数比例折算。策略随组卷快照定格,

 * 历史成绩不受后续配置改动影响。</p>

 */

@Component

public class ExamAutoGrader {

    private static final String BLANK_SEPARATOR = "|";   // 填空题多空分隔符

    private static final String ANSWER_SEPARATOR = ",";  // 多选答案分隔符

    /** 整卷判分 */

    public ExamGradingResult grade(ExamPaperSnapshot snapshot, Map<Long, String> answers) {

        List<ExamSnapshotQuestion> questions = snapshot == null || snapshot.getQuestions() == null

                ? List.of() : snapshot.getQuestions();

        // 判分策略随快照定格,与考生作答时的考试配置一致

        boolean multiplePartial = isFlagOn(snapshot == null ? null : snapshot.getMultiplePartialScore());

        boolean blankPartial = isFlagOn(snapshot == null ? null : snapshot.getBlankPartialScore());

        List<ExamQuestionGrade> details = new ArrayList<>(questions.size());

        BigDecimal total = BigDecimal.ZERO;

        int correctCount = 0;

        int blankCount = 0;

        int manualCount = 0;

        for (ExamSnapshotQuestion question : questions) {

            String raw = answers == null ? null : answers.get(question.getQuestionId());

            ExamQuestionGrade grade = gradeOne(question, raw, multiplePartial, blankPartial);

            details.add(grade);

            // 无条件累加:半对给分时 score 可能介于 0 与满分之间,不能再以 correct 作为累加条件

            total = total.add(grade.getScore() == null ? BigDecimal.ZERO : grade.getScore());

            if (Boolean.TRUE.equals(grade.getCorrect())) {

                correctCount++;

            }

            if (!StringUtils.hasText(grade.getUserAnswer())) {

                blankCount++;

            }

            if (Boolean.TRUE.equals(grade.getManual())) {

                manualCount++;

            }

        }

        ExamGradingResult result = new ExamGradingResult();

        result.setDetails(details);

        result.setTotalScore(total);

        result.setCorrectCount(correctCount);

        result.setBlankCount(blankCount);

        result.setManualCount(manualCount);

        return result;

    }

    /** 单题判分 */

    private ExamQuestionGrade gradeOne(ExamSnapshotQuestion question, String rawAnswer,

                                       boolean multiplePartial, boolean blankPartial) {

        QuestionTypeEnum type = QuestionTypeEnum.fromCode(question.getQuestionType());

        BigDecimal fullScore = question.getScore() == null ? BigDecimal.ZERO : question.getScore();

        ExamQuestionGrade grade = new ExamQuestionGrade();

        grade.setQuestionId(question.getQuestionId());

        grade.setQuestionType(question.getQuestionType());

        if (type == null || !StringUtils.hasText(rawAnswer)) {

            // 题型未知或未作答:不得分,但保留原始作答便于查卷

            grade.setUserAnswer(StringUtils.hasText(rawAnswer) ? rawAnswer.trim() : null);

            grade.setCorrect(false);

            grade.setScore(BigDecimal.ZERO);

            return grade;

        }

        if (type == QuestionTypeEnum.SHORT_ANSWER) {

            // 主观题不可自动判分:原样保留考生文本,得分暂记 0,标记为待人工阅卷

            grade.setUserAnswer(rawAnswer.trim());

            grade.setCorrect(false);

            grade.setScore(BigDecimal.ZERO);

            grade.setManual(true);

            return grade;

        }

        String normalized = normalize(type, rawAnswer);

        String expected = normalizeExpected(type, question.getAnswer());

        boolean fullyCorrect = normalized != null && normalized.equals(expected);

        grade.setUserAnswer(normalized);

        grade.setCorrect(fullyCorrect);

        grade.setScore(fullyCorrect ? fullScore

                : partialScore(type, normalized, expected, fullScore, multiplePartial, blankPartial));

        return grade;

    }

    /** 部分得分(仅在未全对时调用) */

    private BigDecimal partialScore(QuestionTypeEnum type, String normalized, String expected,

                                    BigDecimal fullScore,

                                    boolean multiplePartial, boolean blankPartial) {

        if (type == QuestionTypeEnum.MULTIPLE && multiplePartial) {

            return multiplePartialScore(normalized, expected, fullScore);

        }

        if (type == QuestionTypeEnum.BLANK && blankPartial) {

            return blankPartialScore(normalized, expected, fullScore);

        }

        return BigDecimal.ZERO;   // 默认「全对给分」

    }

    /** 多选半对给分:漏选(所选为标准答案的真子集)给一半,错选不得分 */

    private BigDecimal multiplePartialScore(String normalized, String expected, BigDecimal fullScore) {

        if (normalized == null || expected == null) {

            return BigDecimal.ZERO;

        }

        Set<String> user = keySet(normalized);

        Set<String> all = keySet(expected);

        if (user.isEmpty() || user.size() >= all.size()) {

            return BigDecimal.ZERO;

        }

        return all.containsAll(user)

                ? fullScore.divide(BigDecimal.valueOf(2), 2, RoundingMode.HALF_UP)

                : BigDecimal.ZERO;

    }

    /** 填空按空给分:按「答对空数 / 标准空数」折算 */

    private BigDecimal blankPartialScore(String normalized, String expected, BigDecimal fullScore) {

        if (normalized == null || expected == null) {

            return BigDecimal.ZERO;

        }

        String[] userBlanks = normalized.split("\" + BLANK_SEPARATOR, -1);

        String[] expectedBlanks = expected.split("\" + BLANK_SEPARATOR, -1);

        if (expectedBlanks.length == 0) {

            return BigDecimal.ZERO;

        }

        int matched = 0;

        for (int i = 0; i < expectedBlanks.length; i++) {

            String userBlank = i < userBlanks.length ? userBlanks[i] : "";

            if (!expectedBlanks[i].isEmpty() && expectedBlanks[i].equals(userBlank)) {

                matched++;

            }

        }

        if (matched <= 0) {

            return BigDecimal.ZERO;

        }

        return fullScore.multiply(BigDecimal.valueOf(matched))

                .divide(BigDecimal.valueOf(expectedBlanks.length), 2, RoundingMode.HALF_UP);

    }

    /** 归一化考生作答(与题库保存口径一致) */

    private String normalize(QuestionTypeEnum type, String rawAnswer) {

        String trimmed = rawAnswer.trim();

        if (trimmed.isEmpty()) {

            return null;

        }

        return switch (type) {

            case SINGLE -> trimmed.toUpperCase();

            case MULTIPLE -> normalizeKeySet(trimmed);

            case JUDGE -> trimmed;

            case BLANK -> normalizeBlanks(trimmed);

            // 简答题不走自动判分(gradeOne 已提前返回),此处仅保证 switch 完备

            case SHORT_ANSWER -> trimmed;

        };

    }

    /**

     * 归一化标准答案。

     * <p>标准答案入库时已按同一口径归一化,这里再走一遍是为了兼容

     * 题库早期数据或人工订正时的宽松写法(如多选写成 "C,A")。</p>

     */

    private String normalizeExpected(QuestionTypeEnum type, String expected) {

        if (!StringUtils.hasText(expected)) {

            return null;

        }

        return normalize(type, expected);

    }

    /** 多选归一化:按逗号拆分、去重、字母升序拼接 */

    private String normalizeKeySet(String raw) {

        Set<String> keys = new LinkedHashSet<>();

        for (String part : raw.split(ANSWER_SEPARATOR, -1)) {

            if (StringUtils.hasText(part)) {

                keys.add(part.trim().toUpperCase());

            }

        }

        if (keys.isEmpty()) {

            return null;

        }

        List<String> sorted = new ArrayList<>(keys);

        sorted.sort(Comparator.naturalOrder());

        return String.join(ANSWER_SEPARATOR, sorted);

    }

    /** 填空归一化:按空拆分、逐空 trim + 小写、用 | 重新拼接 */

    private String normalizeBlanks(String raw) {

        List<String> blanks = new ArrayList<>();

        for (String part : raw.split("\" + BLANK_SEPARATOR, -1)) {

            blanks.add(part.trim().toLowerCase());

        }

        return String.join(BLANK_SEPARATOR, blanks);

    }

}
1.1 为什么归一化口径这么重要
看判分的最后一步:normalized.equals(expected)——就是一个字符串相等判断。
能做到这么简单,前提是「考生作答」和「标准答案」都经过了同一套归一化。如果口径不一致:保存时存的是 C,A,判分时按 A,C 比较,就会出现”答案对却判错”。这类 bug 在测试环境极难触发(要恰好构造出乱序多选、或大小写不同的填空),上线后却会成片爆发。
所以口径必须单点产出:题库保存时由 ExamQuestionServiceImpl#normalizeAnswer 归一化,判分时由 ExamAutoGrader#normalize 归一化,两处的实现必须保持同步。代码注释里特意标了这层依赖关系。
二、交卷时判分
判分发生在交卷的那一刻,逻辑已经在上一篇的 doSubmit 里:
ExamPaperSnapshot snapshot = parseSnapshot(record.getPaperSnapshot());

Map<Long, String> answers = examDraftStore.loadDrafts(record.getId());

ExamGradingResult grading = examAutoGrader.grade(snapshot, answers);

// 先清旧明细:强制交卷与手动交卷可能并发到同一答卷,保证幂等

examAnswerService.remove(new LambdaQueryWrapper<ExamAnswerEntity>()

        .eq(ExamAnswerEntity::getRecordId, record.getId()));

examAnswerService.saveBatch(buildAnswers(record.getId(), grading.getDetails()));

record.setTotalScore(grading.getTotalScore());

record.setPassFlag(passed ? 1 : 0);

record.setManualPending(grading.getManualCount() > 0 ? 1 : 0);
答题明细的落库:
private List<ExamAnswerEntity> buildAnswers(Long recordId, List<ExamQuestionGrade> grades) {

    List<ExamAnswerEntity> entities = new ArrayList<>();

    if (CollectionUtils.isEmpty(grades)) {

        return entities;

    }

    for (ExamQuestionGrade grade : grades) {

        ExamAnswerEntity entity = new ExamAnswerEntity();

        entity.setRecordId(recordId);

        entity.setQuestionId(grade.getQuestionId());

        entity.setQuestionType(grade.getQuestionType());

        entity.setUserAnswer(grade.getUserAnswer());

        entity.setIsCorrect(Boolean.TRUE.equals(grade.getCorrect()) ? 1 : 0);

        entity.setScore(grade.getScore() == null ? BigDecimal.ZERO : grade.getScore());

        // 主观题本次未评分(待人工阅卷),客观题交卷即已判分

        entity.setGraded(Boolean.TRUE.equals(grade.getManual()) ? 0 : 1);

        entities.add(entity);

    }

    return entities;

}
graded 字段是区分两种状态的关键:客观题交卷即判分(graded=1),简答题等待阅卷(graded=0)。
三、成绩必须回读,不能复用返回值
这是个容易做错的地方。直觉做法是:交卷接口返回成绩,前端拿到后存起来,结果页显示这份数据。但这样会有问题——刷新页面、换个标签页、过几天从「我的考试」点进来,成绩就没了,因为它是随响应传递的临时状态。
/**

 * 按答卷Id查询交卷结果。

 *

 * <p><b>为什么必须回读而不是复用交卷时的返回值</b>:判分只在交卷那一刻发生一次,

 * 之后的所有进入(刷新结果页、换标签页、过几天从「我的考试」点进来)都只能从

 * 答卷与答题明细回读。否则成绩就只存在于那一次 HTTP 响应里,一刷新即丢失。</p>

 */

@Override

public ExamSubmitResultVO result(Long recordId) {

    ExamRecordEntity record = requireOwnRecord(recordId);

    // 得分 / 及格标志直接取答卷字段,答对数由答题明细统计

    // ...

}
对应两个接口:
GET /exam/take/result/{recordId}     成绩页(从库回读)

GET /exam/take/review/{recordId}     答题回顾(快照 + 明细合并)
同时在「我的考试」列表里返回 latest_record_id(最近一次已交卷答卷),作为成绩页的入口。这样无论什么时候进来,看到的都是同一份持久化结果。
归属校验与其它考生端接口一致:答卷必须属于当前登录用户。
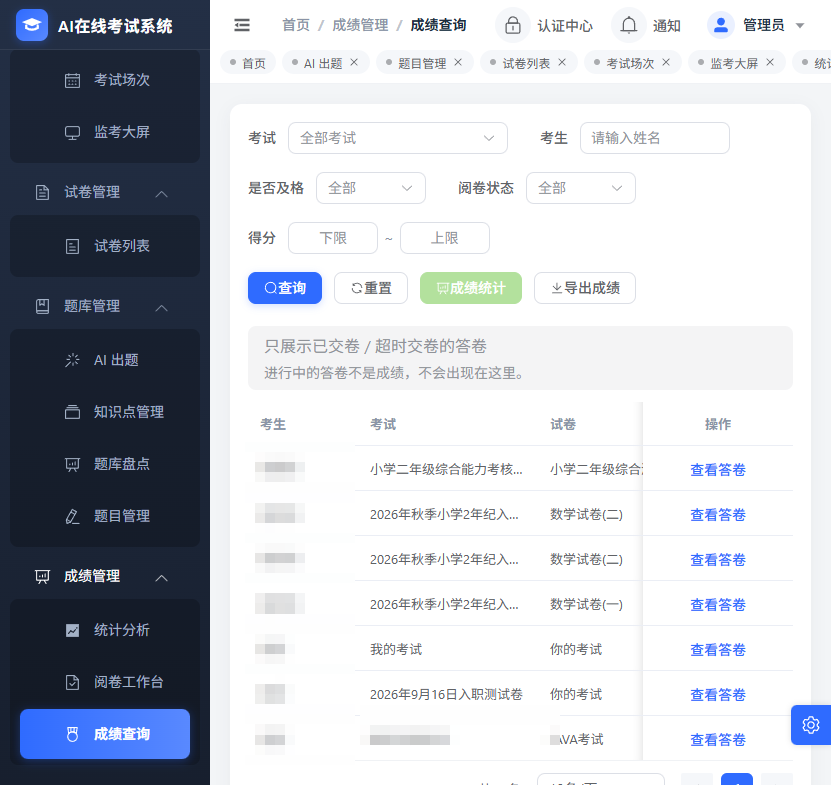
图:成绩查询,只展示已交卷/超时交卷的答卷。
四、人工阅卷
@Override

@Transactional(rollbackFor = Exception.class)

public void manualGrade(ExamManualGradeBO bo) {

    ExamRecordEntity record = getOrThrow(bo.getRecordId(), "答卷不存在,ID=" + bo.getRecordId());

    RecordStatusEnum status = RecordStatusEnum.fromCode(record.getStatus());

    if (status == null || !status.isFinished()) {

        throw new PlatformException("答卷尚未交卷,不能阅卷");

    }

    ExamPaperSnapshot snapshot = parseSnapshot(record.getPaperSnapshot());

    // 建立两个索引,避免循环里反复查库:快照题目 + 答题明细

    Map<Long, ExamSnapshotQuestion> questionIndex = new HashMap<>(

            snapshot.getQuestions() == null ? 16 : snapshot.getQuestions().size());

    if (snapshot.getQuestions() != null) {

        for (ExamSnapshotQuestion question : snapshot.getQuestions()) {

            questionIndex.put(question.getQuestionId(), question);

        }

    }

    Map<Long, ExamAnswerEntity> answerIndex = new HashMap<>();

    for (ExamAnswerEntity answer : examAnswerService.lambdaQuery()

            .eq(ExamAnswerEntity::getRecordId, record.getId())

            .list()) {

        answerIndex.put(answer.getId(), answer);

    }

    for (ExamManualGradeItemBO item : bo.getItems()) {

        ExamAnswerEntity answer = answerIndex.get(item.getAnswerId());

        if (answer == null) {

            throw new PlatformException("答题明细不存在,ID=" + item.getAnswerId());

        }

        ExamSnapshotQuestion question = questionIndex.get(answer.getQuestionId());

        if (question == null || !QuestionTypeEnum.SHORT_ANSWER.getCode()

                .equals(question.getQuestionType())) {

            throw new PlatformException("只有简答题可以人工阅卷");

        }

        BigDecimal maxScore = question.getScore() == null ? BigDecimal.ZERO : question.getScore();

        BigDecimal score = item.getScore() == null ? BigDecimal.ZERO : item.getScore();

        // 得分必须落在 0 ~ 本题满分之间

        if (score.compareTo(BigDecimal.ZERO) < 0 || score.compareTo(maxScore) > 0) {

            throw new PlatformException("第 " + question.getSortNo() + " 题得分须在 0 ~ "

                    + maxScore.stripTrailingZeros().toPlainString() + " 之间");

        }

        answer.setScore(score);

        // 简答题没有「部分正确」概念,按是否给满折算正确与否(用于答对数统计)

        answer.setIsCorrect(score.compareTo(maxScore) >= 0 ? 1 : 0);

        answer.setGraded(1);

        examAnswerService.updateById(answer);

    }

    // 重算:客观题得分 + 已阅主观题得分;仍有未阅题则保持「待阅卷」

    recalculate(record, snapshot);

}
重算逻辑单独抽出来,因为阅卷有两条路径(逐份阅卷、按题批量给分),两条路径必须共用同一段重算:
/**

 * 重算答卷总分 / 及格标志 / 待阅标志。

 *

 * <p>逐份阅卷与按题批量给分共用同一段重算逻辑:两条路径若各写一份,

 * 口径一旦调整(例如「仍有未阅题则保持待阅」)就会出现两处不一致,

 * 而这类不一致会直接表现为成绩数字打架。</p>

 */

private void recalculate(ExamRecordEntity record, ExamPaperSnapshot snapshot) {

    List<ExamAnswerEntity> latest = examAnswerService.lambdaQuery()

            .eq(ExamAnswerEntity::getRecordId, record.getId())

            .list();

    BigDecimal total = latest.stream()

            .map(item -> item.getScore() == null ? BigDecimal.ZERO : item.getScore())

            .reduce(BigDecimal.ZERO, BigDecimal::add);

    boolean stillPending = latest.stream()

            .anyMatch(item -> !Integer.valueOf(1).equals(item.getGraded()));

    BigDecimal passScore = snapshot.getPassScore();

    record.setTotalScore(total);

    record.setPassFlag(passScore != null && total.compareTo(passScore) >= 0 ? 1 : 0);

    record.setManualPending(stillPending ? 1 : 0);

    updateById(record);

}
4.1 交卷不阻塞等阅卷
关键设计:简答题不阻塞交卷。
交卷时 ExamAutoGrader 对简答题原样保留考生文本、得分记 0,并打上 manual 标记。当 manualCount > 0 时,答卷置 manual_pending = 1。
也就是说:考生体验是「交卷即完成」,总分暂时只含客观题。不会出现”交卷后转圈等待老师阅卷”这种糟糕体验。管理端用 manualPending 过滤出待阅卷的答卷。
五、答案可见性策略
这是本篇最需要权衡的地方。考生答完想看标准答案,这很合理。但如果一场考试允许考 2 次(attempt_limit > 1),第一轮结束就看到答案,第二轮直接抄——考试就失去意义了。
/**

 * 是否可向考生公开标准答案与解析。

 *

 * <p>满足任一条件即可公开(此时考生已无重考机会,公开不会泄题):</p>

 * <ol>

 *     <li>考试状态为「已结束」;</li>

 *     <li>当前时间已过考试结束时间(定时任务尚未把状态翻到已结束的窗口期);</li>

 *     <li>该考生在本场考试的作答次数已达到次数上限。</li>

 * </ol>

 */

private boolean canRevealAnswer(ExamExamEntity exam, ExamRecordEntity record) {

    if (exam == null) {

        return false;

    }

    if (ExamStatusEnum.FINISHED.getCode().equals(exam.getStatus())) {

        return true;

    }

    LocalDateTime now = LocalDateTime.now();

    if (exam.getEndTime() != null && !now.isBefore(exam.getEndTime())) {

        return true;

    }

    int attemptLimit = exam.getAttemptLimit() == null ? 1 : exam.getAttemptLimit();

    return countAttempts(record.getExamId(), record.getUserId()) >= attemptLimit;

}
条件 2 看起来冗余,其实是补漏。状态翻转靠定时任务,可能滞后一分钟。如果只判断状态,考生就能在这段窗口里看到答案——而这个窗口刚好紧跟在”考试结束”之后,正是最容易被钻的时候。
未公开时,回顾页仍然展示题干、选项、本人作答、对错、本题得分,只是隐藏标准答案与解析,并给出「考试结束后可查看」的提示。考生能确认自己哪题错了,但看不到正确答案。
5.1 回顾页只读不重算
考生端回顾接口的数据取自答卷里定格的组卷快照与已落库的明细,只读不重算。这样它与管理端的成绩详情同源,判分口径天然一致——不会出现”考生看到的分数和老师看到的不一样”这种最尴尬的情况。
归属校验:不挂 RBAC 权限点,靠「登录拦截 + 答卷归属校验 + 状态校验」三层保证。
六、错题本
错题本以 exam_answer 为驱动表,按 question_id 聚合出「本人答错过的题」,附带答错次数与最近答错时间:
<!-- 只归集已结束考试的错题,保证可以安全下发答案与解析 -->

SELECT ...

FROM exam_answer a

    JOIN exam_record r ON r.id = a.record_id

    JOIN exam_exam e ON e.id = r.exam_id

WHERE a.is_correct = 0

    AND r.user_id = #{userId}

    AND e.end_time <= NOW()

    AND r.status IN (2, 3)          -- 已交卷 / 超时交卷

GROUP BY a.question_id

ORDER BY COUNT(*) DESC, MAX(r.submit_time) DESC
e.end_time <= NOW() 这条约束同时解决了功能需求和安全需求——因为能确定这些考试不会再考,所以可以安全地下发标准答案与解析。
userId 由服务端从登录态注入,前端传入的一律忽略,这是越权防护。
七、统计分析
private ExamScoreStatisticsVO buildStatistics(ExamExamEntity exam, boolean withAnalysis) {

    Long examId = exam.getId();

    ExamPaperEntity paper = examPaperMapper.selectById(exam.getPaperId());

    BigDecimal totalScore = paper == null ? null : paper.getTotalScore();

    BigDecimal passScore = exam.getPassScore() != null

            ? exam.getPassScore() : (paper == null ? null : paper.getPassScore());

    List<ExamRecordEntity> records = lambdaQuery()

            .eq(ExamRecordEntity::getExamId, examId)

            .in(ExamRecordEntity::getStatus,

                    RecordStatusEnum.SUBMITTED.getCode(), RecordStatusEnum.TIMEOUT_SUBMITTED.getCode())

            .list();

    // 含主观题且尚未阅卷的答卷:总分只是「客观题得分」,纳入平均分/分数段会拉低统计

    List<ExamRecordEntity> gradedRecords = records.stream()

            .filter(r -> !Integer.valueOf(1).equals(r.getManualPending()))

            .toList();

    int pendingCount = records.size() - gradedRecords.size();

    int candidateCount = Math.toIntExact(examCandidateService.countByExamId(examId));

    int attendedCount = records.size();

    int passCount = (int) gradedRecords.stream()

            .filter(r -> Integer.valueOf(1).equals(r.getPassFlag()))

            .count();

    vo.setCandidateCount(candidateCount);

    vo.setAttendedCount(attendedCount);

    vo.setAbsentCount(Math.max(candidateCount - attendedCount, 0));

    vo.setPendingCount(pendingCount);

    // 通过率以「实考人数」为分母:把缺考算进去会被缺考人数稀释,不是教学上关心的口径

    vo.setPassRate(percent(passCount, attendedCount));

    // 平均分/最高分/最低分/分数段 全部只用「已判分答卷」

    List<BigDecimal> scores = gradedRecords.stream()

            .map(r -> r.getTotalScore() == null ? BigDecimal.ZERO : r.getTotalScore())

            .toList();

    // ...

    vo.setRanges(buildRanges(scores, totalScore, attendedCount));

    if (!withAnalysis) {

        return vo;

    }

    // 高频错题 / 知识点掌握度:直接按 examId 在库内聚合(不随答卷量膨胀到内存)

    List<ExamWrongQuestionStatVO> wrongStats =

            baseMapper.selectWrongQuestionStats(examId, TOP_WRONG_QUESTION_LIMIT);

    fillWrongQuestionStat(wrongStats);

    vo.setTopWrongQuestions(wrongStats);

    List<ExamCategoryStatVO> categoryStats = baseMapper.selectCategoryStats(examId);

    fillCategoryStat(categoryStats);

    vo.setCategoryStats(categoryStats);

    // 组织对比与平均分/分数段同口径:只用已判分答卷

    vo.setOrgStats(buildOrgStats(gradedRecords));

    return vo;

}
三个口径细节:
① 待阅卷答卷不能拉低统计。如果把它们纳入平均分、最高分、分数段和及格人数,会把这些指标全部拉低——明明考得不错的人,因为简答题还没批,看起来像不及格。所以只用单独的 pendingCount 暴露”还有多少份待阅”。
② 通过率的分母是实考人数,不是参考人数。把缺考算进去会让通过率被稀释,那不是教学上关心的指标。
③ 聚合在库内完成(GROUP BY),不把明细捞进内存。这里踩过一个兼容性坑:GROUP BY 时必须显式列出所有非聚合列,MySQL 默认开启 ONLY_FULL_GROUP_BY,漏列会直接报错。
7.1 监考大屏按名单统计,不按答卷
GET /exam/exam/monitor/{examId}

→ 待考 / 考试中 / 已交卷,三者之和 = 参考人数这里是按参考名单状态聚合,而不是按答卷聚合。因为一个考生可能有多次作答(多份答卷)。按答卷统计会得出「考试中 + 已交卷 > 参考人数」这种让人困惑的数字——监考老师看到会以为系统出 bug 了。
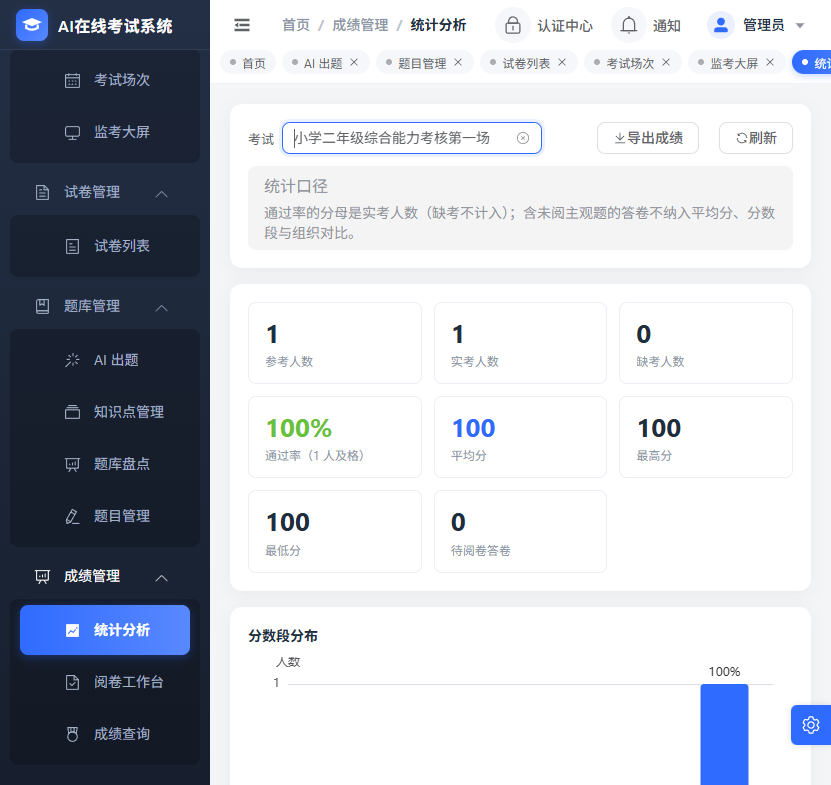
图:统计分析,通过率、平均分、分数段与组织对比。
八、小结
这一篇的核心是三次「不下发 / 不纳入」的判断:
- 答案不在没考完时下发——三个条件判断,其中一条专门补定时任务的滞后窗口
- 待阅卷答卷不纳入成绩统计——否则会把平均分、及格率全部拉低
- 回顾页不重算、监控不按答卷统计——同源数据和正确口径比”实时计算”更重要
以及一条贯穿全篇的原则:判分口径必须单点产出。题库保存、自动判分、人工重算三处归一化逻辑一旦分叉,就会出现数字打架,而这类问题极难排查。
下一篇讲 AI 能力怎么嵌进来,以及成本怎么控住。