
 AI项目博客
「从零搭建智能体与知识库」教程系列第 1 篇。目标:30 分钟内跑通「上传文档 → 检索 → 基于资料回答」。环境:Windows 10/11、Cherry Studio 1.x、硅基流动 API。
结论:这套组合不需要本地显卡。对话模型和 Embedding 模型都走硅基流动,Cherry Studio 只负责客户端、知识库和检索。代价是按 token 计费,资料会上传到云端。
零、准备清单
- 硅基流动账号:手机号注册,地址
https://siliconflow.cn/zh-cn/models; - Cherry Studio 客户端:
https://cherry-ai.com/,GitHub 下载慢时用官网的国内镜像或离线包; - 一份测试文档:10–50 页、带文字层的 PDF 或 Word,不要用扫描件;
- 费用:新账号有赠送额度,具体数额以控制台为准;Embedding 很便宜,对话按模型单价计费。
一、注册硅基流动,创建 API Key
- 打开
https://siliconflow.cn/zh-cn/models,用手机号注册并登录。 - 进入控制台,左侧找「API 密钥」,点「新建 API 密钥」,命名
cherry-kb。 - 复制密钥并保存到密码管理器。密钥通常只完整显示一次,不要写进代码、截图或仓库。
- 在「账户充值」页确认余额和实名认证状态;未实名可能无法调用部分模型。
先在终端验证密钥可用,避免后面把 401 误判成 Cherry Studio 的问题。下面命令在 Git Bash 或 WSL 中执行;Windows PowerShell 要把 curl 写成 curl.exe,变量写成 $env:SILICONFLOW_API_KEY:
curl -s https://api.siliconflow.cn/v1/models \
  -H "Authorization: Bearer $SILICONFLOW_API_KEY" | head -c 300
返回一段包含 data 和模型 ID 的 JSON 就说明密钥有效;返回 401 或 invalid api key,重新复制,注意不要带前后空格。
二、安装 Cherry Studio,接入模型
- 从官网下载 Windows 安装包,双击安装。安装过程没有额外选项。
- 打开 Cherry Studio,点左下角「设置」→「模型服务」→「硅基流动」。
- 把 API Key 粘贴到「API 密钥」,点「检查」。连接成功后,下方会出现模型列表。
- 添加对话模型:搜索
deepseek-ai/DeepSeek-V3,点右侧「+」加入。日常问答用它,速度比 R1 快。 - 添加嵌入模型:搜索
BAAI/bge-m3,加入。知识库的向量化必须用嵌入模型,不能选对话模型。
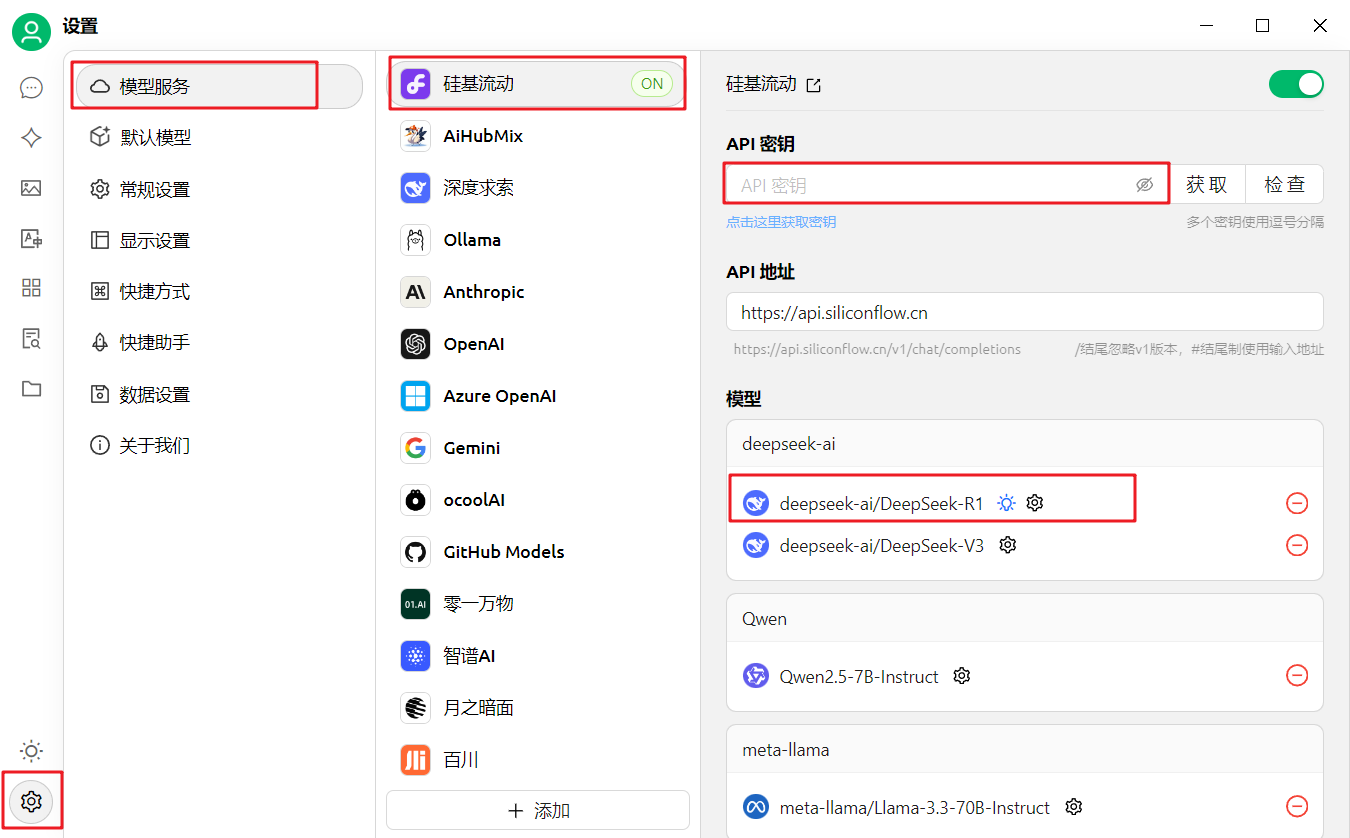
图 1:设置 → 模型服务 → 硅基流动,填 API 密钥后点「检查」。
验收:回到对话页,顶部模型选择器里能看到 DeepSeek-V3;发一句「你好」,2–5 秒内正常回复。
常见错误:模型列表为空,多半是 API Key 无效或账户未实名;对话报 404 model not found,是模型 ID 写错,必须用列表里的完整 ID,不能只写 deepseek-v3。
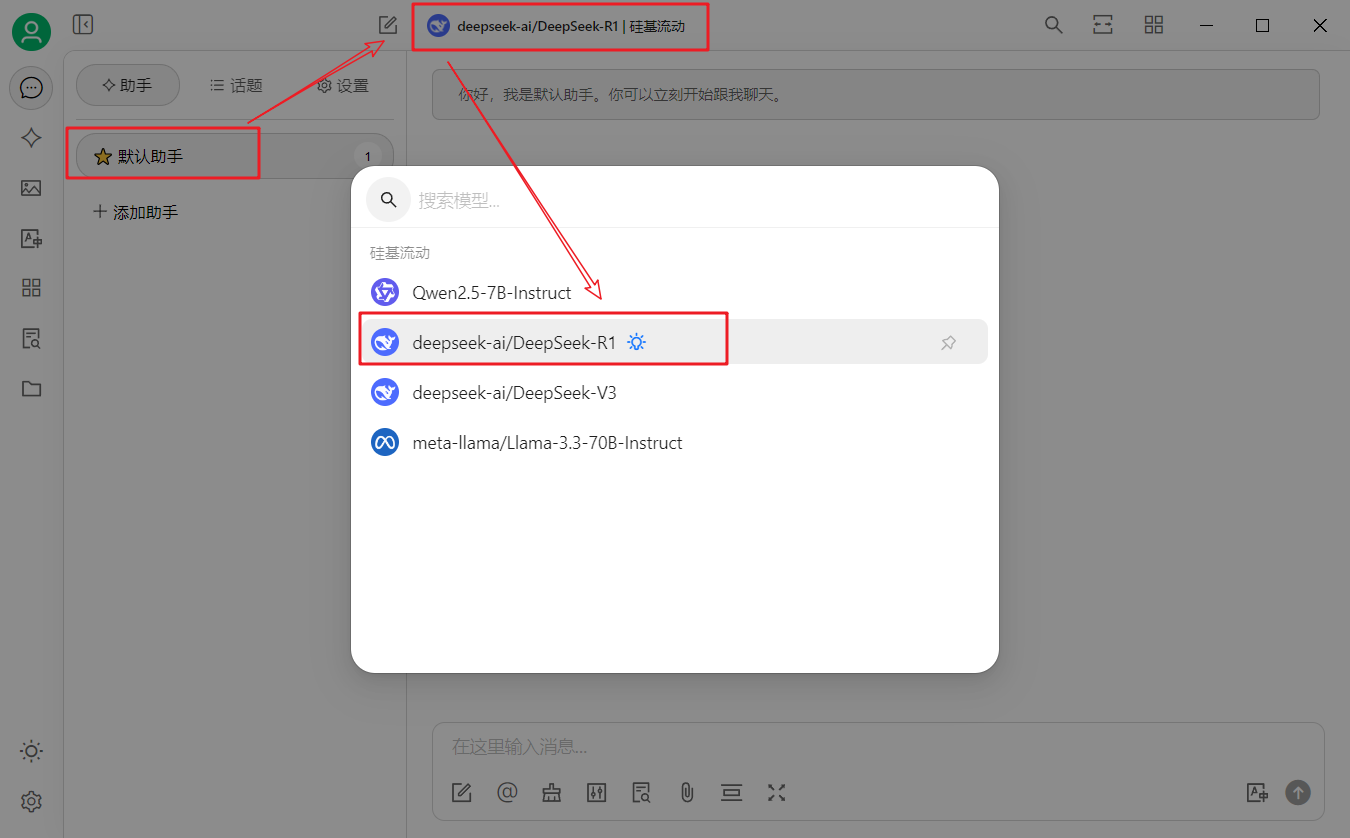
图 2:对话选 DeepSeek-V3;建知识库要另选嵌入模型 bge-m3。
三、建知识库
- 左侧「知识库」→「新建知识库」,命名
kb-test。 - 嵌入模型选
BAAI/bge-m3。建库后不要更换嵌入模型:不同模型的向量维度不同,换了会导致检索失败,只能重建库。 - 进入知识库,点「添加文件」。支持 PDF、Word、Markdown、TXT,也支持文件夹、网页链接和大段文本。
- 上传测试文档,等待状态从「解析中」变成「已完成」。50 页以内的文档通常 1–3 分钟。
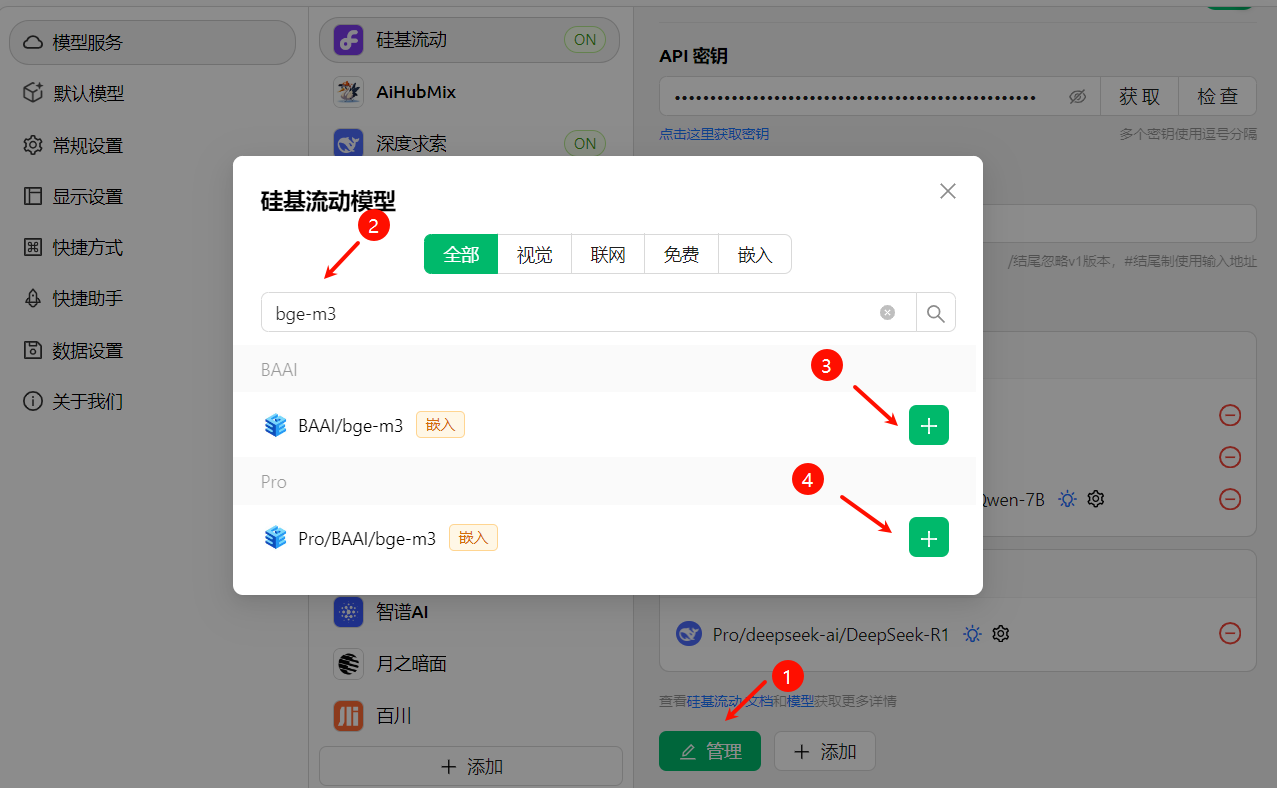
图 3:添加嵌入模型时选 BAAI/bge-m3;建库后不要再换。
验收:知识库列表里文档状态为「已完成」,条目数大于 0;点进文档能看到解析出的文本片段,而不是空白。
如果解析结果是空白或乱码,说明 PDF 是扫描件、没有文字层。先做 OCR,或把文档转成 Markdown 再上传,否则后面一定检索不到。
四、先验收检索,再验收问答
很多人上传完直接提问,答得不好就怪模型。先单独看检索:
- 打开知识库,点「搜索」。
- 输入一个只有文档里才有答案的问题,例如「报销标准是多少」。
- 看返回的片段和相似度分数。第一条应该是答案所在段落,分数明显高于无关段落。
如果 Top 3 里没有答案段落,先调切片和文档格式,不要继续调提示词。检索没拿到正确内容,模型只能编。
五、基于知识库问答
- 新建对话,模型选
DeepSeek-V3。 - 在输入框上方点「知识库」,选中
kb-test。 - 问三类问题做验收:
- 文档里明确写了的:回答应包含资料内容并给出来源;
- 文档里没有的:应回答「资料里没有」,而不是编;
- 跨章节的:看检索能否召回多段,答案是否完整。
- 在助手设置里加一条约束:「只依据知识库内容回答;没有依据就明确说资料里没有;引用时标注来源片段。」
验收标准:三个问题里,第一类答对且引用,第二类拒答,第三类至少召回两段相关资料。只满足第一类,说明检索或提示词还不够。
六、调优的四个旋钮
| 旋钮 | 怎么调 | 现象 |
|---|---|---|
| 切片 | 结构复杂的文档先转 Markdown,按标题层级切,相邻块留 10%–20% 重叠 | 切太碎丢上下文,切太大稀释相似度 |
| Top-K | 从 3 开始,最多加到 8–10 | 太小漏答案,太大噪声进 prompt |
| 阈值 | 相似度低于阈值的内容不进 prompt | 太低会拿无关片段硬答 |
| 提示词 | 明确「只依据资料」「没有就说没有」「给出引用」 | 不约束就会用模型自身知识补全 |
还有一个前端旋钮:对话模型和 Embedding 模型分开选。换对话模型不用重建知识库;换 Embedding 模型必须重建。
七、常见报错与处置
| 现象 | 原因 | 处置 |
|---|---|---|
| 401 Unauthorized | Key 复制不全、带空格、用错服务商 | 重新复制;确认 Base URL 是 https://api.siliconflow.cn/v1 |
| 404 model not found | 模型 ID 写错或未上架 | 用控制台模型列表里的完整 ID |
| 知识库检索为空 | 扫描件无文字层、嵌入模型未配置 | OCR 或转 Markdown 后重传;确认建库时选了 bge-m3 |
| 回答不引用资料 | 对话时没选中知识库,或提示词没约束 | 检查输入框上方的知识库开关;补「只依据资料」约束 |
| 换模型后检索报错 | Embedding 维度不一致 | 新建知识库并重新上传,不要在原库上换模型 |
| 429 或余额不足 | 赠送额度用完、并发限流 | 充值;降低并发或换更便宜的模型 |
八、边界
这套方案适合个人和小团队快速验证:装好就能用,不需要服务器,也不需要显卡。它不适合两类场景:资料不能出内网,以及需要多人权限、审计和 API 集成的企业环境。前者换本地模型,后者看下一篇 Dify。








