AI项目博客
「企业级大模型私有化部署」系列共 4 篇:场景与拓扑、Dify、Ollama、Xinference。这是第 1 篇。
结论:私有化部署不是「装一个 Dify」就结束了。它是一条从应用平台到模型服务的链路:Dify 负责应用,Ollama 负责大语言模型,Xinference 负责 Embedding 与 Rerank,三台服务器各司其职。
一、为什么企业要做私有化部署
企业在使用大模型时,第一约束是数据安全。把制度、客户资料、代码、合同发给公有模型,等于把数据交给了外部服务。私有化部署要把大语言模型、嵌入模型、重排序模型甚至多模态模型都放到自己可控的环境里。
这里有三类模型,各自解决不同问题:
- 大语言模型(LLM):对话、推理、生成;
- 嵌入模型(Embedding):把文本变成向量,用于检索;
- 重排序模型(Rerank):对初步召回的候选片段做精排,提高相关性;
- 多模态模型:图片、语音等非文本输入,按业务需要再接入。
私有化不是把模型下载下来就行,还要有应用平台把它们串起来。Dify 就是这一层:它负责知识库、工作流、Agent,以及模型供应商的管理。
二、整体部署方案
这套方案用三台服务器:
- 腾讯云 CVM:4 核 8GB,装 Docker,部署 Dify,对外统一提供大模型服务,比如 RAG、智能体 Agent;
- GPU 服务器 A:AutoDL RTX 4090,装 Ollama,管理大语言模型;
- GPU 服务器 B:AutoDL RTX 4090,装 Xinference,管理 Embedding 和 Rerank。
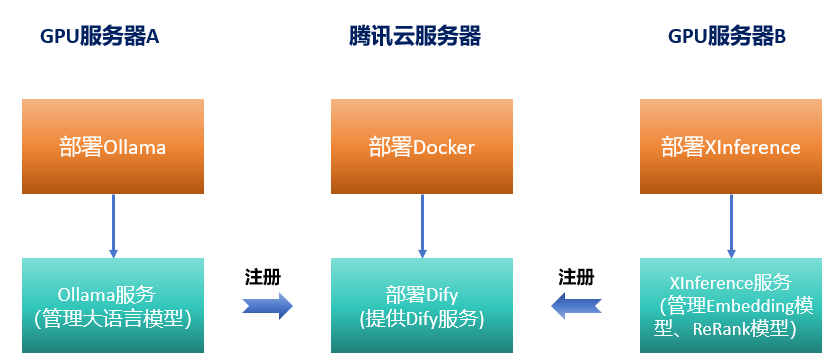
图 1:Dify 管应用,Ollama 管大语言模型,Xinference 管嵌入与重排。
整体思路是:主服务器用 Docker 部署 Dify,对外提供应用;GPU 服务器分别部署 Ollama 和 Xinference,提供模型服务;最后在 Dify 里把模型注册进来。课程的三条主线也是顺着这条链路展开:Dify 私有化 → 大语言模型部署 → 嵌入与重排序模型部署。
三、四个常见问题
问题 1:为什么 Ollama、Xinference 不装 Docker?
可以装,但 Docker 默认使用 CPU,模型推理吃不到 GPU。要解决有两个方案:
- 方案 1:Ollama、Xinference 不装在 Docker 里,直接装在 GPU 宿主机上;
- 方案 2:装在 Docker 里,但额外安装支持 GPU 调用的组件,比如 NVIDIA Container Toolkit,并配置 runtime。
这套方案选方案 1:只把 Dify 装在 Docker 里,Ollama 和 Xinference 直接装在 GPU 服务器上,少一层依赖,出问题也好排查。
问题 2:为什么不在 Ollama 里装嵌入和重排序模型?
Ollama 专注于简化大语言模型的本地部署和管理,对 Embedding 的直接支持相对有限,可用的模型也少;Rerank 模型更少,有的甚至没有。所以嵌入和重排序交给 Xinference。
问题 3:Xinference 是什么?
Xinference 是一个功能更全面的模型服务框架,不仅支持大语言模型,还对嵌入模型和重排序模型提供广泛且灵活的支持;它自带 Web UI,也支持分布式推理。适合把多类模型放在一台 GPU 服务器上统一管理。
问题 4:为什么要多服务器部署?
把 Ollama、Xinference 和 Dify 装在同一台机器上也能跑,但分离部署有三个好处:
- 分散计算压力:推理对 GPU 消耗大,模型分到不同服务器,避免单机资源瓶颈;
- 提高可扩展性:某个模型调用量上来,可以单独给那台机器加 GPU,不用动 Dify;
- 演示分布式模型管理:Dify 可以同时管理部署在不同服务器上的 Ollama 和 Xinference 服务。
四、应用场景 1:RAG
大模型有两个硬伤:
- 知识冻结:训练数据有截止日期,最新信息进不来;
- 幻觉:不知道就编,尤其是企业内部资料、专有文档。
举例:让大模型做一份陌生领域的试卷,没有资料时正确率可能只有 60%;给它检索到的提示和思路后,正确率能到 90%。这就是 RAG 的价值。
RAG 全称 Retrieval-Augmented Generation,检索增强生成。它不改模型参数,而是在回答前先从资料里检索,再把检索结果作为上下文交给模型。
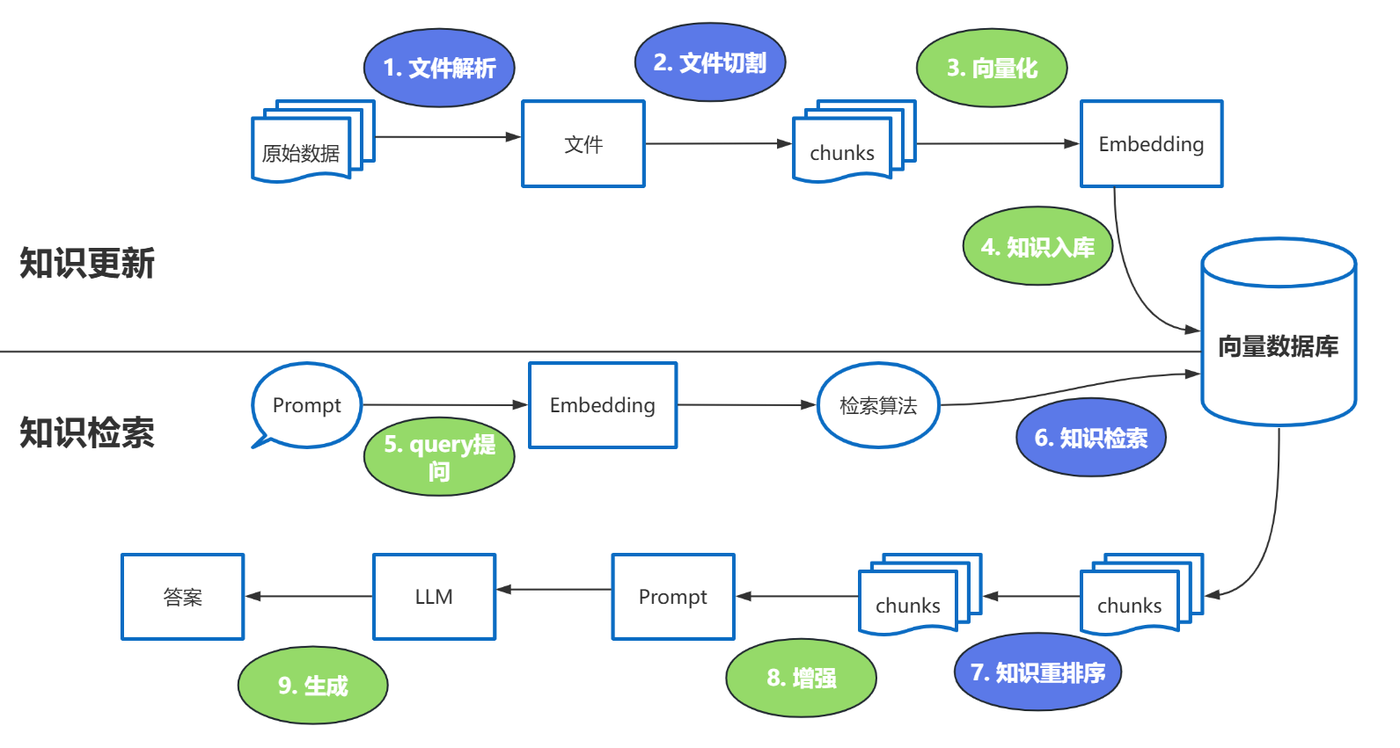
图 2:RAG 的两条链路:知识更新(解析、切割、向量化、入库)和知识检索(召回、重排、增强、生成)。
完整的 15 步可以拆成两条链路:
知识更新:
- 本地文件进入系统;
- 非结构化加载器解析 PDF、Word、TXT 等;
- 得到纯文本;
- 文本切分器切块;
- 得到 Text Chunk;
- Embedding 模型把每个 chunk 变成向量;
- 向量写入向量数据库,建立索引。
知识检索:
- 用户提出问题;
- 问题也做 Embedding;
- 得到 Query Vector;
- 在向量库里做相似度搜索;
- 召回相关 chunk;
- 可选:用 Rerank 模型对候选 chunk 精排;
- 把 chunk 填进 Prompt Template;
- Prompt = Context + User Query;
- 交给 LLM 生成答案。
三个位置用到模型:向量化用 Embedding,重排序用 Rerank,生成答案用 LLM。
Reranker 的价值和代价:它可以把初步召回的 top 20 / top 50 重新排序,提高相关性,减少 LLM 处理无关信息;但它是额外一次模型调用,成本和延迟都会上升。
- 适合:专业知识库、客服系统等对精度和相关性要求高的场景;
- 不适合:响应时间要求高、成本敏感的场景,可以先不开。
五、应用场景 2:Agent
Agent 不是「更聪明的模型」,而是模型 + 循环 + 工具 + 记忆 + 规划。它利用 LLM 的推理决策能力,通过增加规划、记忆和工具调用,构造一个能独立思考、逐步完成目标的智能体。
OpenAI 的 Lilian Weng 在 2023 年 6 月的博客里提出了现代 AI Agent 架构。可以用一个公式概括:
Agent = LLM + Memory + Tools + Planning + Action
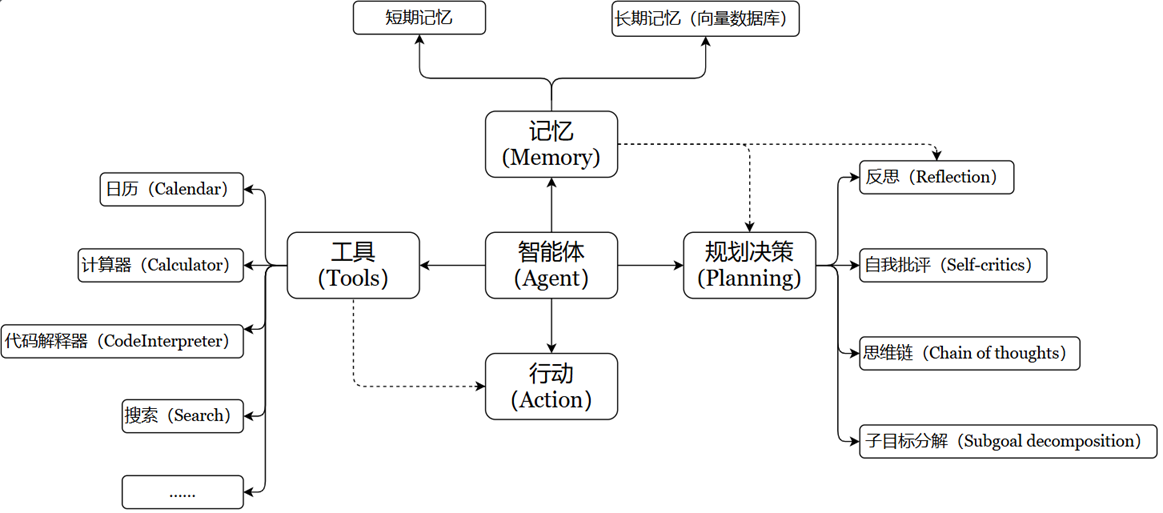
图 3:Agent 的五个要素:LLM、记忆、工具、规划决策、行动。
五个要素展开:
- LLM(大脑):提供推理、规划和知识理解,是决策中枢;
- Memory(记忆):短期存单次对话上下文,受上下文窗口限制;长期存跨任务知识,可以通过微调、知识图谱或向量数据库实现;
- Tools(工具):API、数据库、检索、计算器、代码解释器,扩展能力边界;
- Planning(规划):任务分解、反思、自我批评、思维链、子目标拆解;
- Action(行动):真正执行决策,包括软件接口操作和物理交互。
一个完整的 Agent 流程是:先读取以前的经验和记忆,再规划子目标,选择合适的工具处理问题,输出结果并完成反思。
什么时候用 Agent?一次检索覆盖不了答案、需要多步查询、需要调外部工具时。固定流程用工作流,单轮问答用 RAG;Agent 更贵、更慢,先证明前两种不够用。
六、四篇怎么读
- 第 1 篇:场景与拓扑(本篇);
- 第 2 篇:腾讯云 + Docker 起 Dify;
- 第 3 篇:AutoDL + Ollama 部署 qwen3:4b;
- 第 4 篇:Xinference 部署 Embedding 与 Rerank。
准备:腾讯云账号、AutoDL 账号、两台 4090 实例、SSH 工具(XShell、FinalShell 或系统终端均可)。GPU 按小时计费,不用就关机。
下一篇
先把 Dify 跑起来。下一篇从腾讯云选型开始,装 Docker、拉源码、起容器,最后设置管理员。