AI项目博客
上一篇是「一个厂商一个类」,模型一多就要记一堆参数名。LangChain 1.x 提供了统一入口 init_chat_model():传模型名,它自动选择对应的模型类并初始化实例。
08.1 基本用法
from langchain.chat_models import init_chat_model

model = init_chat_model(
    "provider:model_name",   # 提供商:模型名称
    api_key="your-api-key",  # API 密钥(可选,可从环境变量读取)
    temperature=0.7,         # 温度参数(可选)
    max_tokens=1000,         # 最大 token 数(可选)
    **kwargs                 # 其他模型特定参数
)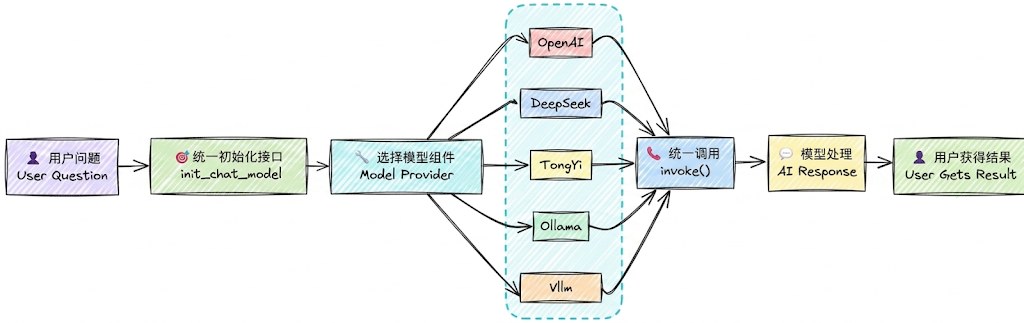
和直接使用 ChatTongyi、ChatOpenAI、ChatDeepSeek 相比,init_chat_model 的优势是:
- 统一接口:不用记每个提供商不同的初始化方式;
- 易于切换:智能体系统里切换模型,只改一个模型字符串;
- 简洁明了:减少样板代码;
- 自动适配:内部根据模型标识自动选择对应的驱动类,例如 ChatOpenAI、ChatDeepSeek。
08.2 三个使用举例
举例 1:调用 DeepSeek 官网的大模型。传入 deepseek-v4-flash 时,init_chat_model 会自动用 ChatDeepSeek 初始化,效果与直接实例化 ChatDeepSeek 一致。
import os
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv

load_dotenv(override=True)

model = init_chat_model(
    model="deepseek:deepseek-v4-flash",
    # model_provider="deepseek",  # 与上面的前缀写法等价
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_BASE_URL"),
)
print(model.invoke("你好,用一句话回答"))
举例 2:调用阿里百炼大模型。dashscope 还没有被纳入 LangChain 的统一注册体系,把 model_provider 设为 openai,走 OpenAI 兼容协议。
DASHSCOPE_BASE_URL=https://dashscope.aliyuncs.com/compatible-mode/v1
DASHSCOPE_API_KEY=<YOUR_API_KEY>
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os
load_dotenv(override=True)
model = init_chat_model(
model="qwen-plus",
model_provider="openai",
api_key=os.getenv("DASHSCOPE_API_KEY"),
base_url=os.getenv("DASHSCOPE_BASE_URL"),
)
print(model.invoke("你好,用一句话回答"))举例 3:调用 CloseAI 中转平台。
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

load_dotenv(override=True)

model = init_chat_model(
    model="deepseek-v4-flash",
    model_provider="openai",
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL"),
)
print(model.invoke("你好,用一句话回答"))
08.3 model_provider 与模型前缀
model_provider 表示模型提供者。支持的 provider 包括:anthropic、anthropic_bedrock、azure_ai、azure_openai、bedrock、bedrock_converse、cohere、deepseek、fireworks、google_anthropic_vertex、google_genai、google_vertexai、groq、huggingface、ibm、mistralai、nvidia、ollama、openai、openrouter、perplexity、together、upstage、xai。
model_provider="openai"会自动加载 langchain-openai,底层调用 ChatOpenAI;model_provider="deepseek"会自动加载 langchain-deepseek,底层调用 ChatDeepSeek;- 像 dashscope 这类尚未纳入统一注册体系的提供商,可以设为
openai,前提是模型服务兼容 OpenAI 规范。
也可以在 model 参数里用冒号前缀指定供应商,例如 deepseek:deepseek-v4-flash,与单独写 model_provider 等价。如果两个位置都没有指明供应商,LangChain 会按内置规则自动推断;但并非所有模型都支持推断,例如 qwen-plus 不指定供应商会直接报错。
08.4 常用初始化参数
Model Class 和 init_chat_model 共用这批参数:
| 参数 | 类型 | 说明 | 默认值 |
|---|---|---|---|
| model | str | 使用的特定提供商的模型名称(必需),例如 openai:gpt-4o、groq:gemma2-9b-it | 无 |
| model_provider | str | 模型提供商名称 | 无 |
| api_key | str | API 密钥;不提供时从环境变量读取,例如 DEEPSEEK_API_KEY | None |
| base_url | str | 大模型供应商 API 请求地址 | None |
| temperature | float | 控制输出随机性,范围 0.0–2.0,越高越随机 | 0.7 |
| max_tokens | int | 限制模型输出的最大 token 数量 | None |
| timeout | float | 超时时间(秒),超时未响应会取消请求 | None |
| max_retries | int | 请求失败(网络问题、速率限制)时的最大重试次数 | 6 |
DeepSeek 模型可以通过 ChatDeepSeek、ChatOpenAI、init_chat_model 三种方式创建;百炼平台的 DeepSeek 可以用 ChatTongyi、ChatOpenAI、init_chat_model;OpenRouter 平台可以用 ChatOpenRouter、ChatOpenAI、init_chat_model;CloseAI 平台则只有 ChatOpenAI 和 init_chat_model 两种。
08.4.1 temperature 怎么选
temperature 控制输出的随机性:
- 0.0–0.3:需要一致性、准确性的任务,例如数学计算、数据提取、分类、代码生成;
- 0.5–0.7:平衡创造性和一致性,例如聊天、问答;
- 0.8–1.5:创造性任务,例如写作、头脑风暴;
- 1.5–2.0:高度创造性,例如诗歌、故事创作。
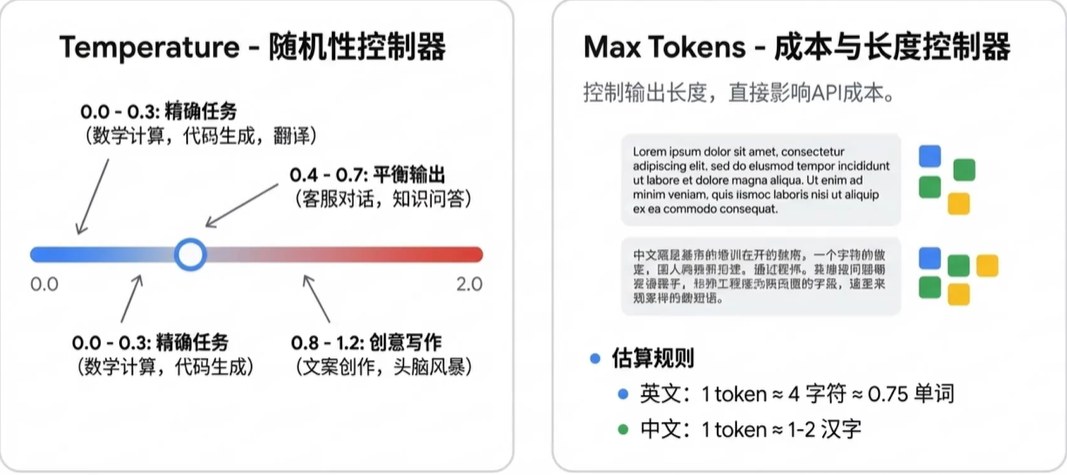
实测对比:把 temperature 设为 0,模型始终选择概率最高的 Token,连续三次「写一首描述春天的七言绝句」,输出几乎一致;改成 1.5 后,三次的意象和用词明显不同。结构化提取场景同理,temperature=0 时返回的 JSON 字段更稳定,不会随意发挥。
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

load_dotenv(override=True)

model = init_chat_model(
    model="deepseek-v3.2",
    model_provider="openai",
    temperature=0,
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL"),
)

response = model.invoke(
    "张三,男,30岁,拥有8年编程开发经验,目前在某互联网大厂担任技术专家。"
    "帮我从上文中提取数据,返回JSON格式"
)
print(response.content)
返回结果可以直接解析:
{
    "name": "张三",
    "gender": "男",
    "age": 30,
    "programming_experience_years": 8,
    "current_position": "技术专家",
    "current_company_type": "互联网大厂"
}
08.4.2 Token 是什么
大模型通过分词器(Tokenizer)把文本拆成最小语义单元 token,相当于自然语言中的词或字。不同模型采用不同的分词算法(如 BPE、WordPiece),同一段文本在不同模型中的 Token 数量可能不同。
大语言模型通常也以 token 数量作为计量或收费依据。换算经验:1 个中文 Token 约等于 1–1.8 个汉字,1 个英文 Token 约等于 3–4 个字符。可视化工具可以用 OpenAI Tokenizer(https://platform.openai.com/tokenizer)或百度智能云 Tokenizer(https://console.bce.baidu.com/support/#/tokenizer)。
把 max_tokens 设为 15,再问一个需要长回答的问题,可以直接看到截断:
model = init_chat_model(
    model="gpt-5.4-mini",
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL"),
    max_tokens=15,
)
response = model.invoke("请用中文详细介绍什么是AI")
print(response)
# content='当然可以。下面我用中文尽量系统、通'
# response_metadata={'finish_reason': 'length', ...}
# usage_metadata={'input_tokens': 14, 'output_tokens': 15, 'total_tokens': 29}
finish_reason 变成 length,说明不是模型不想说完,而是输出额度用完了。
08.5 小结
新项目统一用 init_chat_model:模型名加可选 provider,密钥走环境变量。常用参数记住 model、temperature、max_tokens、timeout、max_retries 五个就够,其余按需查文档。
下一篇:LangChain 1.2 入门(九):Ollama 本地模型部署与调用;上一篇:模型初始化——专用模型库。
本文根据公开课程课件整理,并结合 LangChain 官方文档核对与补充。