AI项目博客
前几篇都是调用云端 API。还有一个角度是「模型放在哪里」:本地部署。LangChain 支持使用 Ollama、vLLM 等框架启动的本地大模型,这里以 Ollama 为例。
09.1 Ollama 是什么
Ollama 是 GitHub 上的开源项目,定位是「本地运行大模型的集成框架」:把 Qwen、DeepSeek 等主流模型的下载、启动和本地推理自动化。官方地址:https://ollama.com。
09.2 安装 Ollama
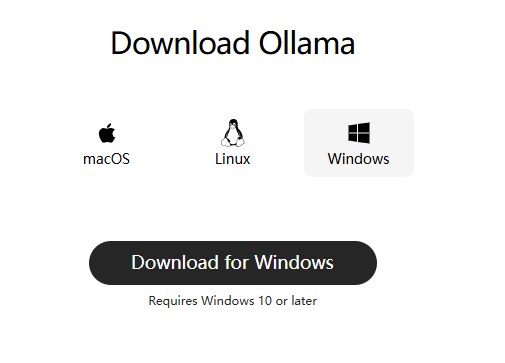
Ollama 支持跨平台部署,兼容 macOS、Linux 和 Windows,安装过程都设计得比较简单。访问 https://ollama.com/download 下载对应系统的安装文件。
Linux 一键安装:
curl -fsSL https://ollama.com/install.sh | sh这条命令会从官网读取 install.sh 并立即交给 sh 执行,过程中完成:检查服务器基础环境(系统版本等)、下载 Ollama 二进制文件、配置系统服务(创建用户和用户组、写入配置)、启动 Ollama 服务。
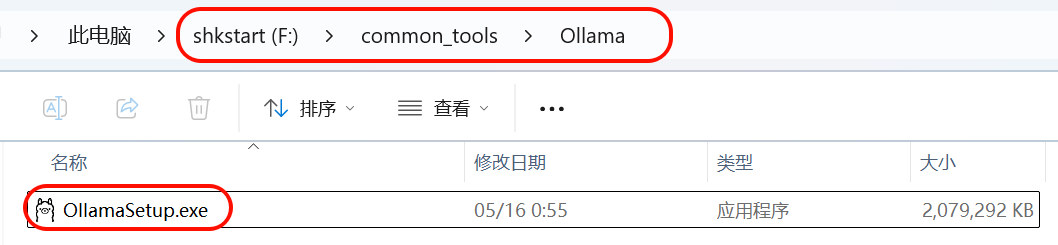
Windows 安装:可以手动指定安装目录。先在目标路径下创建文件夹,例如 F:\common_tools\Ollama,把安装包放进去:
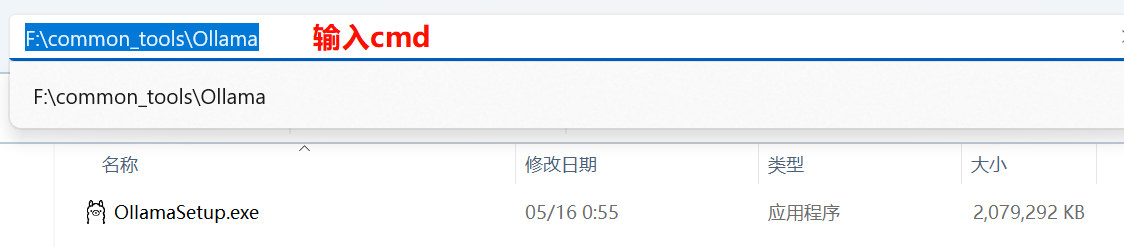
在文件路径栏输入 cmd 回车,会自动在当前目录打开命令行:
然后执行安装命令,/DIR= 后面是刚才创建的目录:
OllamaSetup.exe /DIR=F:\common_tools\Ollama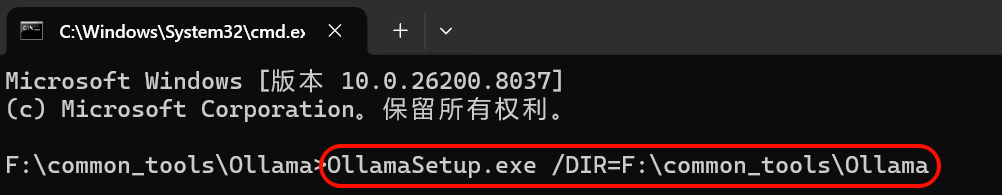
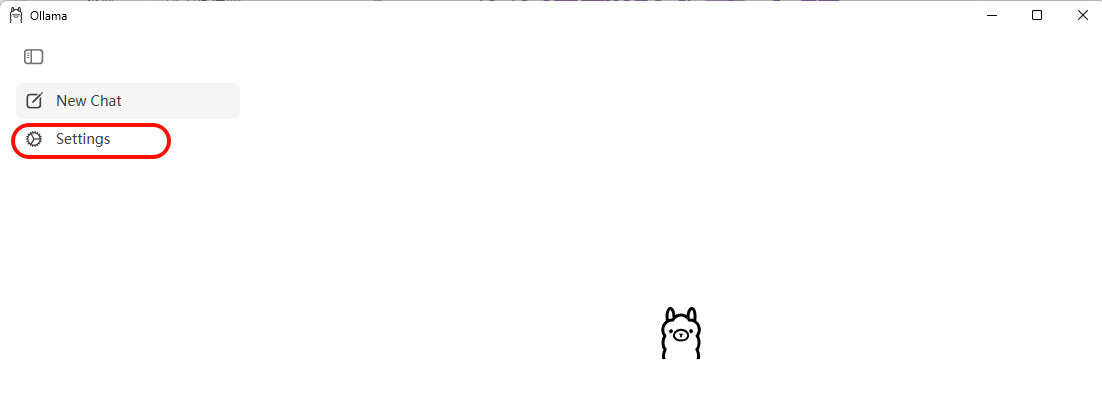
点击 install 后,Ollama 的安装路径就会变成指定目录。安装完成后可以从开始菜单或安装目录启动,主界面只有 New Chat 和 Settings 两个入口。
09.3 下载模型
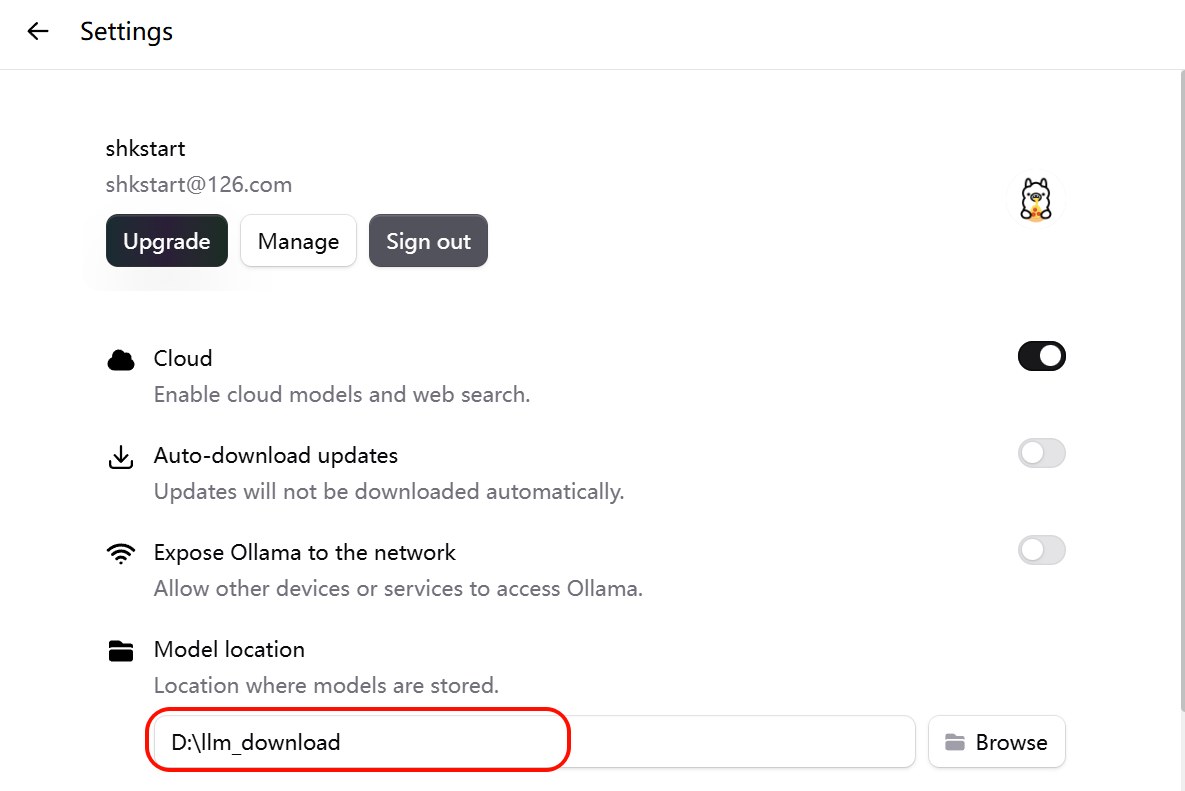
模型动辄几个 G,建议先把存储目录挪到空间充足的数据盘。在 Settings 里找到 Model location,指定本地目录,例如 D:\llm_download;也可以通过 OLLAMA_MODELS 环境变量指定。
下载方式有两种:
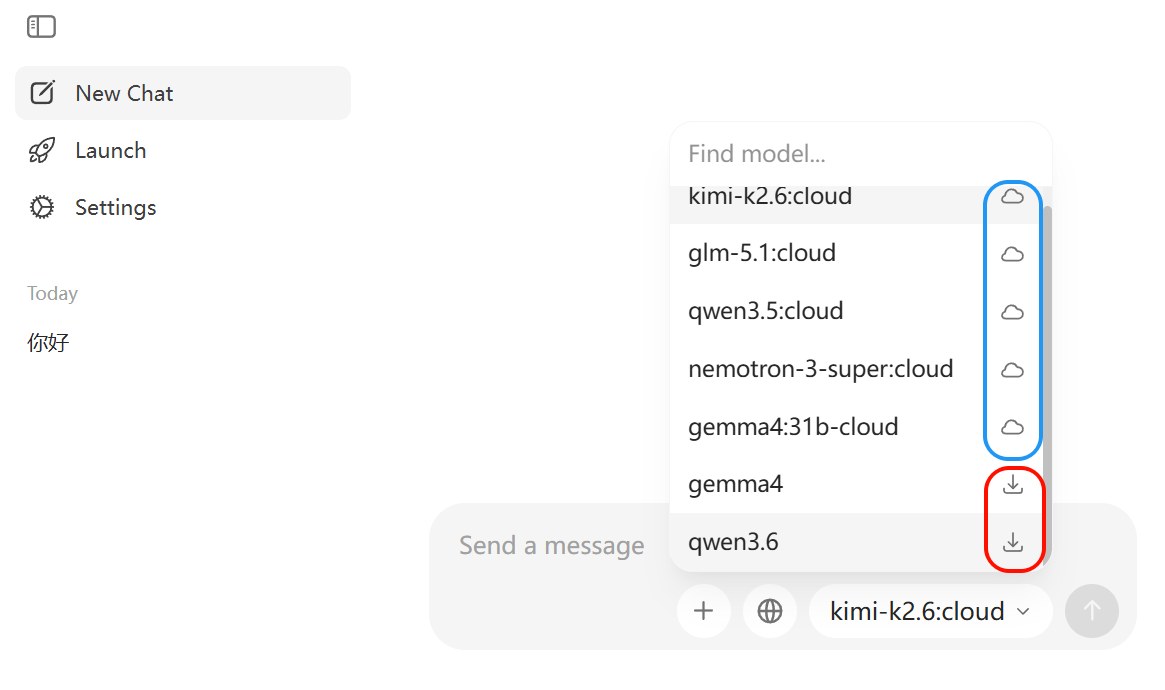
- 图形界面:在模型列表中直接搜索并下载。带云朵标记的在线模型需要在 Ollama 平台付费使用,本地模型可以直接下载。
- 命令行:访问 https://ollama.com/search 查看支持的模型,用
ollama run下载并运行。
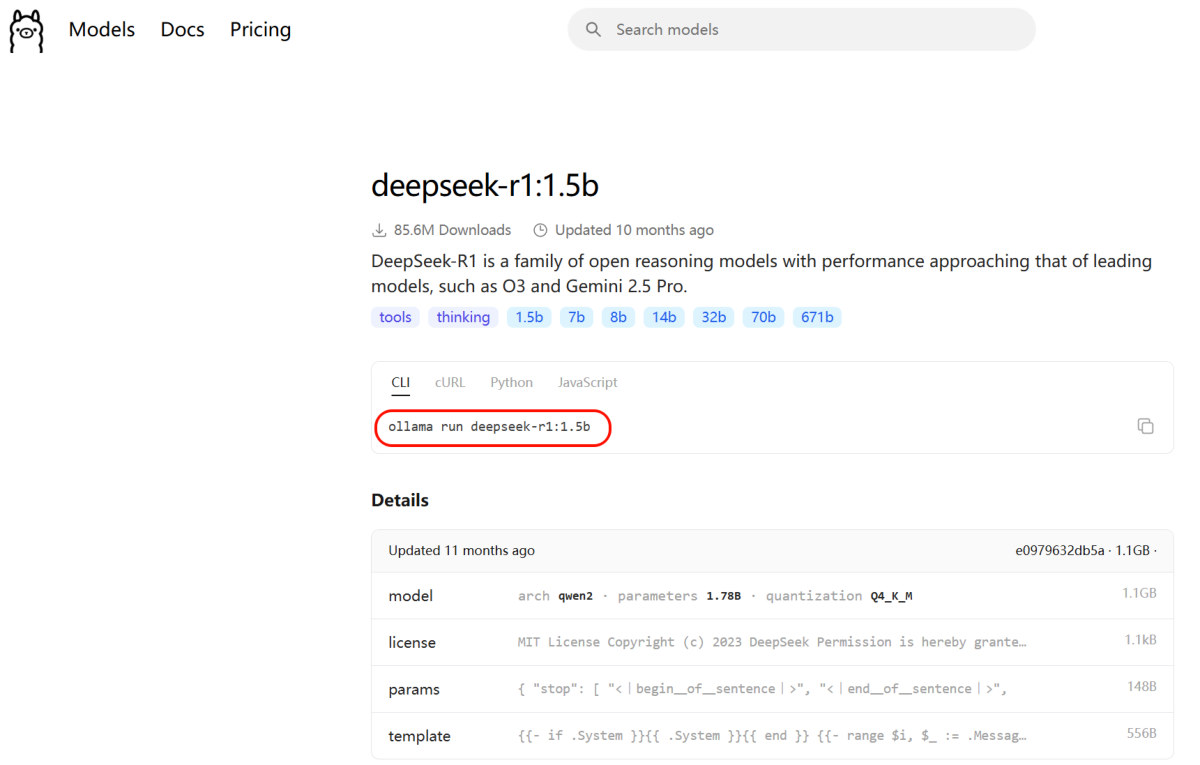
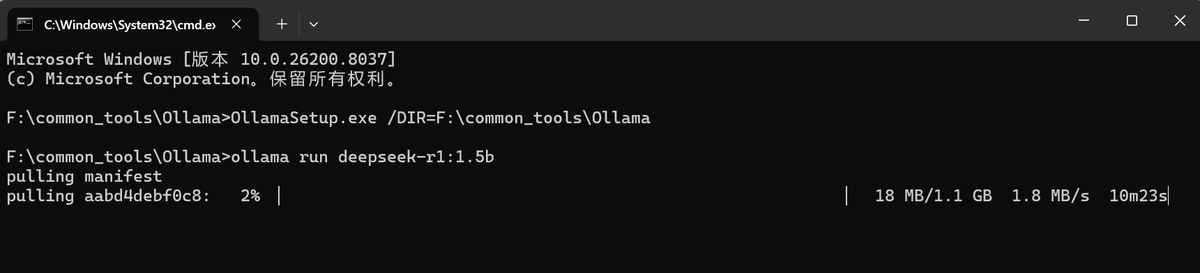
例如运行 deepseek-r1:1.5b:
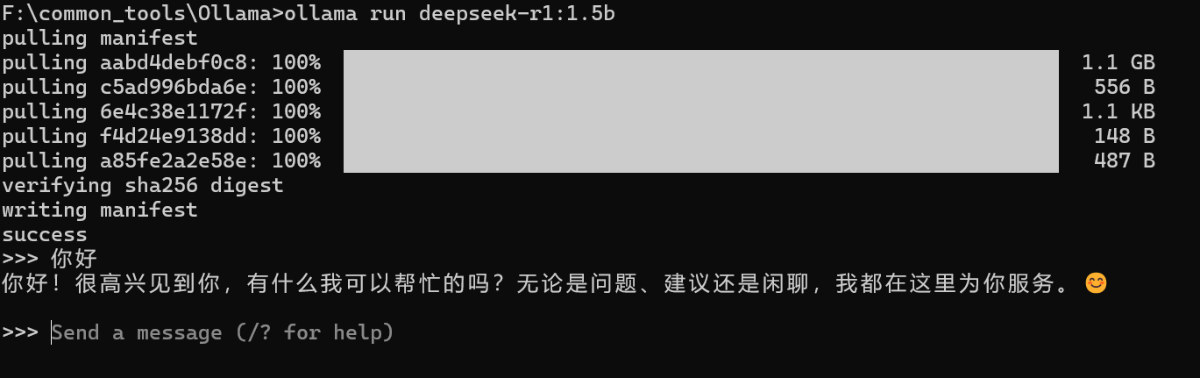
ollama run deepseek-r1:1.5b在模型页面可以看到模型的下载量、更新时间、参数规模、量化方式和体积。1.5b 版本的模型体积约 1.1 GB。
第一次执行会先拉取 manifest 和各层文件,终端显示下载进度:
下载完成后会自动进入交互模式,可以直接对话;输入 /? 查看帮助,Ctrl+D 退出。
常用命令:
| 命令 | 说明 |
|---|---|
| ollama pull llama3 | 下载指定模型 |
| ollama run llama3 | 启动并进入该模型的交互对话 |
| ollama list | 列出本机已下载的所有模型 |
| ollama rm llama3 | 删除不再需要的模型,释放磁盘 |
| ollama cp llama3 my-llama3 | 本地复制或重命名模型 |
| ollama show llama3 | 查看模型参数、大小等详细信息 |
| ollama create my-model -f Modelfile | 用自定义 Modelfile 构建新模型 |
| ollama serve | 启动后台服务,供 API 调用 |
| ollama ps | 查看当前正在运行的模型进程 |
| ollama stop llama3 | 停止正在运行的模型 |
| ollama –version | 查看安装的 Ollama 版本 |
09.4 LangChain 调用本地模型
先安装依赖:
pip install -qU langchain-ollama
pip install -U ollama
方式 1:ChatOllama。Ollama 默认监听 11434 端口,本机调用可以省略 base_url,或写 http://localhost:11434;连接局域网另一台机器时改成对应 IP。
from langchain_ollama import ChatOllama

ollama_llm = ChatOllama(
    model="deepseek-r1:1.5b",
    base_url="http://192.168.1.106:11434",  # 本机可省略
)
question = "你好,请你介绍一下你自己。"
result = ollama_llm.invoke(question)
print(result)
方式 2:init_chat_model。把 provider 指成 ollama 即可。
from langchain.chat_models import init_chat_model

ollama_llm = init_chat_model(
    model="deepseek-r1:1.5b",
    model_provider="ollama",
    # base_url="http://192.168.1.106:11434",
)
question = "你好,请你介绍一下你自己。"
result = ollama_llm.invoke(question)
print(result)
返回的 AIMessage 除了 content,还带有 Ollama 的 response_metadata:total_duration、load_duration、prompt_eval_count、eval_count 等本地推理指标,可以直观看到 token 数和耗时。
09.5 小结
本地模型的链路是:安装 Ollama → 设置模型目录 → 拉取模型 → LangChain 用 ChatOllama 或 init_chat_model 连接。它适合离线演示和小模型试验,能力上限取决于本机硬件。
下一篇:LangChain 1.2 入门(十):invoke、stream、batch 与异步调用;上一篇:init_chat_model 统一初始化。
本文根据公开课程课件整理,并结合 LangChain 官方文档核对与补充。