
 AI项目博客
12. 使用 Thread 创建线程
首先我们要明确一个概念:任何一个正在运行的 Python 程序,至少都有一个线程!
1️⃣回顾一下我们之前的代码:
if __name__ == '__main__':
    print('主进程中的代码')
对于上述代码来说:print(‘主进程中的代码’) 确实属于主进程,但更准确地说,是运行在主进程里的主线程中。
2️⃣线程是进程中的执行单位:
- 一个进程里,至少有一个线程(主线程)
- 一个进程里,也可以有多个线程
- 多个线程之间会: 共享进程的内存空间、 但执行顺序由操作系统调度。
3️⃣示例代码:
import os
import time
from threading import get_native_id, Thread, RLock

def speak(lock):
    for index in range(5):
        with lock:
            print(f'我在说话{index}, 进程pid是:{os.getpid()}, 线程编号:{get_native_id()}')
        time.sleep(1)

def study(lock):
    for index in range(5):
        with lock:
            print(f'我在学习{index}, 进程pid是:{os.getpid()}, 线程编号:{get_native_id()}')
        time.sleep(1)

if __name__ == '__main__':
    print(f'-------start------- 进程pid是:{os.getpid()}, 线程编号:{get_native_id()}')
    lock = RLock()
    # Thread 的参数:
    # 🔸group: 默认值为 None(应当始终为 None)。
    # 🔸target: 子线程要执行的可调用对象,默认值为 None。
    # 🔸name: 线程名称,默认为 None。如果设置为 None,Python 会自动分配名字
    # 🔸args: 给 target 传的位置参数(元组)。
    # 🔸kwargs: 给 target 传的关键字参数(字典)。
    # 🔸daemon: 标记线程是否为守护线程,取值为布尔值(默认为 None)。
    # 使用 Thread 创建线程对象
    t1 = Thread(target=speak, args=(lock,))
    t2 = Thread(target=study, args=(lock,))
    # 调用线程对象的 start 方法,会立刻将该线程交由操作系统进行调度。
    t1.start()
    t2.start()
    # 让主线程等 t1和t2 线程执行完毕后,主线程再继续执行。
    t1.join()
    t2.join()
    print('-------end-------')
13. 继承 Thread 创建线程
和继承Process创建进程一样,我们也可以继承Thread创建线程。
import os
import time
from threading import get_native_id, Thread, RLock

class SpeakThread(Thread):
    def __init__(self, lock, **kwargs):
        super().__init__(**kwargs)
        self.lock = lock

    def run(self):
        for index in range(5):
            with self.lock:
                print(f'我在说话{index}, 进程pid是:{os.getpid()}, 线程编号:{get_native_id()}')
            time.sleep(1)

class StudyThread(Thread):
    def __init__(self, lock, **kwargs):
        super().__init__(**kwargs)
        self.lock = lock

    def run(self):
        for index in range(5):
            with self.lock:
                print(f'我在学习{index}, 进程pid是:{os.getpid()}, 线程编号:{get_native_id()}')
            time.sleep(1)

if __name__ == '__main__':
    print(f'-------start------- 进程pid是:{os.getpid()}, 线程编号:{get_native_id()}')
    lock = RLock()
    # 继承 Thread 类创建线程对象
    t1 = SpeakThread(lock)
    t2 = StudyThread(lock)
    # 调用线程对象的 start 方法,会立刻将该线程交由操作系统进行调度。
    t1.start()
    t2.start()
    # 让主线程等 t1和t2 线程执行完毕后,主线程再继续执行。
    t1.join()
    t2.join()
    print('-------end-------')
14. 线程池
线程池的具体语法,以及各个方法的作用,都和进程池一样
1️⃣创建『线程池执行器』、使用 submit 方法提交任务、使用 shutdown 方法等待任务完成。
def work(n, lock):
    with lock:
        print(f'work正在执行任务{n}.........{get_native_id()}')
    time.sleep(1)

if __name__ == '__main__':
    print('---------start-------------')
    # 创建一个线程池执行器
    executor = ThreadPoolExecutor(3)
    # 创建线程锁
    lock = RLock()
    # 使用 submit 方法提交任务(submit 只负责“提交任务”,不会阻塞主线程)
    executor.submit(work, 1, lock)
    executor.submit(work, 2, lock)
    executor.submit(work, 3, lock)
    executor.submit(work, 4, lock)
    executor.submit(work, 5, lock)
    executor.submit(work, 6, lock)
    executor.submit(work, 7, lock)
    # shutdown 的作用:不再接收新的任务。
    # wait=True 的作用:阻塞主线程,等待线程池中所有任务执行完毕。
    executor.shutdown(wait=True)
    print('---------end-------------')
2️⃣获取子线程执行后的返回结果(Future类的实例对象 + result方法)
def work(n, lock):
    with lock:
        print(f'work正在执行任务{n}.........{get_native_id()}')
    time.sleep(1)
    return f'任务{n}的结果'

if __name__ == '__main__':
    print('---------start-------------')
    # 创建一个线程池执行器
    executor = ThreadPoolExecutor(3)
    # 创建线程锁
    lock = RLock()
    # 使用 submit 方法提交任务(submit 只负责“提交任务”,不会阻塞主线程)
    futures = [executor.submit(work, index, lock) for index in range(1, 8)]
    # 阻塞主线程,等待线程池中所有任务执行完毕。
    executor.shutdown(wait=True)
    # 打印结果
    for f in futures:
        print(f.result())
    print('---------end-------------')
3️⃣使用 as_completed:按“完成顺序”获取结果
def work(n, lock):
    with lock:
        print(f'work正在执行任务{n}.........{get_native_id()}')
    if n == 1:
        time.sleep(15)
    elif n == 2:
        time.sleep(10)
    else:
        time.sleep(1)
    return f'任务{n}的结果'

if __name__ == '__main__':
    print('---------start-------------')
    # 创建一个线程池执行器
    executor = ThreadPoolExecutor(3)
    # 创建线程锁
    lock = RLock()
    # 使用 submit 方法提交任务(submit 只负责“提交任务”,不会阻塞主线程)
    futures = [executor.submit(work, index, lock) for index in range(1, 8)]
    # 收集每个线程返回的结果
    result_list = []
    # 将每个线程返回的结果,存入result_list
    for f in as_completed(futures):
        result_list.append(f.result())
    # 阻塞主线程,等待线程池中所有任务执行完毕。
    executor.shutdown(wait=True)
    # 打印最终的结果
    print(result_list)
    print('---------end-------------')
4️⃣使用 add_done_callback 方法,为任务添加完成时的回调函数
def work(n, lock):
    with lock:
        print(f'work正在执行任务{n}.........{get_native_id()}')
    if n == 1:
        time.sleep(15)
    elif n == 2:
        time.sleep(10)
    else:
        time.sleep(1)
    return f'任务{n}的结果'

if __name__ == '__main__':
    print('---------start-------------')
    # 创建一个线程池执行器
    executor = ThreadPoolExecutor(3)
    # 创建线程锁
    lock = RLock()
    # 收集每个线程的执行结果
    result_list = []
    # 定义一个线程执行成功后的回调函数
    def done_func(f):
        result_list.append(f.result())
    # 使用submit提交任务,并指定回调函数
    for index in range(1, 8):
        f = executor.submit(work, index, lock)
        f.add_done_callback(done_func)
    # 阻塞主线程,等待线程池中所有任务执行完毕。
    executor.shutdown(wait=True)
    # 打印最终的结果
    print(result_list)
    print('---------end-------------')
5️⃣使用 map 方法批量提交任务(注意:map方法本身不阻塞,但读取其返回的生成器对象是阻塞的,并且得到结果的顺序,与任务分配的顺序是一致的)
map方法会把这一批任务提交到线程池里执行,它会立刻返回一个生成器,真正的阻塞发生在:生成器取结果时,如 list(result)
def work(n, lock):
    with lock:
        print(f'work正在执行任务{n}.........{get_native_id()}')
    if n == 1:
        time.sleep(15)
    elif n == 2:
        time.sleep(10)
    else:
        time.sleep(1)
    return f'任务{n}的结果'

if __name__ == '__main__':
    print('---------start-------------')
    # 创建一个线程池执行器
    executor = ThreadPoolExecutor(3)
    # 创建线程锁
    lock = RLock()
    # 使用map方法批量提交任务
    result = executor.map(work, [1, 2, 3, 4, 5, 6, 7], [lock]*7)
    # 打印最终的结果
    print(list(result))
    # 阻塞主线程,等待线程池中所有任务执行完毕。
    executor.shutdown(wait=True)
    print('---------end-------------')
6️⃣使用 with:线程池的“自动回收”写法,离开 with 代码块时自动执行 shutdown(wait=True)
def work(n, lock):
    with lock:
        print(f'work正在执行任务{n}.........{get_native_id()}')
    if n == 1:
        time.sleep(15)
    elif n == 2:
        time.sleep(10)
    else:
        time.sleep(1)
    return f'任务{n}的结果'

if __name__ == '__main__':
    print('---------start-------------')
    with ThreadPoolExecutor(3) as executor:
        # 创建线程锁
        lock = RLock()
        # 使用map方法批量提交任务
        result = executor.map(work, [1, 2, 3, 4, 5, 6, 7], [lock]*7)
        # 打印最终的结果
        print(list(result))
    print('---------end-------------')
15. GIL 全局解释器锁
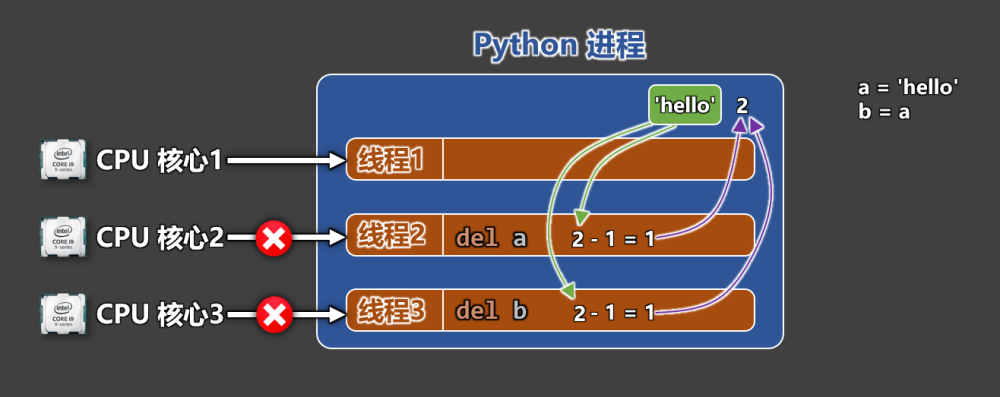
概念: GIL锁是 CPython 解释器中的一把互斥锁。
作用:无论 CPU 有多少个核心,在某一时刻,只允许同一个进程中的一个线程去执行 Python 代码。
结论:CPython 解释器中的多线程模型,本质上是并发,而不是并行!(是快速切换,而不是同时进行)
为何要这样设计?———— 为了确保解释器级别的数据安全。
如果没有 GIL 锁,那么 Python 底层就可能会出现引用计数错误,导致内存“爆炸”。
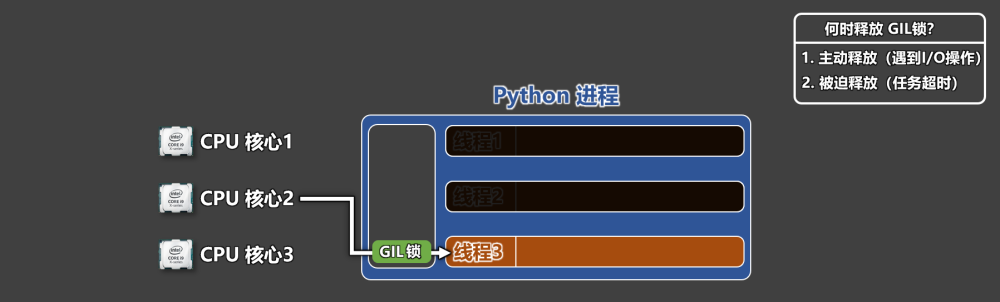
GIl 锁何时会被释放? —— 主动释放(遇到 I/O 操作)、被迫释放(任务超时)
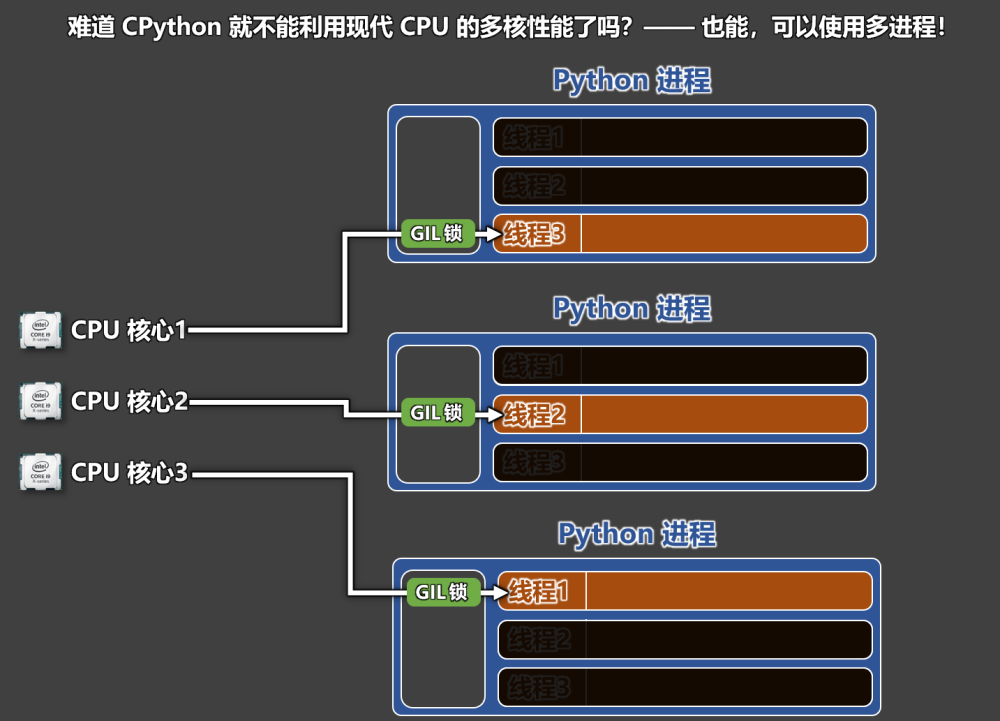
可以使用多进程来发挥多核 CPU 的性能
GIL 对比 lock/Rlock:
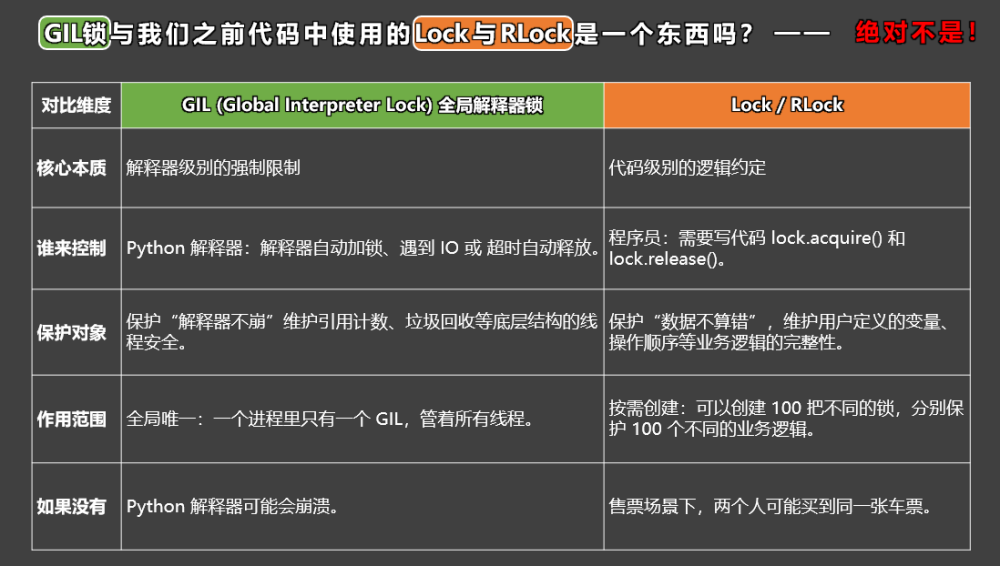
结论:GIL 为了确保 Cpython 解释器级别的数据安全,作为日常编码来说,我们对 GIL 是无感的,但对于 Lock/Rlock 是实际编码中使用较多的,Lock/Rlock是为了确保业务路基的完整,例如:
# GIL锁和编码时使用的 Lock 和 Rlock 不是同一个东西。
# Lock 和 Rlock是业务层面的锁,目标是:让业务逻辑别出错
# Rlock示例1:让打印是完整的

import time
from threading import Thread, RLock,current_thread
def show_info1(lock):
    for index in range(10):
        with lock:
            print('尚', end='')
            print('硅', end='')
            print('谷')

def show_info2(lock):
    for index in range(10):
        with lock:
            print('at', end='')
            print('gui', end='')
            print('gu')

if __name__ == '__main__':
    lock = RLock()
    t1 = Thread(target=show_info1, args=(lock,))
    t2 = Thread(target=show_info2, args=(lock,))
    t1.start()
    t2.start()

# Rlock示例2:不要让两个窗口卖出同一张票
current = 1

def sale(lock):
    global current
    while True:
        with lock:
            if current <= 20:
                print(f'{current_thread().name}出售了第{current}张票!')
                current += 1
            else:
                print('票已售空')
                break
        time.sleep(0.3)

if __name__ == '__main__':
    lock = RLock()
    t1 = Thread(target=sale, name='窗口1', args=(lock,))
    t2 = Thread(target=sale, name='窗口2', args=(lock,))
    t3 = Thread(target=sale, name='窗口3', args=(lock,))
    t1.start()
    t2.start()
    t3.start()
16. 多进程 vs 多线程,该如何选择?
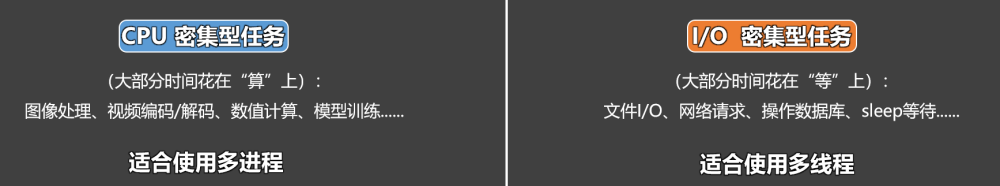
CPU密集型任务,更适合用多进程。
import time
from concurrent.futures import ProcessPoolExecutor, ThreadPoolExecutor

# 准备一个 CPU 密集型任务
def cpu_task(n):
    print(f'任务{n}开始了')
    total = 0
    for i in range(10000000):
        total += i * i
    return total

if __name__ == '_main_':
    print('===== 多进程完成【CPU密集型任务】=====')
    start = time.time()
    #开启四个进程进行计算
    with ProcessPoolExecutor(4) as executor:
        list(executor.map(cpu_task, [1, 2, 3, 4]))
    end = time.time() - start
    print(f'多进程总耗时:{end}秒')

    # print('===== 多线程完成【CPU密集型任务】=====')
    # start = time.time()
    # # 开启四个线程进行计算
    # with ThreadPoolExecutor(max_workers=4) as executor:
    #     results = list(executor.map(cpu_task, [1, 2, 3, 4]))
    # end = time.time() - start
    # print(f'多线程总耗时:{end}秒')
IO密集型任务,更适合用多线程。
import time
from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor

# 拷贝文件
def copy_file(index):
    with open('a.zip', 'rb') as src, open(f'a_副本{index}.zip', 'wb') as dst:
        while True:
            data = src.read(1024 * 1024)  # 每次读 1MB
            if not data:
                break
            dst.write(data)

if __name__ == '__main__':
    # print('===== 使用多进程完成【IO密集型任务】 =====')
    # start = time.time()
    # with ProcessPoolExecutor(4) as executor:
    #     for i in range(4):
    #         executor.submit(copy_file, i)
    # end = time.time() - start
    # print(f'多进程耗时:{end} 秒')

    print('===== 使用多线程完成【IO密集型任务】 =====')
    start = time.time()
    with ThreadPoolExecutor(4) as executor:
        for i in range(4):
            executor.submit(copy_file, i)
    end = time.time() - start
    print(f'多线程耗时:{end} 秒')







