目标:用 Dify 做三个完整案例——聊天助手、会调用工具的旅行 Agent、可引用的刑法知识库,再把温度、Top P、Max Tokens 等参数一次讲清。环境:Dify(云端或自建均可)、qwen3:4b 或同类模型。 结论:Dify 的价值不是「又一个聊天框」,而是把应用、Agent、工作流、知识库放在同一个界面里。三个案例分别对应三种能力:提示词、工具调用、检索增强。 一、先选对应用类型 Dify 是一个低代码、甚至零代码的 L…
「从零搭建智能体与知识库」系列第 4 篇。目标:20 分钟把本地文档导入 ima,基于资料问答并核对参考来源。环境:Windows 或 macOS、ima 客户端、DeepSeek。 结论:ima 的优点是零部署、本地文件直接导入、答案标注参考来源;代价是资料要上传到云端,复杂表格和扫描件的解析一般。适合个人和小团队,不适合不能出内网的资料。 零、准备清单 ima 客户端:https://ima.qq.com/,支持 Windows、m…
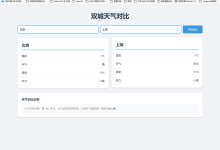
「从零搭建智能体与知识库」教程系列第 3 篇。目标:用 Cline 在 VS Code 里完成两个项目——单文件天气查询、双城天气对比(Flask + 前端)。环境:VS Code、Cline 插件、DeepSeek API、高德天气 API。 结论:Cline 是开发场景的 Agent。它不直接回答问题,而是读文件、改代码、跑命令、看报错再改。用好它的关键不是提示词多长,而是三件事:工作目录要小、验收标准要写清、危险操作必须人工确认。…
「从零搭建智能体与知识库」教程系列第 2 篇。目标:在一个 Dify 实例里搭两个应用——聊天助手和旅行 Agent——再给 Agent 接知识库与搜索工具,最后发布并调 API。环境:Dify Cloud 或自建,模型用硅基流动的 DeepSeek。 结论:Dify 的价值是把「提示词、模型、工具、知识库、发布」放进同一个界面。聊天助手十分钟能上线;Agent 多花一步配工具,但能自己决定查什么。下面按可复现顺序走一遍。 零、准备清单…
「从零搭建智能体与知识库」教程系列第 1 篇。目标:30 分钟内跑通「上传文档 → 检索 → 基于资料回答」。环境:Windows 10/11、Cherry Studio 1.x、硅基流动 API。 结论:这套组合不需要本地显卡。对话模型和 Embedding 模型都走硅基流动,Cherry Studio 只负责客户端、知识库和检索。代价是按 token 计费,资料会上传到云端。 零、准备清单 硅基流动账号:手机号注册,地址 https…
本系列共 9 篇,从空目录搭到可部署的 Python RAG 知识库。这是最后一篇。 问答、Agent 都能跑了,但“能演示”和“能上线”之间还差一段:模型调用要记账,租户要限额度,出问题要能查,服务要能部署。这一篇把这些收尾工作做完。 图:用量统计按场景拆分调用次数、失败与 token,失败调用同样计费。 一、AI 流水:失败也要记 每次调用模型都写一条 kb_ai_invoke_log:场景、模型、token 数、耗时、成功/失败、…
本系列共 9 篇,从空目录搭到可部署的 Python RAG 知识库。这是第 8 篇。 单轮问答是“检索一次,再回答”。但有些问题需要先查一遍、发现不够、换个关键词再查,甚至要读某个切片的完整正文。这一篇用 LangGraph 做一个能自己决定检索几次的 Agent,并让它记住同一个会话的历史。 图:首页功能位,知识问答与深度推理均已启用,Agent 多跳推理是独立入口。 一、什么时候需要 Agent 单轮 RAGAgent 检索次数固…
本系列共 9 篇,从空目录搭到可部署的 Python RAG 知识库。这是第 7 篇。 检索能返回相关片段了,这一篇把它们变成答案。完成后:同步接口能返回带 [1][2] 出处的回答,SSE 接口能逐字输出,刷新会话还能看到历史消息和引用。 图:知识问答,答案逐条标注 [n],引用可点开定位原文。 一、问答的完整顺序 一次问答不是“检索 + 调模型”这么简单,顺序很重要: 检查对话模型是否可用; 先扣配额(拦住再干活,别让用户等十几秒才…
本系列共 9 篇,从空目录搭到可部署的 Python RAG 知识库。这是第 6 篇。 向量有了,现在回答关键问题:用户提问时,怎么在几秒内从成千上万张切片里找到最相关的几段?这一篇讲两条召回路线、RRF 融合,以及为什么召回之后还要回表复核。 图:知识库参数,检索返回条数与相似度阈值是混合检索的两个旋钮。 一、为什么不能只靠向量 向量擅长“意思相近”:用户问“怎么报销”,能找到写着“费用核销流程”的段落。但它对专有名词、错误码、型号不…
本系列共 9 篇,从空目录搭到可部署的 Python RAG 知识库。这是第 5 篇。 切片有了,但还只是一堆文本。这一篇把每张切片变成一串 1024 个数字的向量,存进 PostgreSQL 的 pgvector,并处理失败重试、状态回写和卡死任务。 图:切片管理,每条切片显示字符数、token 估算与向量化状态。 一、Embedding:把“意思”变成数字 调用的是 OpenAI 兼容的 /v1/embeddings 接口,本机 O…

 AI项目博客
 admin
最新评论
干货满满!
江苏省 南京市 · IP 49.91.145.*
我要看文章
重庆市 · IP 116.168.9.*
这个内容实在是太精彩啦
重庆市 · IP 123.147.232.*