AI项目博客
持久化执行是一种技术,其中进程或工作流在关键点保存其进度,允许它暂停并稍后从中断的地方恢复。这在需要人在回路中(human-in-the-loop)的场景中特别有用,用户可以在继续之前检查、验证或修改流程,也适用于可能遇到中断或错误的长时间运行任务(例如,调用 LLM 超时)。通过保留已完成的工作,持久化执行使流程能够恢复而无需重新处理先前的步骤——即使在很长时间延迟之后(例如,一周后)。
Spring AI Alibaba Graph 的内置持久化层为工作流提供了持久化执行,确保每个执行步骤的状态都保存到持久化存储中。此功能保证如果工作流被中断——无论是由于系统故障还是人在回路中的交互——它都可以从最后记录的状态恢复。
提示
如果您在使用 Spring AI Alibaba Graph 时配置了检查点器(checkpointer),则已经启用了持久化执行。您可以在任何时候暂停和恢复工作流,即使在中断或失败之后也是如此。为了充分利用持久化执行,请确保您的工作流设计为确定性和一致性重放,并将任何副作用或非确定性操作包装在节点中。
要在 Spring AI Alibaba Graph 中利用持久化执行,您需要:
- 通过指定检查点器(checkpointer)在工作流中启用持久化,该检查点器将保存工作流进度。
- 在执行工作流时指定线程标识符(thread identifier)。这将跟踪工作流特定实例的执行历史。
- 将任何非确定性操作(例如,随机数生成)或具有副作用的操作(例如,文件写入、API 调用)包装在节点中,以确保在恢复工作流时,这些操作不会在特定运行中重复,而是从持久化层检索它们的结果。有关更多信息,请参阅确定性和一致性重放。
当您恢复工作流运行时,代码不会从执行停止的同一行代码恢复;相反,它将从上次停止的 Node 节点第一行代码开始,从那里继续执行。这意味着工作流将从上次终止的 Node 节点开始继续执行或重放所有步骤,直到达到流程的终止点。
因此,在为持久化执行编写工作流时,您必须将任何非确定性操作(例如,随机数生成)和任何具有副作用的操作(例如,文件写入、API 调用)包装在独立的节点中。
为了确保您的工作流是确定性的并且可以一致地重放,请遵循以下准则:
- 避免重复工作:如果节点包含多个具有副作用的操作(例如,日志记录、文件写入或网络调用),请将每个操作包装在单独的节点中。这确保在恢复工作流时,操作不会重复,而是从持久化层检索它们的结果。
- 封装非确定性操作:将可能产生非确定性结果的任何代码(例如,随机数生成)包装在节点中。这确保在恢复时,工作流遵循记录的精确步骤序列和相同的结果。
- 使用幂等操作:尽可能确保副作用(例如,API 调用、文件写入)是幂等的。这意味着如果在工作流失败后重试操作,它将具有与第一次执行相同的效果。这对于导致数据写入的操作特别重要。如果某个 Node 节点已经启动但未能成功完成,工作流的恢复将重新运行该节点,依靠记录的结果来保持一致性。使用幂等性键或验证现有结果以避免意外重复,确保平稳和可预测的工作流执行。
Spring AI Alibaba Graph 支持不同的持久化策略,允许您根据应用程序的要求平衡性能和数据一致性。
编译时配置
在编译图时,您可以配置持久化策略:
import com.alibaba.cloud.ai.graph.CompileConfig;
import com.alibaba.cloud.ai.graph.CompiledGraph;
import com.alibaba.cloud.ai.graph.checkpoint.config.SaverConfig;
import com.alibaba.cloud.ai.graph.checkpoint.savers.MemorySaver;

SaverConfig saverConfig = SaverConfig.builder()
      .register(new MemorySaver())
      .build();

CompiledGraph graph = stateGraph.compile(
      CompileConfig.builder()
              .saverConfig(saverConfig)
              .build()
);
执行时配置
在执行图时指定配置:
import com.alibaba.cloud.ai.graph.CompiledGraph;
import com.alibaba.cloud.ai.graph.RunnableConfig;

import java.util.Map;
import java.util.UUID;

RunnableConfig config = RunnableConfig.builder()
      .threadId("long-running-task-" + UUID.randomUUID())
      .build();

graph.invoke(inputData, config);
如果节点包含多个操作,您可以将每个操作设计为独立的节点,或者使用适当的模式来确保幂等性。
原始版本
import com.alibaba.cloud.ai.graph.StateGraph;
import com.alibaba.cloud.ai.graph.CompiledGraph;
import com.alibaba.cloud.ai.graph.CompileConfig;
import com.alibaba.cloud.ai.graph.RunnableConfig;
import com.alibaba.cloud.ai.graph.checkpoint.savers.MemorySaver;
import com.alibaba.cloud.ai.graph.checkpoint.config.SaverConfig;
import com.alibaba.cloud.ai.graph.checkpoint.constant.SaverConstant;
import static com.alibaba.cloud.ai.graph.StateGraph.START;
import static com.alibaba.cloud.ai.graph.StateGraph.END;
import static com.alibaba.cloud.ai.graph.action.AsyncNodeAction.node_async;
import java.net.http.HttpClient;
import java.net.http.HttpRequest;
import java.net.http.HttpResponse;
import java.net.URI;

// 定义状态策略
KeyStrategyFactory keyStrategyFactory = () -> {
  Map<String, KeyStrategy> keyStrategyMap = new HashMap<>();
  keyStrategyMap.put("url", new ReplaceStrategy());
  keyStrategyMap.put("result", new ReplaceStrategy());
  return keyStrategyMap;
};

// 调用 API 的节点
var callApi = node_async(state -> {
  String url = (String) state.value("url").orElse("");

  // 发起 HTTP 请求 - 副作用操作
  HttpClient client = HttpClient.newHttpClient();
  HttpRequest request = HttpRequest.newBuilder()
      .uri(URI.create(url))
      .build();

  try {
      HttpResponse<String> response = client.send(request,
          HttpResponse.BodyHandlers.ofString());
      String result = response.body().substring(0,
          Math.min(100, response.body().length()));
      return Map.of("result", result);
  } catch (Exception e) {
      throw new RuntimeException(e);
  }
});

// 创建图
StateGraph stateGraph = new StateGraph(keyStrategyFactory)
  .addNode("call_api", callApi)
  .addEdge(START, "call_api")
  .addEdge("call_api", END);

// 配置检查点
SaverConfig saverConfig = SaverConfig.builder()
  .register(SaverConstant.MEMORY, new MemorySaver())
  .build();

// 编译图
CompiledGraph graph = stateGraph.compile(
  CompileConfig.builder()
      .saverConfig(saverConfig)
      .build()
);

// 执行图
RunnableConfig config = RunnableConfig.builder()
  .threadId(UUID.randomUUID().toString())
  .build();

graph.invoke(Map.of("url", "https://www.example.com"), config);
改进版本(将副作用操作分离到独立节点)
import com.alibaba.cloud.ai.graph.StateGraph;
import static com.alibaba.cloud.ai.graph.action.AsyncNodeAction.node_async;

// 定义状态策略
KeyStrategyFactory keyStrategyFactory = () -> {
  Map<String, KeyStrategy> keyStrategyMap = new HashMap<>();
  keyStrategyMap.put("urls", new ReplaceStrategy());
  keyStrategyMap.put("results", new AppendStrategy());
  return keyStrategyMap;
};

// HTTP 请求服务(可以是独立的 Spring Bean)
class HttpRequestService {
  private final HttpClient client = HttpClient.newHttpClient();

  public String makeRequest(String url) {
      HttpRequest request = HttpRequest.newBuilder()
          .uri(URI.create(url))
          .build();

      try {
          HttpResponse<String> response = client.send(request,
              HttpResponse.BodyHandlers.ofString());
          return response.body().substring(0,
              Math.min(100, response.body().length()));
      } catch (Exception e) {
          throw new RuntimeException("请求失败: " + url, e);
      }
  }
}

// 调用 API 的节点
var callApi = node_async(state -> {
  List<String> urls = (List<String>) state.value("urls").orElse(List.of());
  HttpRequestService httpService = new HttpRequestService();

  // 批量请求
  List<String> results = urls.stream()
      .map(httpService::makeRequest)
      .collect(Collectors.toList());

  return Map.of("results", results);
});

// 创建图
StateGraph stateGraph = new StateGraph(keyStrategyFactory)
  .addNode("call_api", callApi)
  .addEdge(START, "call_api")
  .addEdge("call_api", END);

// 配置检查点
SaverConfig saverConfig = SaverConfig.builder()
  .register(SaverConstant.MEMORY, new MemorySaver())
  .build();

// 编译图
CompiledGraph graph = stateGraph.compile(
  CompileConfig.builder()
      .saverConfig(saverConfig)
      .build()
);

// 执行图
RunnableConfig config = RunnableConfig.builder()
  .threadId(UUID.randomUUID().toString())
  .build();

graph.invoke(Map.of("urls", List.of("https://www.example.com")), config);
一旦在工作流中启用了持久化执行,您可以针对以下场景恢复执行:
- 暂停和恢复工作流:使用中断机制在特定点暂停工作流,并使用更新的状态恢复它。有关更多详细信息,请参阅人在回路中文档。
- 从失败中恢复:在异常后(例如,LLM 提供商中断)从最后一个成功的检查点自动恢复工作流。这涉及使用相同的线程标识符执行工作流。
从错误中恢复示例
import com.alibaba.cloud.ai.graph.RunnableConfig;
import com.alibaba.cloud.ai.graph.CompiledGraph;

String threadId = "error-recovery-thread";
RunnableConfig config = RunnableConfig.builder()
  .threadId(threadId)
  .build();

try {
  // 第一次执行可能会失败
  graph.invoke(inputData, config);
} catch (Exception e) {
  logger.error("第一次执行失败,准备重试", e);

  // 使用相同的 threadId 重新执行,将从检查点恢复
  // 传入 null 作为输入,表示从上次状态继续
  graph.invoke(null, config);
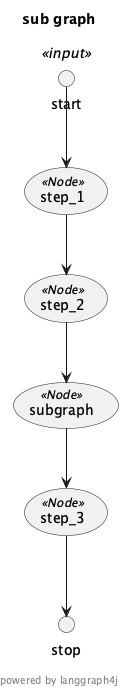
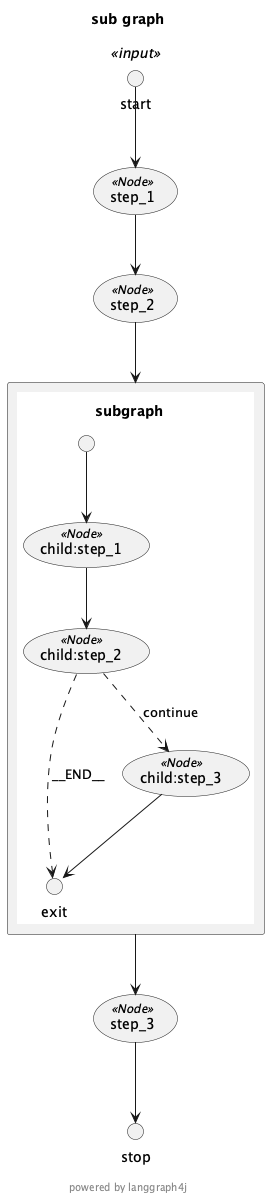
}- 在 Spring AI Alibaba Graph 中,起点是执行停止处的节点的开始。
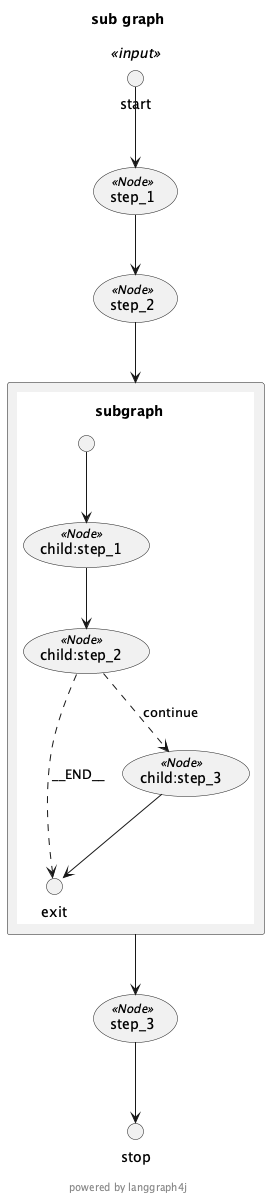
- 如果您在节点内调用子图,起点将是调用被中断子图的父节点。
- 幂等性设计:确保节点操作是幂等的,多次执行产生相同结果。
- 状态管理:合理设计状态结构,避免存储不必要的大对象。
- 错误处理:在节点中实现适当的错误处理和重试逻辑。
- 监控和日志:添加适当的日志记录以跟踪工作流执行进度。
- 测试:彻底测试暂停和恢复场景,确保工作流行为正确。
import com.alibaba.cloud.ai.graph.StateGraph;
import com.alibaba.cloud.ai.graph.CompiledGraph;
import static com.alibaba.cloud.ai.graph.action.AsyncNodeAction.node_async;

// 定义状态
KeyStrategyFactory keyStrategyFactory = () -> {
  Map<String, KeyStrategy> keyStrategyMap = new HashMap<>();
  keyStrategyMap.put("items", new ReplaceStrategy());
  keyStrategyMap.put("processedCount", new ReplaceStrategy());
  keyStrategyMap.put("results", new AppendStrategy());
  return keyStrategyMap;
};

// 处理数据的节点
var processData = node_async(state -> {
  List<String> items = (List<String>) state.value("items").orElse(List.of());
  int processedCount = (int) state.value("processedCount").orElse(0);

  // 批量处理(例如每次处理 100 个)
  int batchSize = 100;
  int start = processedCount;
  int end = Math.min(start + batchSize, items.size());

  List<String> batch = items.subList(start, end);
  List<String> processedResults = batch.stream()
      .map(item -> "Processed: " + item)
      .collect(Collectors.toList());

  return Map.of(
      "processedCount", end,
      "results", processedResults
  );
});

// 检查是否完成
var checkComplete = edge_async(state -> {
  int processedCount = (int) state.value("processedCount").orElse(0);
  List<String> items = (List<String>) state.value("items").orElse(List.of());

  return processedCount >= items.size() ? END : "process_data";
});

// 创建图
StateGraph stateGraph = new StateGraph(keyStrategyFactory)
  .addNode("process_data", processData)
  .addEdge(START, "process_data")
  .addConditionalEdges("process_data", checkComplete,
      Map.of(END, END, "process_data", "process_data"));

// 配置持久化
SaverConfig saverConfig = SaverConfig.builder()
  .register(SaverConstant.MEMORY, new MemorySaver())
  .build();

CompiledGraph graph = stateGraph.compile(
  CompileConfig.builder()
      .saverConfig(saverConfig)
      .build()
);

// 执行长时间运行的任务
RunnableConfig config = RunnableConfig.builder()
  .threadId("long-running-task-" + UUID.randomUUID())
  .build();

// 创建大量数据
List<String> largeDataSet = IntStream.range(0, 10000)
  .mapToObj(i -> "Item-" + i)
  .collect(Collectors.toList());

// 执行(可能会被中断,但可以恢复)
graph.invoke(Map.of(
  "items", largeDataSet,
  "processedCount", 0
), config);
通过这种方式,即使处理过程被中断,您也可以使用相同的 threadId 恢复执行,工作流将从上次保存的检查点继续处理。
本文整理自 Spring AI Alibaba 官方文档《持久化执行》:https://java2ai.com/docs/frameworks/graph-core/examples/long-time-running-task