
 AI项目博客
本系列共 9 篇,从空目录搭到可部署的 Python RAG 知识库。这是第 3 篇。
登录和数据库通了,现在开始做业务。这一篇完成后:能创建知识库、上传一份文件、在文档列表里看到它,并且重复上传同一个文件不会产生两条记录。
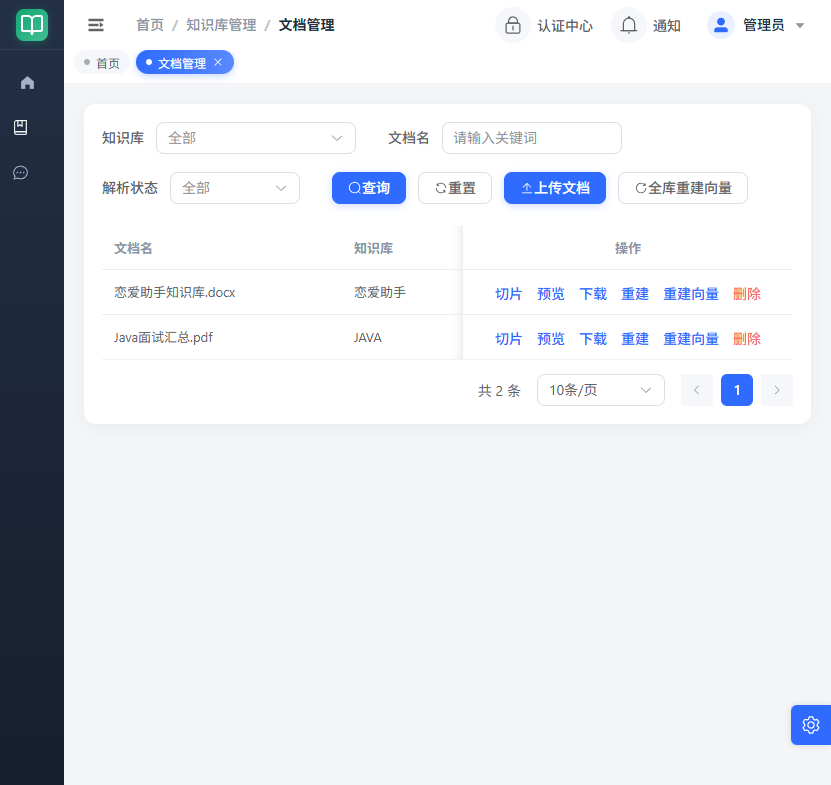
图:文档管理,上传后可切片、预览、重建。
一、知识库:先有一个“容器”
知识库表里除了名称、简介,还存了后续检索要用的参数:切片大小、重叠长度、topK、相似度阈值。这些参数跟着库走,而不是写死在代码里。
class KbKnowledgeBase(Base, AuditMixin):

    __tablename__ = "kb_knowledge_base"

    id: Mapped[int] = mapped_column(BigInteger, primary_key=True, autoincrement=True)

    tenant_id: Mapped[int | None] = mapped_column(BigInteger)

    base_code: Mapped[str | None] = mapped_column(String(64))

    base_name: Mapped[str] = mapped_column(String(128))

    embed_model: Mapped[str | None] = mapped_column(String(128))

    dim: Mapped[int | None] = mapped_column(Integer)

    chunk_size: Mapped[int | None] = mapped_column(Integer, default=800)

    chunk_overlap: Mapped[int | None] = mapped_column(Integer, default=100)

    top_k: Mapped[int | None] = mapped_column(Integer, default=5)

    score_threshold: Mapped[Decimal | None] = mapped_column(Numeric(5, 4), default=Decimal("0.3"))

    status: Mapped[int | None] = mapped_column(SmallInteger, default=1)
新增时有两件事别省:名称唯一校验和并发兜底。前者查一遍,后者靠数据库唯一索引 (tenant_id, base_name),插入冲突时返回“名称已存在”,而不是 500。
try:

    session.add(entity)

    await session.commit()

except IntegrityError:

    await session.rollback()

    raise PlatformException("知识库名称已存在,请更换名称") from None
另外,一旦库里已经有向量,就不允许直接改 Embedding 模型,因为旧向量会全部失效。换模型只能走“重建文档”的流程。
二、分页:字段名要和前端对齐
分页入参是 currentPage / currentPageSize / keyword / queryParams,出参是 currentPage / currentPageSize / total / itemList。注意是 itemList,不是 records;字段名改成 snake_case,前端列表会直接白屏。
class PageRequest(BaseModel, Generic[T]):

    currentPage: int = Field(default=1, ge=1)

    currentPageSize: int = Field(default=20, ge=1, le=500)

    keyword: str | None = None

    queryParams: T | None = None

    @property

    def offset(self) -> int:

        return (self.currentPage - 1) * self.currentPageSize
三、文件存储:MinIO 只负责存原文
MinIO 的 Python SDK 是同步阻塞的,直接在 async 接口里调用会卡住整个事件循环。统一用 asyncio.to_thread 包一层:
async def put_object(object_name: str, stream, size: int, extension: str) -> None:

    def _put():

        stream.seek(0)          # 哈希阶段已经把指针读到了末尾

        _minio().put_object(

            settings.minio_bucket, object_name, stream,

            length=size, part_size=10 * 1024 * 1024,

            content_type=mime_of(extension),

        )

    await asyncio.to_thread(_put)
对象名照 yyyyMMdd/{uuid32}.{扩展名} 生成,避免同名覆盖。文件本身不读进内存,超过 10MB 自动走分片上传。
四、上传:先算指纹,再决定收不收
上传接口是 multipart,参数只有 baseId 和 file。别急着写 MinIO,先做四件事:
- 知识库必须存在且启用;
- 扩展名在白名单里(txt/md/docx/pdf/xlsx);
- 边读边算 SHA-256,得到真实大小;
- 同一知识库下已有相同
doc_hash,直接返回已有文档 ID。
async def upload(session, base_id, filename, file, declared_size) -> int:

    base = await base_service.assert_enabled(session, base_id)

    file_type = _resolve_file_type(filename)

    doc_hash, actual_size = await _hash_stream(file)

    duplicated = await session.scalar(

        scoped(select(KbDocument).where(

            KbDocument.base_id == base_id,

            KbDocument.doc_hash == doc_hash,

        ).limit(1), KbDocument)

    )

    if duplicated:

        return int(duplicated.id)      # 重复内容不占额度、不重复存

    await quota_service.assert_can_upload(session, actual_size)

    object_name = minio_client.build_object_name(file_type)

    await minio_client.put_object(object_name, file, actual_size, file_type)

    entity = KbDocument(

        tenant_id=base.tenant_id, base_id=base_id, doc_name=filename,

        file_key=object_name, file_type=file_type, file_size=actual_size,

        doc_hash=doc_hash, parse_status=0, embed_status=0, version=1,

    )

    session.add(entity)

    await session.commit()

    return int(entity.id)
为什么去重要放在配额校验和写 MinIO 之前:重复文件不占额度,也不该先产生一个垃圾对象。极小概率的并发重复由唯一索引 (base_id, doc_hash) 兜底,冲突时把刚传的对象删掉,返回已有文档。
五、上传后立刻解析一次
扫描任务是分钟级的,用户传完文件等几分钟会以为失败了。所以接口在落库后立即触发一次解析:
doc_id = await doc_service.upload(session, baseId, file.filename, file.file, file.size)

await doc_service.process_parse(doc_id)

return success(doc_id)
解析流程很长,下一篇专门讲。这里先知道:接口返回的是 docId,解析和向量化在后台继续,文档状态可以从列表页轮询。
六、验证一下
# 1. 建一个知识库

curl -s -X POST localhost:18015/kb/base/save \

  -H "satoken: 你的token" -H "Content-Type: application/json" \

  -d '{"baseName":"员工手册","chunkSize":800,"chunkOverlap":100,

       "splitMode":1,"topK":5,"scoreThreshold":0.3}'

# 2. 上传文件(需要 python-multipart,先 uv add python-multipart)

curl -s -X POST localhost:18015/kb/doc/upload \

  -H "satoken: 你的token" \

  -F baseId=1 -F file=@handbook.md

# 3. 看文档列表

curl -s -X POST localhost:18015/kb/doc/page \

  -H "satoken: 你的token" -H "Content-Type: application/json" \

  -d '{"currentPage":1,"currentPageSize":20,"queryParams":{"baseId":1}}'
再传一次同一个文件,返回的 docId 应该不变,列表里也只有一条。
七、本篇踩坑
- MinIO SDK 是同步的。 忘记包
to_thread,并发上传时整个服务会卡住。 - 哈希后要
seek(0)。 否则 MinIO 从文件末尾开始读,传上去的是空文件。 - 先校验再写对象。 配额不够、文件类型不对时,不能先在 MinIO 留下垃圾。
- 文件大小以流式结果为准。 multipart 声明的 size 只能用于快速拒绝,不能作为最终依据。
下一篇
文件已经进来了,下一篇把“解析”和“切片”做完:五种格式怎么变成纯文本、怎么按标题和句子切块、卡住的任务怎么自动重试。
上一篇:数据库、登录与多租户 | 下一篇:解析、切片与补偿任务








