
 AI项目博客
本系列共 9 篇,从空目录搭到可部署的 Python RAG 知识库。这是第 2 篇。
第 1 篇只让服务能启动;这一篇让它“认识人”和“存住数据”。完成后:不带 token 访问受保护接口返回 401,用认证中心的 ticket 换到本地 token 后能正常访问,并且所有查询都自动限定在当前租户内。
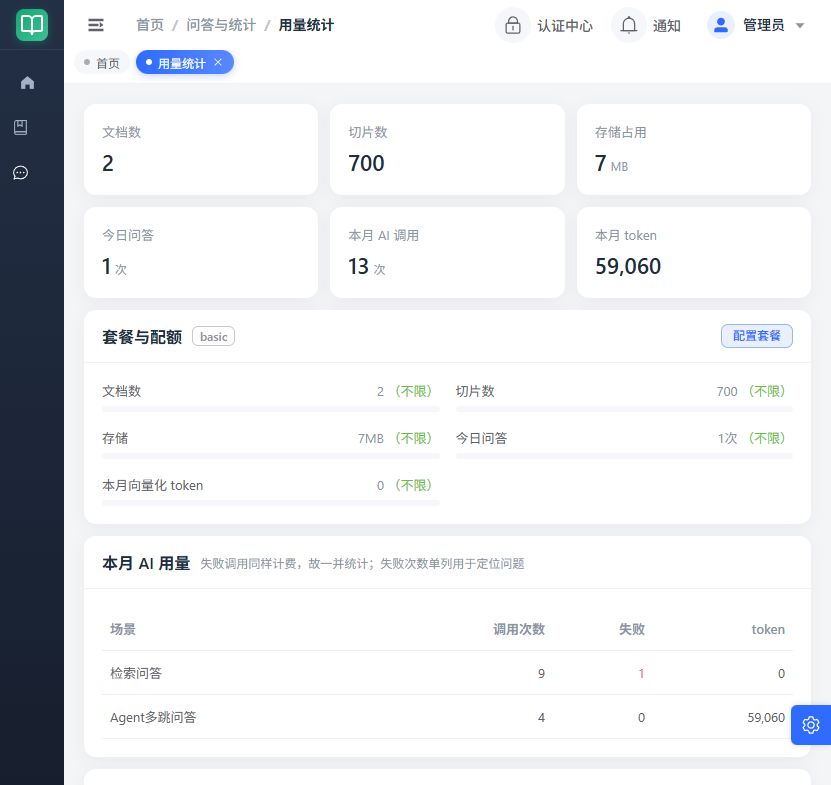
图:用量统计按租户统计文档、切片、存储、问答与 AI 调用,套餐配额单列。
一、先建表:8 张业务表 + 1 张向量表
业务数据放 PostgreSQL,向量也放同一个库(pgvector 扩展)。一共 9 张表:8 张业务表 + 1 张向量表。
| 表 | 存什么 |
|---|---|
kb_knowledge_base |
知识库,切片大小、topK、相似度阈值等配置 |
kb_document |
文档元数据、MinIO 对象名、解析/向量化状态、版本 |
kb_chunk |
切片正文、标题路径、序号、向量化状态 |
kb_chunk_vec |
pgvector 向量,和切片一对一 |
kb_qa_session |
问答会话 |
kb_qa_message |
用户问题与模型答案 |
kb_qa_reference |
答案引用了哪个切片、排第几 |
kb_ai_invoke_log |
每次模型调用的 token、耗时、成功/失败 |
kb_tenant_quota |
租户套餐与用量 |
主键统一用 bigint identity,时间列统一 timestamptz。先把扩展装上,否则后面向量表建不出来:
CREATE EXTENSION IF NOT EXISTS vector;

CREATE EXTENSION IF NOT EXISTS pg_trgm;

CREATE TABLE kb_chunk_vec (

    id          BIGINT GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,

    chunk_id    BIGINT NOT NULL UNIQUE,

    tenant_id   BIGINT,

    base_id     BIGINT NOT NULL,

    doc_id      BIGINT NOT NULL,

    version     INT DEFAULT 1,

    content     TEXT,

    embedding   vector(1024) NOT NULL

);

CREATE INDEX idx_kb_vec_embedding ON kb_chunk_vec

    USING hnsw (embedding vector_cosine_ops);
向量维度固定 1024,必须和 Embedding 模型一致。HNSW 索引固定余弦,查询时记得同时写 ORDER BY 和 LIMIT,否则索引不生效。
二、ORM 只做映射,建表交给 SQL
表结构以 docs/sql/kb_schema.sql 为准,ORM 只负责读写。公共审计字段抽一个 Mixin,避免每张表重复写:
class AuditMixin:

    created_id: Mapped[int | None] = mapped_column(BigInteger)

    created_time: Mapped[datetime | None] = mapped_column(

        TIMESTAMP(timezone=True), server_default=func.now()

    )

    updated_id: Mapped[int | None] = mapped_column(BigInteger)

    updated_time: Mapped[datetime | None] = mapped_column(

        TIMESTAMP(timezone=True), server_default=func.now(), onupdate=func.now()

    )

class KbDocument(Base, AuditMixin):

    __tablename__ = "kb_document"

    id: Mapped[int] = mapped_column(BigInteger, primary_key=True, autoincrement=True)

    tenant_id: Mapped[int | None] = mapped_column(BigInteger)

    base_id: Mapped[int] = mapped_column(BigInteger)

    doc_name: Mapped[str] = mapped_column(String(255))

    file_key: Mapped[str | None] = mapped_column(String(512))

    parse_status: Mapped[int | None] = mapped_column(SmallInteger, default=0)

    version: Mapped[int | None] = mapped_column(Integer, default=1)
三、异步会话:请求一个,后台任务自己开
Web 请求用 FastAPI 依赖拿 session,退出时自动归还连接;定时任务和流式生成器不能用请求级 session,要自己开一个 session_scope()。
async def get_session():

    async with get_session_factory()() as session:

        yield session

@asynccontextmanager

async def session_scope():

    async with get_session_factory()() as session:

        try:

            yield session

            await session.commit()

        except Exception:

            await session.rollback()

            raise
和 Java 最大的区别:SQLAlchemy 没有隐式事务,改了数据必须显式 commit。另外,只要执行过一次查询,事务就悄悄开始了;长链路(SSE、Agent)里不结束事务,会一直占着数据库连接。
四、登录上下文:async 里不能用 ThreadLocal
一个线程里会跑很多协程,用 ThreadLocal 存当前用户必然串号。这里改用 ContextVar,每个请求一份副本,set/reset 精确配对。
@dataclass(slots=True)

class LoginContext:

    login_id: str = ""

    user_id: int | None = None

    tenant_id: int | None = None

    roles: list[str] = field(default_factory=list)

    permissions: list[str] = field(default_factory=list)

    admin: bool = False

    menus: Any = None

    token: str = ""

_current: ContextVar[LoginContext | None] = ContextVar("kb_login_context", default=None)
登录依赖做三件事:从 satoken 头(或查询参数)取 token,去 Redis 读会话,把用户信息塞进 ContextVar。只要还在使用,就给会话续期。
五、多租户:每条查询显式加条件
Java 有 MyBatis 拦截器自动拼 tenant_id,Python 没有。这里不模拟拦截器,而是提供一个显式助手,所有查询都走它:
def scoped(stmt: Select, model) -> Select:

    tenant_id = current_tenant_id()

    if tenant_id is None:       # 超管 / 无上下文:不限制

        return stmt

return stmt.where(model.tenant_id == tenant_id)漏写的后果很隐蔽:不报错,但会跨租户读到别人的数据。所以定一条规矩:新增查询,先写 scoped(),再写业务条件。写库时租户从文档继承,不能依赖请求上下文,因为定时任务里根本没有上下文。
六、SSO:一张 ticket 换一个本地 token
登录流程分四步:
- 前端拿
/sso/getSsoAuthUrl?clientLoginUrl=...,跳到认证中心; - 登录成功后带
ticket回跳; - 前端调
/sso/doLoginByTicket?ticket=...,后端向认证中心/sso/pushS发送msgType=checkTicket换票; - 拿到
loginId/loginUser/menus,存进 Redis,生成一个本地 token 返回。
签名规则是 Sa-Token 那一套:参数按 key 字典序拼成 k=v&k=v,末尾接 &key=密钥,再算 MD5。
def build_sign(params: dict, secret_key: str) -> str:

    pairs = [f"{k}={params[k]}" for k in sorted(params)

             if k != "sign" and params[k] is not None]

    return hashlib.md5(f"{'&'.join(pairs)}&key={secret_key}".encode()).hexdigest()
本地 token 用 secrets.token_hex(32) 生成,会话键是 kbpy:session:{token},和 Java 的 Sa-Token 完全隔离。前端之后每次请求带 satoken 头即可。
七、权限:一个依赖搞定
接口用 Depends(require_permission("kb:base:list:page")) 声明权限。超管看 admin 标志位直接放行;普通用户按权限码精确匹配,支持 kb:base:* 这种全串通配。
def require_permission(code: str):

    async def _dependency(ctx: LoginContext = Depends(require_login)) -> LoginContext:

        if not has_permission(ctx, code):

            raise PlatformException("无权限访问该资源", 403)

        return ctx

    return _dependency
权限是换票时的快照,运行时不查库。管理员改了角色,用户要重新登录才生效——这是有意的取舍,避免每个请求多打一次认证中心。
八、验证一下
# 1. 不带 token,应该 401

curl -s -X POST localhost:18015/kb/base/page \

  -H "Content-Type: application/json" -d '{"currentPage":1,"currentPageSize":20}'

# 2. 浏览器访问授权地址,登录后拿到 ticket

curl -s "localhost:18015/sso/getSsoAuthUrl?clientLoginUrl=http://localhost:3004/login"

# 3. 用 ticket 换 token

curl -s "localhost:18015/sso/doLoginByTicket?ticket=xxxx"

# 4. 带上 token 访问

curl -s -X POST localhost:18015/kb/base/page \

  -H "satoken: 你的token" -H "Content-Type: application/json" \

  -d '{"currentPage":1,"currentPageSize":20}'
九、本篇踩坑
- 不要用 ThreadLocal 存登录态。 async 服务里线程会被复用,用户身份会串。
- 租户条件必须显式写。 漏了不报错,只会悄悄泄漏数据。
- 权限策略不会实时刷新。 改了角色/权限码,让用户重新登录。
- 本地 token 和 Java 版不互通。 换端口调试要重新登录,这是数据与实现隔离的代价。
下一篇
登录和数据层都通了,下一篇开始写业务:建知识库、用 MinIO 上传文档、流式算指纹去重,并把文档记录落库。








