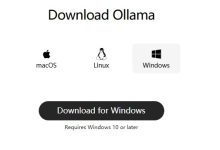
前几篇都是调用云端 API。还有一个角度是「模型放在哪里」:本地部署。LangChain 支持使用 Ollama、vLLM 等框架启动的本地大模型,这里以 Ollama 为例。 09.1 Ollama 是什么 Ollama 是 GitHub 上的开源项目,定位是「本地运行大模型的集成框架」:把 Qwen、DeepSeek 等主流模型的下载、启动和本地推理自动化。官方地址:https://ollama.com。 09.2 安装 Ollam…
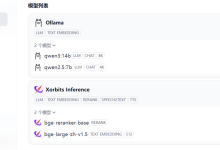
「企业级大模型私有化部署」系列第 4 篇。目标:在第二台 GPU 服务器上装 Xinference,部署 bge-large-zh-v1.5 和 reranker,再通过 6007 隧道接进 Dify。 结论:RAG 的效果不只看大语言模型。向量化决定了能不能召回,Rerank 决定了召回的片段排得对不对;这两个模型用 Xinference 管,比用 Ollama 更稳。 一、Xinference 是什么 Xinference 是一个强…
「企业级大模型私有化部署」系列第 3 篇。目标:在 AutoDL 的 RTX 4090 上装 Ollama,跑 qwen3:4b,再通过 SSH 隧道接进 Dify。 结论:Ollama 负责「把大模型跑起来」,Dify 负责「把大模型用起来」。中间那根线是 SSH 隧道;隧道没通,Dify 里怎么配都看不到模型。 一、AutoDL 是什么 AutoDL 是面向开发者和企业的 GPU 算力平台,提供 RTX 4090、3090、A 系列…
「企业级大模型私有化部署」系列第 2 篇。目标:在腾讯云 4 核 8GB 的 CVM 上,用 Docker 把 Dify 跑起来,完成首次管理员设置,并接一个在线模型验证。 结论:Dify 是应用层,本身不重;真正容易卡住的是 Docker 安装、镜像拉取和首次访问。把这三步做稳,后面接模型才有意义。 一、Dify 能做什么 Dify 是一个综合性的 LLM 应用开发平台,内置了构建生成式 AI 应用所需的大部分技术栈: 基于 Agen…
「企业级大模型私有化部署」系列共 4 篇:场景与拓扑、Dify、Ollama、Xinference。这是第 1 篇。 结论:私有化部署不是「装一个 Dify」就结束了。它是一条从应用平台到模型服务的链路:Dify 负责应用,Ollama 负责大语言模型,Xinference 负责 Embedding 与 Rerank,三台服务器各司其职。 一、为什么企业要做私有化部署 企业在使用大模型时,第一约束是数据安全。把制度、客户资料、代码、合同…
如果你想在一台没有独立显卡(或者只有一张老显卡)的机器上,跑通一套**完全离线**的「文档问答」环境——本地把文字转成向量、本地存起来、本地检索、本地生成回答,不调用任何在线大模型服务——这篇文章把整个过程从头到尾写了一遍。 实测机器:i5-10400F +

 AI项目博客
 admin
最新评论
干货满满!
江苏省 南京市 · IP 49.91.145.*
我要看文章
重庆市 · IP 116.168.9.*
这个内容实在是太精彩啦
重庆市 · IP 123.147.232.*