
 AI项目博客
本系列共 9 篇,从空目录搭到可部署的 Python RAG 知识库。这是第 6 篇。
向量有了,现在回答关键问题:用户提问时,怎么在几秒内从成千上万张切片里找到最相关的几段?这一篇讲两条召回路线、RRF 融合,以及为什么召回之后还要回表复核。
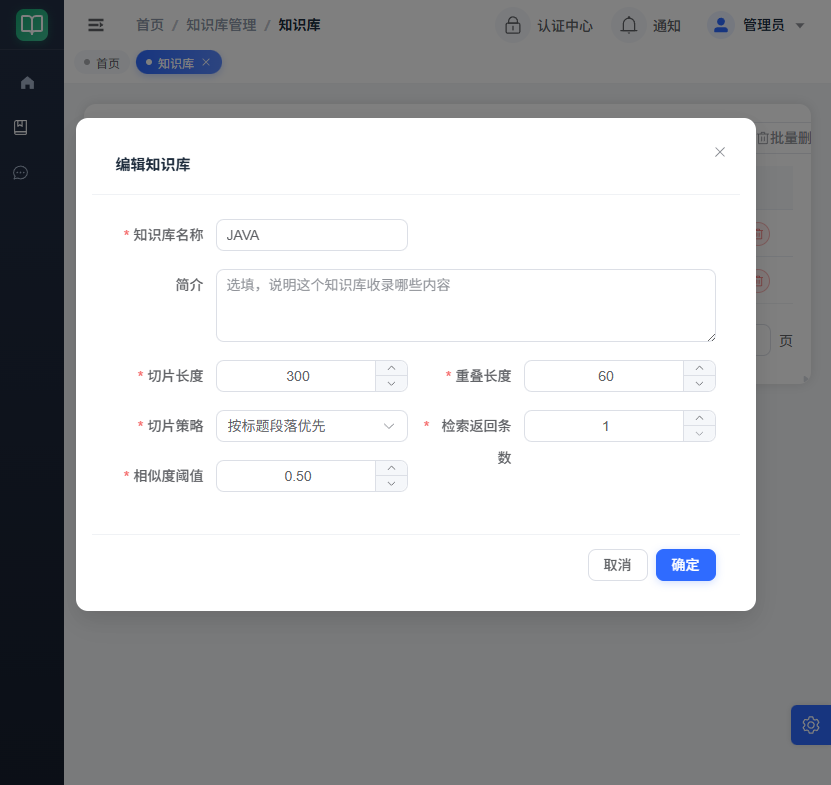
图:知识库参数,检索返回条数与相似度阈值是混合检索的两个旋钮。
一、为什么不能只靠向量
向量擅长“意思相近”:用户问“怎么报销”,能找到写着“费用核销流程”的段落。但它对专有名词、错误码、型号不敏感,ERR_1024 和 ERR_2048 在向量空间里可能非常近。
关键词擅长“字面命中”,但用户换个说法就找不到。所以两条路一起走,再用排名融合。
二、向量召回:相似度 = 1 – 距离
pgvector 的余弦距离运算符是 <=>,距离越小越相似。SQL 里要换算成相似度,再和阈值比较:
SELECT chunk_id, 1 - (embedding <=> CAST(:vec AS vector)) AS score

FROM kb_chunk_vec

WHERE (CAST(:tenant_id AS bigint) IS NULL OR tenant_id = CAST(:tenant_id AS bigint))

  AND (cardinality(CAST(:base_ids AS bigint[])) = 0

       OR base_id = ANY(CAST(:base_ids AS bigint[])))

  AND 1 - (embedding <=> CAST(:vec AS vector)) >= :min_similarity

ORDER BY embedding <=> CAST(:vec AS vector)

LIMIT :top_k
这里有三个“必须”:必须带租户/知识库过滤、必须带绝对阈值、必须 ORDER BY + LIMIT。少了最后两个,HNSW 索引可能不生效,变成全表扫描。
向量路是“可降级”的:Embedding 服务超时、pgvector 扩展缺失、维度不匹配,都不应该让整个问答 500。捕获异常、记一条日志、返回空结果,让关键词路继续工作。
三、关键词召回:中文双字 + 英文词元
PostgreSQL 没有 MySQL 的 ngram 全文索引。整句 ILIKE '%用户的问题%' 对自然语言问句几乎命中不了,所以要把问题拆成更小的词元:
def _query_tokens(question: str) -> list[str]:

    text = (question or "").lower()

    tokens: list[str] = []

    for run in _CJK_RUN.findall(text):          # 连续中文

        if len(run) <= 2:

            tokens.append(run)

        else:

            tokens.extend(run[i:i + 2] for i in range(len(run) - 1))

    tokens.extend(w for w in _ASCII_WORD.findall(text) if len(w) >= 2)

    return list(dict.fromkeys(tokens))[:24]     # 去重并限制个数
每个词元生成一个 ILIKE 条件,命中一个记 1 分,按总分排序。这里的分不是 BM25,只用于本路排序和相对阈值:低于“本路最高分 × minSimilarity”的候选直接丢掉。
关键词查询要 join 文档表,确保只召回当前版本的切片:
stmt = (

    select(KbChunk.id, score_expr.label("score"))

    .join(KbDocument, and_(

        KbDocument.id == KbChunk.doc_id,

        KbDocument.version == KbChunk.version,

    ))

    .where(or_(*matches))

    .order_by(score_expr.desc(), KbChunk.id.asc())

    .limit(settings.keyword_top_k)

)
四、RRF:只看排名,不看分数
向量路的分数是余弦相似度,关键词路的分数是命中词数,量纲不同,直接相加没有意义。RRF(Reciprocal Rank Fusion)只用排名:
def _fuse(vector_hits: dict[int, float], keyword_hits: dict[int, float], k: int = 60):

    scores: dict[int, float] = {}

    for rank, chunk_id in enumerate(vector_hits, start=1):

        scores[chunk_id] = scores.get(chunk_id, 0.0) + 1.0 / (k + rank)

    for rank, chunk_id in enumerate(keyword_hits, start=1):

        scores[chunk_id] = scores.get(chunk_id, 0.0) + 1.0 / (k + rank)

    return scores
一个切片如果两路都排第一,得分是 1/61 + 1/61;只有一路排第一则是 1/61。排名越靠前,贡献越大,但不会因为某一路分值特别大就压倒另一路。
五、召回之后,必须回表复核
向量表是“编外人员”:没有外键,也不归任何查询拦截器管。召回结果可能指向已经删除的切片、旧版本的切片,甚至别的租户。所以拿到 chunk_id 后要回 kb_chunk 再查一遍:
stmt = scoped(select(KbChunk).where(KbChunk.id.in_(ordered)), KbChunk)

rows = (await session.scalars(stmt)).all()

chunk_by_id = {chunk.id: chunk for chunk in rows}

doc_ids = {chunk.doc_id for chunk in chunk_by_id.values()}

version_rows = await session.execute(

    select(KbDocument.id, KbDocument.version).where(KbDocument.id.in_(doc_ids))

)

current_version = {doc_id: version or 1 for doc_id, version in version_rows}
逐条检查:切片还在吗?租户匹配吗?它属于文档当前版本吗?任何一条不满足就丢弃。最后把正文截断到 800 字,避免一条切片撑爆提示词。
六、参数从知识库配置来
每个知识库可以配自己的 topK 和相似度阈值。用户选了多个库时,取“最宽松”的一组:topK 取最大,阈值取最小。没有选库时按当前租户全部知识库计算;如果所有库都没配阈值,才回落到环境变量。
async def resolve_params(session, base_ids):

    stmt = select(KbKnowledgeBase.top_k, KbKnowledgeBase.score_threshold)

    if base_ids:

        stmt = stmt.where(KbKnowledgeBase.id.in_(base_ids))

    rows = (await session.execute(scoped(stmt, KbKnowledgeBase))).all()

    top_k = max((int(row[0]) for row in rows if row[0]), default=None)

    threshold = min((float(row[1]) for row in rows if row[1] is not None), default=None)

    return top_k, threshold
七、可选重排:让模型再打一次分
RRF 融合后,如果开了重排,会取比最终 topK 更大的候选集(比如 20 条),让对话模型一次给每条打 0-10 分,再按分数排序。三个保护:
- 只截取每条正文前 400 字,判断相关性不需要全文;
- 解析成功率低于 50% 就放弃本次重排,保持 RRF 原序;
- 重排后重新编号
rank,因为答案里的[n]和引用表都依赖它。
重排默认关闭:每次检索多一次模型调用,成本和延迟都会上去。数据量和准确率要求上来后再开。
八、验证一下
没有单独的检索接口,可以写个临时脚本直接调用:
import asyncio

from app.core.context import LoginContext, login_context

from app.core.db import session_scope

from app.services import retrieval

async def main():

    ctx = LoginContext(user_id=1, tenant_id=1, admin=False)

    with login_context(ctx):

        async with session_scope() as session:

            hits = await retrieval.retrieve(session, "报销标准是多少", base_ids=[1])

            for hit in hits:

                print(hit.rank, round(hit.rrf_score, 4), hit.title_path, hit.content[:60])

asyncio.run(main())
预期能看到 3-8 条切片,rrf_score 从高到低,content 和问题相关。如果为空,先确认切片已向量化、阈值没有配得太高。
九、本篇踩坑
- 向量路失败不能拖垮问答。 捕获异常降级成纯关键词,比整个接口 500 好。
- 关键词路没有倒排索引。 数据量大时全表
ILIKE会慢,后续再加 pg_trgm/GIN 或搜索引擎。 - RRF 不能拿原始分数相加。 量纲不同,必须只用排名。
- 召回结果必须复核。 向量表不会跟着切片删除自动清理,孤儿向量很常见。
下一篇
检索出来的片段,怎么变成一段带 [1][2] 出处的回答?下一篇进入问答主链路:会话、提示词、引用落库和 SSE 流式输出。








