
 AI项目博客
本系列共 9 篇,从空目录搭到可部署的 Python RAG 知识库。这是第 8 篇。
单轮问答是“检索一次,再回答”。但有些问题需要先查一遍、发现不够、换个关键词再查,甚至要读某个切片的完整正文。这一篇用 LangGraph 做一个能自己决定检索几次的 Agent,并让它记住同一个会话的历史。
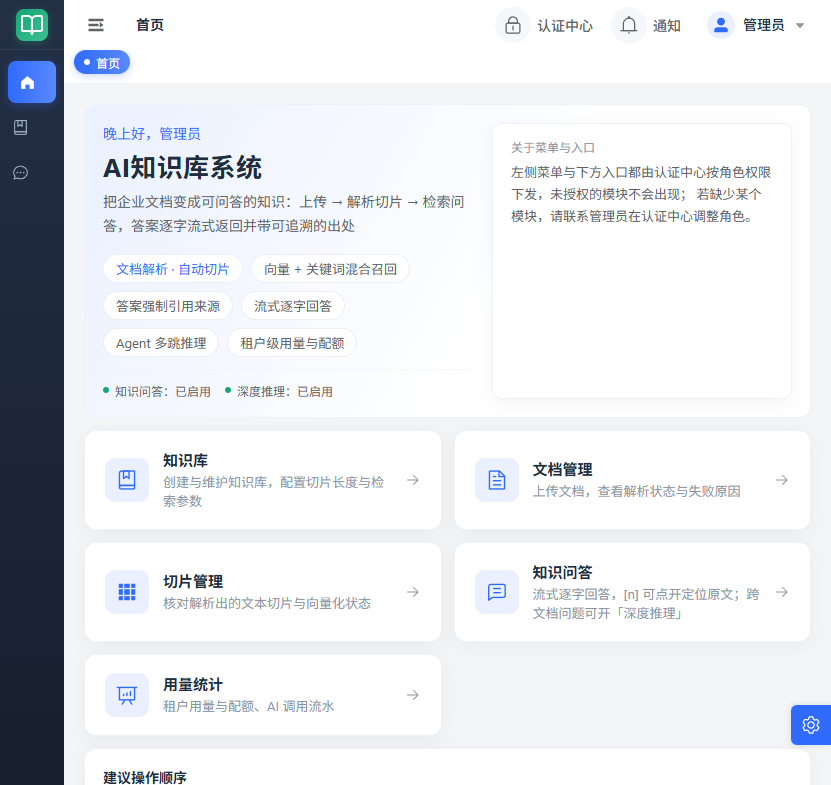
图:首页功能位,知识问答与深度推理均已启用,Agent 多跳推理是独立入口。
一、什么时候需要 Agent
| 单轮 RAG | Agent | |
|---|---|---|
| 检索次数 | 固定一次 | 模型自己决定,可换关键词、可读完整切片 |
| 速度与成本 | 快、便宜、可预测 | 慢、贵,适合跨文档的复杂问题 |
| 适用场景 | “文档里有没有写” | “把几份文档里的线索串起来” |
不要把所有问题都交给 Agent。用户问“报销标准是多少”,单轮 RAG 一次检索就够;上 Agent 只会多花几倍 token。
二、装配:一个模型 + 两个只读工具
用 LangChain 1.x 的 create_agent,工具只有两个:
kb_search(query):在知识库里检索,返回带[chunk:id]的片段;kb_read_chunk(chunk_id):按 ID 读取某个切片的完整正文。
安全边界靠闭包:能检索哪些知识库、哪个租户,在创建工具时由服务端注入,模型既看不到也改不了。工具全部只读,不会删除或修改任何数据。
def _build_tools(base_ids, collected, min_similarity):

    @tool

    async def kb_search(query: str) -> str:

        """在知识库中检索与问题相关的片段。"""

        async with get_session_factory()() as tool_session:

            hits = await retrieval.retrieve(

                tool_session, query, base_ids,

                settings.agent_retrieve_top_k, min_similarity, rerank=False,

            )

        if not hits:

            return "未检索到相关内容。"

        blocks = []

        for hit in hits:

            collected.setdefault(hit.chunk_id, _UsedChunk(...))

            blocks.append(f"[chunk:{hit.chunk_id}]\n{hit.content}")

        return "\n\n".join(blocks)

    @tool

    async def kb_read_chunk(chunk_id: int) -> str:

        """读取指定切片的完整正文。"""

        ...

return [kb_search, kb_read_chunk]注意工具内部每次独立开 session。LangGraph 同一轮可能并行执行多个工具,共用一个请求级 session 会让两个协程同时操作一个事务,直接把连接弄崩。
三、Agent 的提示词:先检索,再作答
单轮 RAG 的提示词只要求“依据资料回答”,没有告诉模型“先去检索”。Agent 必须用另一套指令:
AGENT_INSTRUCTION = """你是企业知识库的检索问答助手。

工作方式:

1. 回答任何问题前,先用 kb_search 检索知识库;最多检索 2 次(可换关键词),

   拿到相关片段后立即作答,不要反复检索同一个问题。

2. 片段被截断、或需要确认上下文时,用 kb_read_chunk 读取完整正文。

3. 只能依据检索到的内容作答。每处结论后面用 [chunk:切片Id] 标注来源。

4. 两次检索仍无依据时,直接回答「知识库中未找到相关内容」。

5. 不得编造切片Id;只引用这次检索结果里真实出现过的。"""
四、记忆:为什么从 Redis 换成了 PostgreSQL
最初想用 Redis 做 Agent 记忆,但生产 Redis 是精简版,没有 RediSearch 模块,检查点初始化直接失败。后来改成 LangGraph 的 PostgreSQL checkpointer,复用业务库,不需要额外基础设施。
pool = AsyncConnectionPool(

    conninfo=_pg_conninfo(), min_size=1, max_size=2, open=False,

    kwargs={"autocommit": True, "prepare_threshold": 0, "row_factory": dict_row},

)

await pool.open()

saver = AsyncPostgresSaver(pool)

await saver.setup()          # 幂等:自动建 checkpoint 表
业务库 URL 是 SQLAlchemy 的 postgresql+asyncpg://,psycopg 不认,要换成 postgresql:// 并补 connect_timeout。checkpointer 不可用时整个 Agent 退化成“无记忆”,但不影响本次回答。
会话边界就是记忆边界:thread_id = 会话 id。同一个会话多轮追问共享历史;删除会话时,顺手调用 delete_thread 清掉对应 checkpoint,避免留下孤儿记忆。
五、两个中间件:限次数、剪历史
Agent 最大的风险是停不下来。这里加两个保险:
ModelCallLimitMiddleware(run_limit=6):最多调用 6 次模型,到点强制收尾;trim_history:只保留最近 20 条消息,且不能以工具结果开头(供应商会直接 HTTP 400),系统提示词永远保留。
@before_model

def trim_history(state, runtime):

    messages = state["messages"]

    limit = max(2, settings.agent_max_history_messages)

    if len(messages) <= limit:

        return None

    tail = list(messages[-limit:])

    while tail and isinstance(tail[0], ToolMessage):

        tail.pop(0)

    if messages and isinstance(messages[0], SystemMessage):

        tail = [messages[0], *tail]

    return {"messages": tail}
递归上限也要算够:LangGraph 每个 superstep 算一步,每次“模型 + 工具”占两步。上限必须大于模型调用次数对应的步数,否则限次中间件还没来得及优雅收尾,就先抛 GraphRecursionError 了。
六、引用重写:[chunk:id] 变成 [n]
Agent 在回答里写的是真实切片 ID,用户看不懂,也不该看到内部 ID。收尾时按首次出现顺序重写成 [1][2],最多 20 条;没通过工具取到的 ID 一律丢弃,杜绝模型编造引用。
def replace(match):

    chunk_id = int(match.group(1))

    chunk = collected.get(chunk_id)

    if chunk is None:

        return ""                     # 模型编的 ID:删掉

    if chunk_id not in mapping:

        if len(order) >= 20:

            return ""

        mapping[chunk_id] = len(order) + 1

        order.append(chunk)

    return f"[{mapping[chunk_id]}]"

rewritten = _REFERENCE.sub(replace, answer or "")
和单轮问答同一条底线:没有真实引用就不让模型自由发挥,直接替换成固定话术。只有“你是谁”“你好”这类问候型问题例外。
七、验证一下
# 第一轮

curl -s -X POST localhost:18015/kb/qa/agent/ask \

  -H "satoken: 你的token" -H "Content-Type: application/json" \

  -d '{"question":"差旅和报销标准有什么不同?","baseIds":[1]}'

# 第二轮:带上同一个 sessionId,验证记忆

curl -s -X POST localhost:18015/kb/qa/agent/ask \

  -H "satoken: 你的token" -H "Content-Type: application/json" \

  -d '{"sessionId":1,"question":"那住宿费呢?"}'
检查答案里有 [n],references 不为空,第二轮能理解“那”指的是上一轮的差旅话题。
八、本篇踩坑
- 工具并发不能共用一个 session。 每个工具调用独立开会话。
- Redis 不是万能的。 没有 RediSearch 模块就用不了 Redis checkpointer,提前确认生产环境能力。
- 递归上限要留余量。 否则限次中间件还没生效就先崩了。
- 会话删除要清记忆。 否则 checkpoint 表会越来越大。
下一篇
功能都齐了,最后一篇做“能上线”的收尾:AI 调用流水、租户配额、日志与 traceId、Docker 部署,以及生产环境检查清单。








