
 AI项目博客
本系列共 9 篇,从空目录搭到可部署的 Python RAG 知识库。这是最后一篇。
问答、Agent 都能跑了,但“能演示”和“能上线”之间还差一段:模型调用要记账,租户要限额度,出问题要能查,服务要能部署。这一篇把这些收尾工作做完。
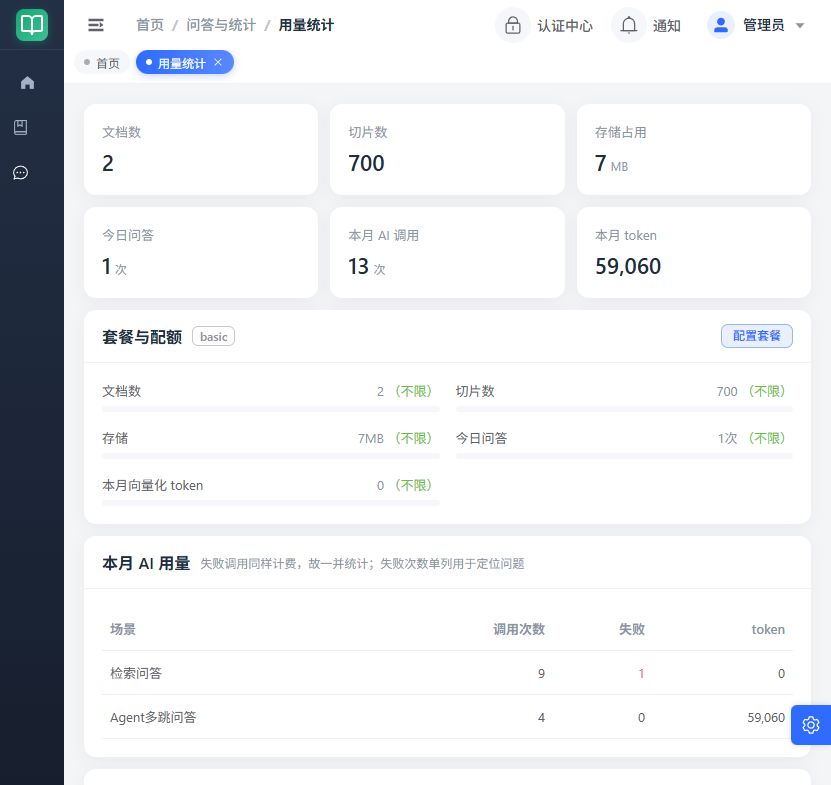
图:用量统计按场景拆分调用次数、失败与 token,失败调用同样计费。
一、AI 流水:失败也要记
每次调用模型都写一条 kb_ai_invoke_log:场景、模型、token 数、耗时、成功/失败、错误信息。场景用数字区分:向量化 1、对话 3、重排 5、Agent 6。
async def record(scene, model, tokens, success, error_msg, elapsed_ms, tenant_id=None):

    try:

        async with session_scope() as session:     # 独立事务

            session.add(KbAiInvokeLog(

                tenant_id=tenant_value(tenant_id),

                scene=scene, model=model, total_tokens=tokens or 0,

                success_flag=1 if success else 0,

                error_msg=error_msg, elapsed_ms=elapsed_ms,

            ))

    except Exception as exc:

logger.warning("写 AI 流水失败:scene=%s,%s", scene, exc)两个原则:失败也记,因为超时/报错在多数供应商那里照样计费;独立事务,避免主流程回滚把流水一起回滚。写流水失败本身只记日志,不能反过来影响问答。
二、配额:一条原子 UPDATE 扣次数
问答次数是先扣再干活,避免用户等十几秒才被告知超限。并发下“先查再改”会被刷穿,所以判断和占用放在同一条 UPDATE 里:
UPDATE kb_tenant_quota

SET used_qa_count = CASE

        WHEN used_qa_date = :today THEN used_qa_count + 1

        ELSE 1

    END,

    used_qa_date = :today,

    updated_time = now()

WHERE tenant_id = :tenant_id

  AND status = 1

  AND (expire_time IS NULL OR expire_time > now())

  AND (

      qa_limit_daily = 0

      OR used_qa_date IS DISTINCT FROM :today

      OR used_qa_count < qa_limit_daily

  )

RETURNING qa_limit_daily;
更新到行就放行;没更新到再查一次套餐,给出准确原因:停用、过期,还是今天次数用完。没有配额行 = 未配置 = 不限。
上传前检查文档数、切片数、存储空间;向量化前检查当月 token。配额失败不退还:请求已经真实发出,供应商照样计费,“失败不计数”等于开了免费刷模型的口子。
三、统计看板:尽量实时算
用量总览不依赖容易漂移的计数字段,直接实时聚合:文档数、切片数、存储字节、当月调用次数、当月 token、按场景分组的成功/失败数。套餐的“已用”也用同样的实时口径,避免出现“看板有额度、实际已被拦”。
doc_count = await session.scalar(scoped(

    select(func.count()).select_from(KbDocument), KbDocument

))

storage_bytes = await session.scalar(scoped(

    select(func.coalesce(func.sum(KbDocument.file_size), 0)), KbDocument

))

scene_rows = await session.execute(

    select(KbAiInvokeLog.scene, func.count(),

           func.coalesce(func.sum(KbAiInvokeLog.success_flag), 0),

           func.coalesce(func.sum(KbAiInvokeLog.total_tokens), 0))

    .where(KbAiInvokeLog.created_time >= month_start)

    .group_by(KbAiInvokeLog.scene)

)
四、日志:一条链路能串起来
每个请求生成一个 requestId,并解析上游的 W3C traceparent 拿到 traceId;出站调用模型、认证中心时再把两个头带下去。日志格式支持 text 和 json,json 一行一个事件,方便接 Loki/ELK。
class ContextFilter(logging.Filter):

    def filter(self, record):

        record.request_id = current_request_id()

        record.trace_id = current_trace_id()

        ctx = get_context()

        record.tenant_id = ctx.tenant_id if ctx else None

        record.user_id = ctx.user_id if ctx else None

        return True
访问日志由中间件统一打,关掉 uvicorn 自带的那份,避免重复且缺 ID。健康检查路径不记访问日志,否则探针每 30 秒一次会把真正的请求淹掉。日志里不记 query string,因为 SSE 和下载会把 satoken 放在查询参数里。
五、Docker:镜像不内置 .env
用多阶段构建:第一层只装依赖,第二层拷贝代码。依赖层缓存住,改业务代码不会重新装包。
FROM python:3.14-slim AS builder

RUN pip install --no-cache-dir uv==0.12.20

WORKDIR /app

COPY pyproject.toml uv.lock ./

RUN uv sync --frozen --no-dev --no-install-project

FROM python:3.14-slim

WORKDIR /app

COPY --from=builder /app/.venv ./.venv

COPY app ./app

USER 10001:10001

EXPOSE 18015

CMD ["/app/.venv/bin/uvicorn", "app.main:app", \

     "--host", "0.0.0.0", "--port", "18015", "--workers", "1"]
单 worker 不是偷懒:APScheduler 跑在进程内,多 worker 会重复执行定时任务。多副本部署时,只留一个副本开 KB_SCHEDULER_ENABLED=true,或者把调度器拆成独立进程。
docker build -t kb-api:latest .

docker run -d --name kb-api --restart unless-stopped \

  --env-file /opt/kb-api/.env -p 127.0.0.1:18015:18015 kb-api:latest
如果 .env 在 Windows 上编辑过,先去掉 CRLF,否则 --env-file 会把 \r 带进变量值:
sed -i 's/\r$//' /opt/kb-api/.env六、上线前检查清单
- 建表: 目标库已执行
docs/sql/kb_schema.sql,vector和pg_trgm扩展都装好。 - 密钥: 生产用环境变量注入,轮换 dev 明文凭据;
.env不进镜像。 - 调度: 单副本开调度,多副本只留一个;Redis 锁只在本服务副本间互斥。
- Nginx: SSE 路径关缓冲,下载/预览允许大响应;认证头
satoken透传。 - 监控:
/healthz探活,日志按traceId聚合,AI 流水的失败率单独告警。 - 数据: PostgreSQL 定期备份;向量表可以从切片重建,但原文和业务表不可丢。
七、这套系统还能怎么进化
- 关键词检索: 数据量大后加 pg_trgm/GIN 或独立搜索引擎,替换全表 ILIKE。
- 解析: 需要处理扫描件时接入 OCR,再谈表格结构还原。
- 检索质量: 开启 LLM 重排,补一套离线评测集,用命中率和答案正确率说话。
- 可观测: 给检索耗时、模型首 token 时间、失败率加指标看板。
写在最后
9 篇走下来,这套系统没有特别“黑科技”的东西:把上传、解析、切片、向量、检索、回答拆开,每一步都做得可解释、能回退、能补偿。知识库的门槛不在“调模型”,而在“找资料”和“说清楚”。
代码在仓库 ai-python/kb-api,启动只需要 uv sync 加 uv run python dev.py。希望这个系列能帮你少踩几个坑。
上一篇:Agent 与多轮记忆








