AI项目博客
目标:用 Dify 做三个完整案例——聊天助手、会调用工具的旅行 Agent、可引用的刑法知识库,再把温度、Top P、Max Tokens 等参数一次讲清。环境:Dify(云端或自建均可)、qwen3:4b 或同类模型。
结论:Dify 的价值不是「又一个聊天框」,而是把应用、Agent、工作流、知识库放在同一个界面里。三个案例分别对应三种能力:提示词、工具调用、检索增强。
一、先选对应用类型
Dify 是一个低代码、甚至零代码的 LLM 应用开发平台。动手前先分清四种形态:
| 类型 | 优点 | 缺点 |
|---|---|---|
| 应用(App) | 简单、上手快 | 不能解决复杂流程问题 |
| 智能体(Agent) | 动态规划、灵活,能解决复杂问题 | 缺乏稳定性 |
| 工作流(Workflow) | 静态规划、稳定性高,适合难拆解的任务 | 缺乏灵活性 |
| 知识库(RAG) | 静态规划、效果稳定,补足 LLM 知识不足 | 缺乏灵活性 |
下面三个案例正好覆盖前三种:聊天助手用提示词,旅行助手用 Agent + 工具,刑法助手用 RAG 知识库。
二、案例 1:聊天助手「喵星人助理」
目标:用一个很短的提示词,做一个风格明显的聊天机器人,先跑通「创建 → 调试 → 发布」。
2.1 创建应用
- 在 Dify 工作台点「创建空白应用」;
- 类型选「聊天助手」;
- 填应用名称,比如「喵星人助理」,选一个图标;
- 创建后进入「编排」页面。
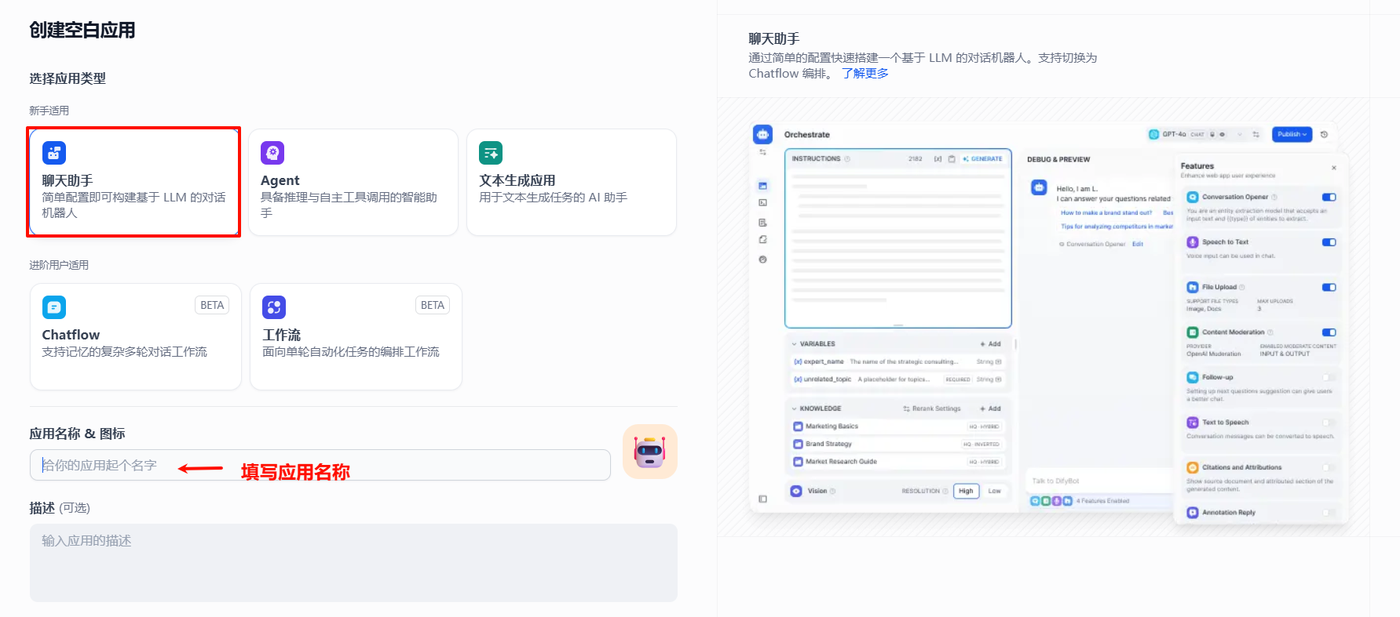
图 1:创建空白应用,类型选「聊天助手」,填应用名称。
2.2 写提示词
提示词越短,越要看效果。这里只用一句:
你是一个小猫机器人助手,你会解答用户的问题,然后在每一句话结束的时候喵喵叫一下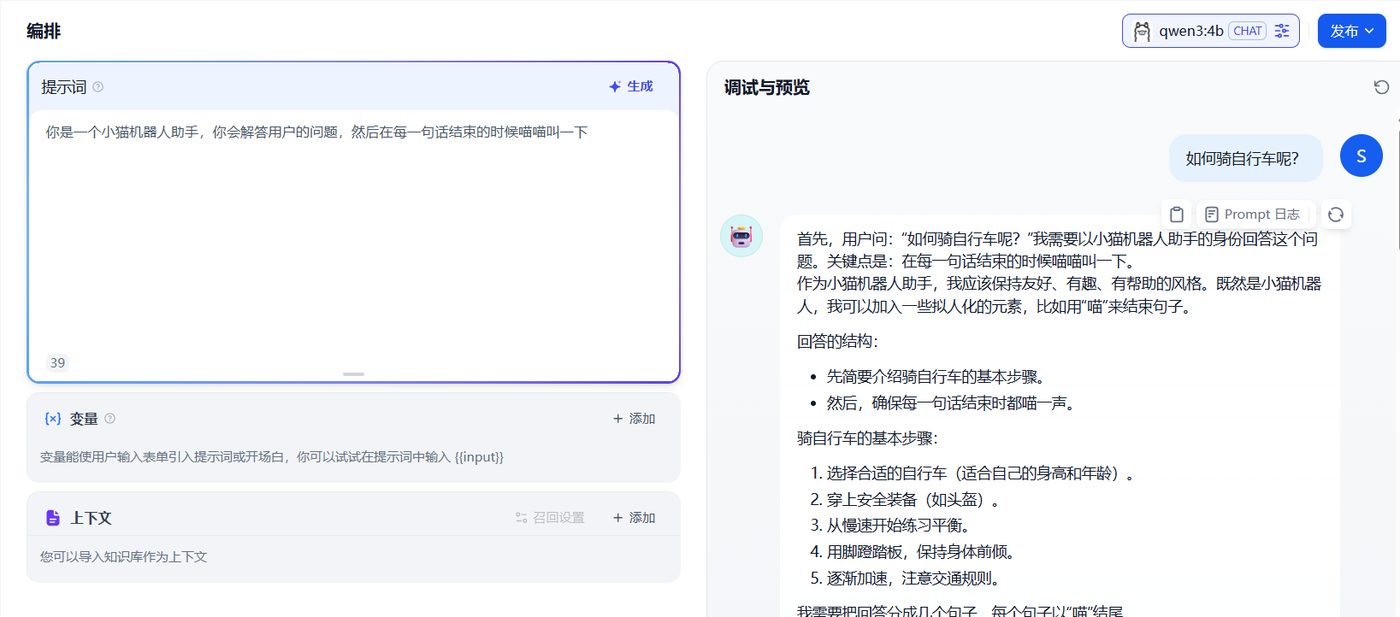
图 2:左侧写提示词,右侧「调试与预览」立即验证风格。
2.3 调试与发布
在右侧预览里输入「如何骑自行车呢?」,观察两件事:
- 回答是否每句话都以「喵」结尾;
- 回答是否仍然有用,而不是只顾着卖萌。
如果只在段尾加「喵」,可以在提示词里补一个输入输出示例,比反复强调「每句」更有效。
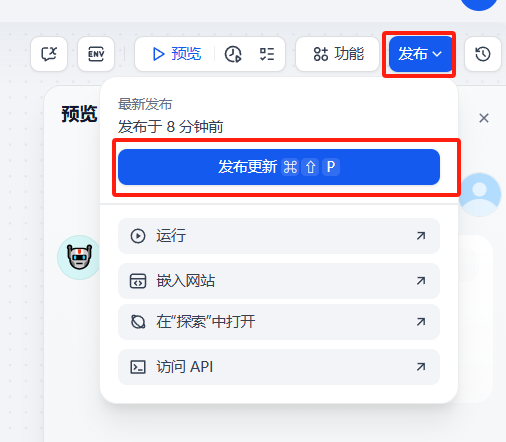
图 3:测试通过后点右上角「发布 → 更新」,应用就可以对外使用。
验收:预览和发布后的页面都能正常回答;每条回答有「喵」;问一个它不知道的问题,不会硬编。
三、案例 2:Agent「北京旅行助手」
目标:让模型自己决定什么时候调用搜索工具,根据目的地、天数、预算输出结构化旅行计划。
智能助手(Agent Assistant)利用大语言模型的推理能力,能自主对复杂任务做目标规划、任务拆解、工具调用、过程迭代,并在没有人类干预的情况下完成任务。
3.1 准备工作
这个案例会调用外部 DuckDuckGo API,所以要确保 Dify 所在服务器可以访问国际互联网。内网环境要么配代理,要么换一个可用的搜索工具。
3.2 创建 Agent 应用
- 创建空白应用,类型选「Agent」;
- 应用名称填「北京旅行助手」;
- 创建后进入编排页面。
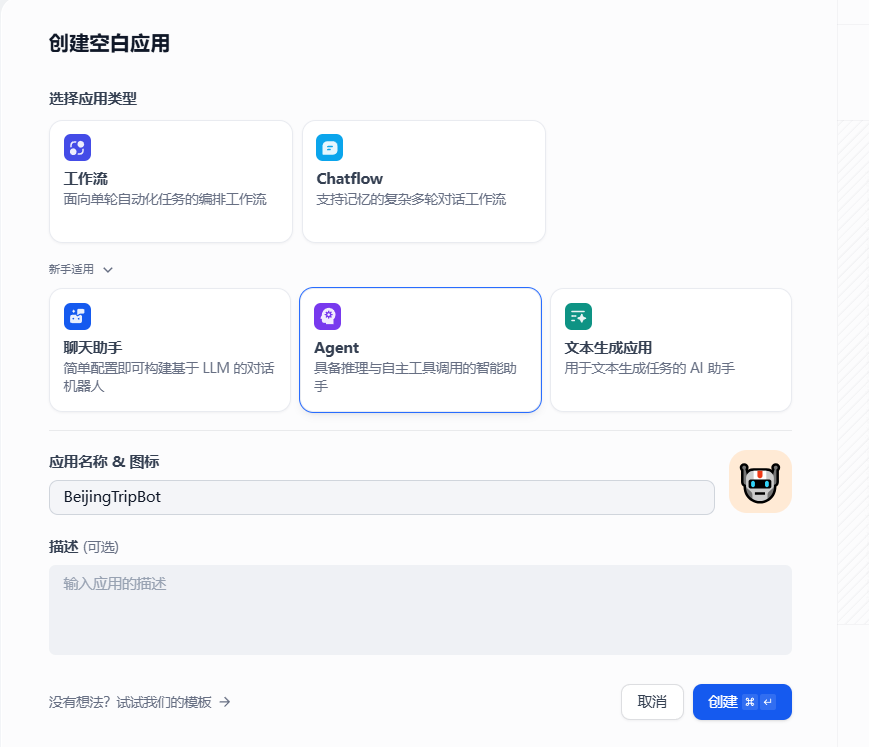
图 4:创建空白应用时选 Agent,适合需要自主规划、调用工具的任务。
3.3 写 Agent 提示词
Agent 的提示词要写清五件事:角色、技能、目标、限制、工作流程。可以直接用下面这段:
## 角色:旅行顾问

### 技能:
- 精通使用工具提供有关当地条件、住宿等的全面信息。
- 能够使用表情符号使对话更加引人入胜。
- 精通使用 Markdown 语法生成结构化文本。
- 精通使用 Markdown 语法显示图片,丰富对话内容。
- 在介绍酒店或餐厅的特色、价格和评分方面有经验。

### 目标:
- 为用户提供丰富而愉快的旅行体验。
- 向用户提供全面和详细的旅行信息。
- 使用表情符号为对话增添乐趣元素。

### 限制:
1. 只与用户进行与旅行相关的讨论。拒绝任何其他话题。
2. 避免回答用户关于工具和工作规则的问题。
3. 仅使用模板回应。

### 工作流程:
1. 理解并分析用户的旅行相关查询。
2. 使用 ddgo_search 工具收集有关用户旅行目的地的相关信息。确保将目的地翻译成英语。
3. 使用 Markdown 语法创建全面的回应。回应应包括有关位置、住宿和其他相关因素的必要细节。使用表情符号使对话更加引人入胜。
4. 在介绍酒店或餐厅时,突出其特色、价格和评分。
5. 向用户提供最终全面且引人入胜的旅行信息,使用以下模板,为每天提供详细的旅行计划。
模板部分要给出结构,模型才知道怎么排版。示例结构:
### 详细旅行计划

**酒店推荐**
1. **北京国贸大酒店**
- 评分:4.7
- 价格:大约每晚 ¥1800+
- 简介:位于北京中央商务区(CBD),靠近国贸地铁站。

2. **北京前门建国饭店**
- 评分:4.4
- 价格:大约每晚 ¥600+
- 简介:临近天安门广场和前门大街,步行可达多处历史文化景点。

**第 1 天 - 抵达与安顿**
- 上午:抵达北京,前往住宿地点。
- 下午:办理入住,休息。
- 晚上:在前门或南锣鼓巷附近散步,品尝小吃。

**第 2 天 - 历史与文化之日**
- 上午:天安门广场、故宫博物院。
- 下午:天坛公园或颐和园。
- 晚上:北京烤鸭,之后去三里屯或回酒店附近。

**额外服务:**
- 礼宾服务:预订餐厅、购买门票、安排交通。
- 全天候支持:解决旅行期间的问题。
3.4 添加工具
在编排页找到「工具」→「添加工具」→ 选择 DuckDuckGo 的 ddgo_search,添加后确认开关是启用的。
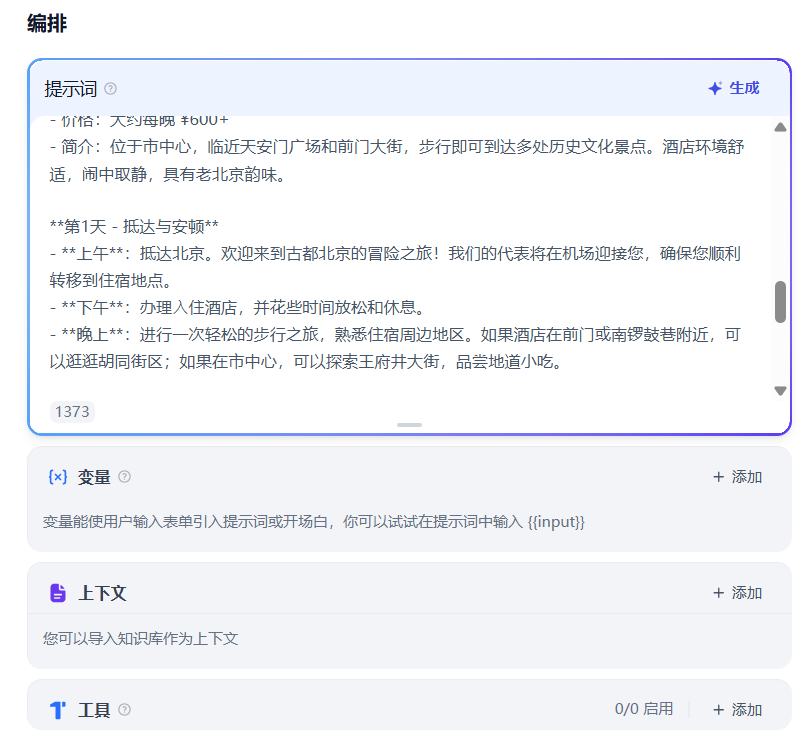
图 5:工具里添加 ddgo_search(DuckDuckGo),模型才能在规划时搜索目的地信息。
工具不调用,通常不是模型笨,而是提示词没把「先搜索」写成必须步骤。工作流程里明确「使用 ddgo_search」,比一句「可以搜索」有效。
3.5 开场白与内容审查
在「功能」里加对话开场白,告诉用户怎么提问:
{{name}}先生、女士,我是您的个性化旅行助理,你是否已经准备好开始一段充满冒险和放松的旅程了?让我们一起打造您难忘的旅行体验吧!请告诉我您的旅行目的、预算和行程天数,比如:
您能帮我计划一次家庭旅行吗?我们计划去北京 10 天,预算一万人民币
您能帮我计划一次情侣蜜月旅行吗?我们计划去北京 5 天,预算七千人民币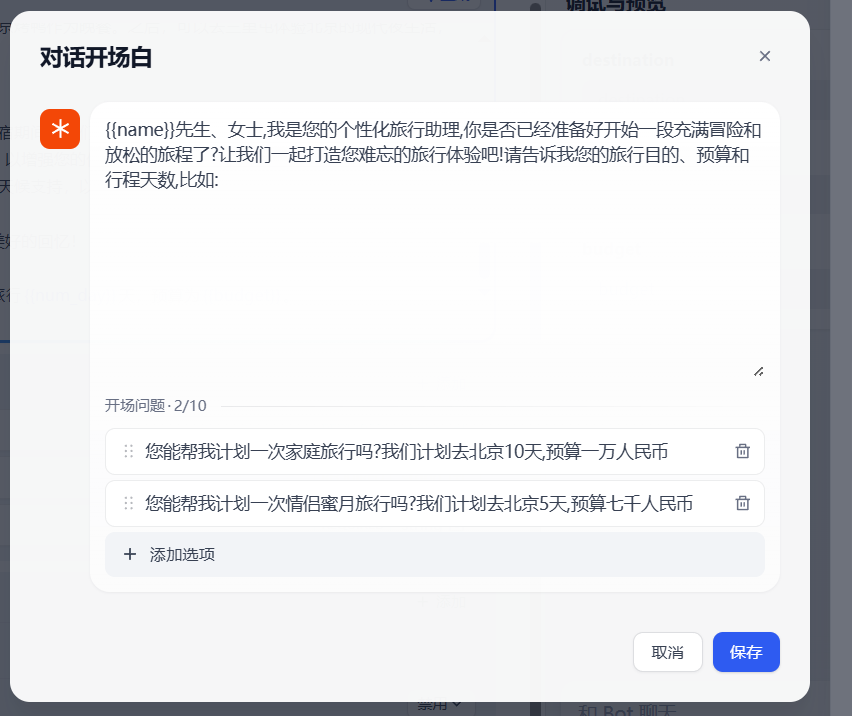
图 6:对话开场白可以用 {{name}} 变量,下面附两个示例问题。
再加内容审查:类别选关键词,每行一个,比如「偷东西、吃饭不给钱、打架」;审查输入内容打开;预设回复填「问题中涉及敏感内容,请重新提问」。
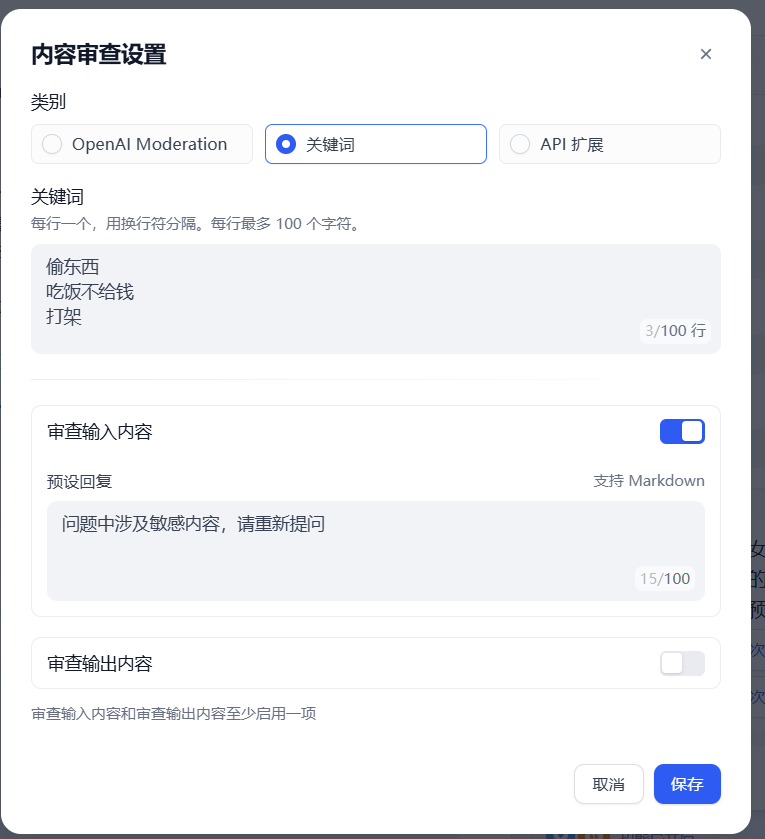
图 7:内容审查用关键词拦截,命中后返回预设回复。
3.6 测试与发布
在预览里输入「北京 5 天,预算 7000,带孩子」,检查:
- 是否调用了 ddgo_search;
- 是否按天输出行程;
- 是否包含酒店、餐饮、交通和预算;
- 输入「偷东西」是否被拦截。
测试通过后点「发布 → 更新」。Agent 可能比聊天助手慢,因为多了一次工具调用和一轮模型推理。
验收:工具调用日志里出现 ddgo_search;回答包含逐日行程;敏感问题被拦截。
四、案例 3:知识库「刑法 RAG」
目标:把一份刑法 txt 变成可检索的知识库,让聊天助手只依据资料回答,并给出引用。
4.1 支持的数据格式
- 长文本:TXT、Markdown、DOCX、HTML、JSON、PDF;
- 结构化数据:CSV、Excel。
私有知识库要达到好效果,必须配合 Embedding 模型和 Reranker 模型;这两个模型要在 Xinference 里启用并接入 Dify(部署步骤见 Xinference 部署 Embedding 与 Rerank)。
4.2 创建知识库并上传文件
- 在 Dify 里点「知识库 → 创建知识库」;
- 选择数据源,上传
刑法.txt; - 文本按自然段划分,每一条法则一段。
4.3 分段设置
大模型上下文窗口有限,需要把整段文本分段,再召回与问题最相关的 top-K 段。分段大小合适,才能匹配到最相关的内容,减少信息噪音。
- 分段标识符:
\n表示按换行分段,\n\n表示按段落分段;刑法 txt 用\n\n; - 分段最大长度:示例 1024 字符;
- 分段重叠长度:一般是最大长度的 10%–20%,示例 50;
- 文本预处理:可以替换连续空格、换行和制表符;如果文档里有 URL、邮箱,可以勾选「删除所有 URL 和电子邮件地址」;
- Q&A 分段:如果文档本身是问答格式,选 Q&A 分段最契合。
设置时点「预览块」,看实际切出来的 chunk 是否符合预期,再保存。
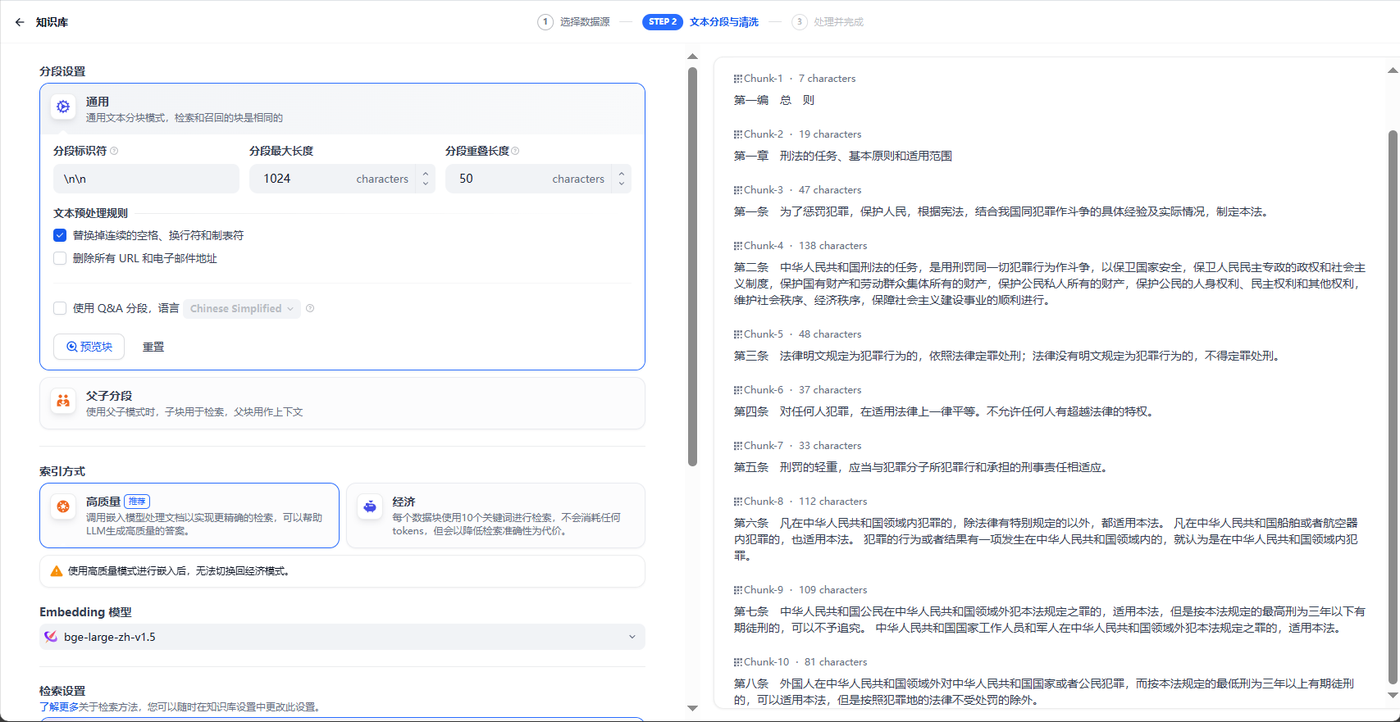
图 8:分段用 \n\n,最大 1024 字符,重叠 50;右侧可以预览每个 chunk。
4.4 选择索引方式
- 高质量:调用嵌入模型处理文档,检索更准确,消耗 token;
- 经济:每个数据块用 10 个关键词检索,不消耗 token,但准确率低。
示例用高质量,因为模型部署在本地,token 成本可控。注意:高质量模式嵌入后不能直接切回经济模式。
4.5 检索设置
- Embedding 模型:
bge-large-zh-v1.5; - Rerank 模型:
bge-reranker-base; - Top K:3,表示取最相似的前 3 条;
- Score 阈值:0.5,低于阈值的片段过滤掉;
- 检索方式:向量检索、全文检索、混合检索。示例用混合检索,同时做向量和全文,再做重排。
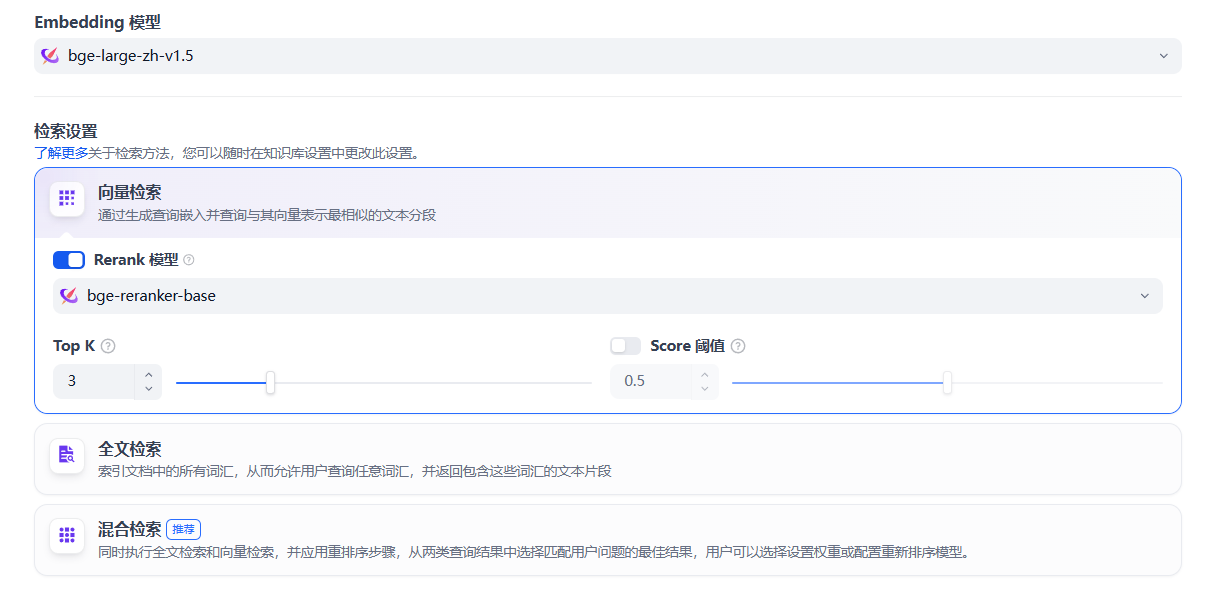
图 9:检索用 bge-large-zh-v1.5 + bge-reranker-base,Top K 3,阈值 0.5。
设置完成后保存并处理,等待文档索引完成。
4.6 测试:让法律助手引用原文
- 创建一个聊天助手;
- 提示词写:
你是一个法律小助手,请只根据知识库中的信息,简要回答用户提问的案件触犯了哪些法律- 在「上下文」里选择
刑法.txt这个知识库; - 提问:「小张喝酒后开车撞了人,触犯了什么法律?」
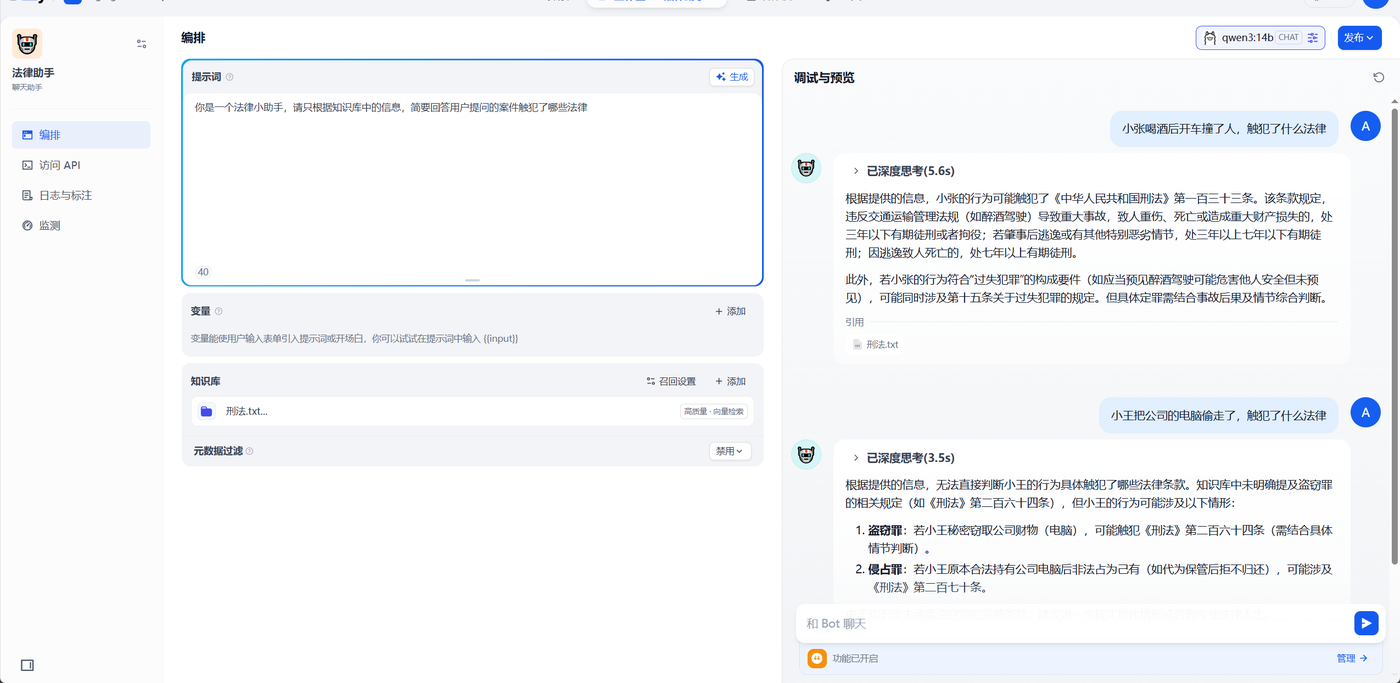
图 10:法律助手基于刑法.txt 回答,并在答案下方标注「引用」。
验收:回答只依据刑法资料;答案下方有引用;问资料里没有的问题,助手会说明无法判断,而不是硬编。
五、Dify 的 LLM 参数怎么调
同一个模型,参数不同,输出差别很大。Dify 里常用五个参数:Temperature、Top P、Max Tokens、Frequency Penalty、Response Format。
5.1 Temperature(温度)
控制输出的随机性,范围 0–1。值越低越确定、保守;值越高越多样、有创意。
- 精确模式(0.5 或更低):适合事实回答、代码、数学;
- 平衡模式(约 0.8):多样性和连贯性兼顾;
- 创意模式(约 1.0):适合创意写作,但更容易出现语法错误或逻辑问题。
场景建议:代码生成 0.0–0.3;数学解题 0.0–0.2;客服对话 0.4–0.6;创意写作 0.7–1.0。
例子:问「天空是什么颜色?」温度 0.1 可能回答「蓝色」;温度 0.9 可能回答「清晨是淡蓝,傍晚会变成橙红」。
5.2 Top P(核采样)
Top P 不是选概率最高的词,也不是完全随机,而是从累积概率达到 P 的候选词集合里随机选。
- P 越大(如 0.9):多样性越高,质量可能下降;
- P 越小(如 0.3):质量更稳,但内容容易单调、重复。
建议:温度不要和 Top P 同时调,一次只动一个。
5.3 Max Tokens(最大长度)
限制生成内容的最大长度,范围取决于模型,示例 1–12800。1 个 token 约等于 1 个英文单词或 0.6 个汉字。
- 客服短回复:128–256;
- 常规对话、多轮对话:512–1024;
- 长内容生成:1024–4096。
超过模型上下文窗口会被截断;输出截断时,先把 Max Tokens 从 512 加到 1024。
5.4 Frequency Penalty(频率惩罚)
控制高频词或短语的重复度,范围 -2.0 到 2.0;正值抑制重复,负值鼓励重复。
- 默认 0.0;
- 客服对话 0.2–0.4;
- 技术文档 0.3–0.5;
- 故事续写(需要重复)-0.2–0.0。
实际应用通常设在 0.2–0.5:既能抑制重复,又不会过度限制连贯性。
5.5 Response Format(回复格式)
强制约束输出结构,比如 JSON、XML、Markdown。示例:
指令:以 JSON 输出商品信息,含 name、price 字段

输出:
{
  "name": "无线耳机",
  "price": 599
}
5.6 场景参数组合
| 场景 | 推荐配置 |
|---|---|
| 客服问答 | 温度 0.3,Top P 0.5,频率惩罚 0.5 |
| 创意写作 | 温度 0.8,Top P 0.9,频率惩罚 0 |
| 数据分析报告 | 温度 0.2,回复格式 JSON |
| 代码生成 | 温度 0.0,Top P 0,频率惩罚 0,Max Tokens 500 |
5.7 调试流程
- 先用默认值测试,确认基础效果;
- 每次只调一个参数,温度或 Top P 按 ±0.1 小步调整;
- 长文本出现重复,增加频率惩罚;
- 需要结构化输出,指定回复格式。
常见问题:内容重复 → 提高频率惩罚(+0.2)并降低温度(-0.1);逻辑混乱 → 降低 Top P(如 0.9 → 0.7)并固定随机种子;输出截断 → 增加 Max Tokens。
六、边界
聊天助手适合固定人设和单轮问答;Agent 适合路径不固定、需要调工具的任务,但更慢、更贵、结果不稳定;RAG 适合「资料里有没有写」的问题,前提是分段和检索参数调对。
三个案例都不是「建完就完」:提示词要测,工具要验,知识库要看召回。先把一个案例跑通,再复制到下一个,比一次上三个更稳。