
 AI项目博客
「企业级大模型私有化部署」系列第 4 篇。目标:在第二台 GPU 服务器上装 Xinference,部署 bge-large-zh-v1.5 和 reranker,再通过 6007 隧道接进 Dify。
结论:RAG 的效果不只看大语言模型。向量化决定了能不能召回,Rerank 决定了召回的片段排得对不对;这两个模型用 Xinference 管,比用 Ollama 更稳。
一、Xinference 是什么
Xinference 是一个强大且通用的分布式推理框架,可以用于私有化部署和运行大语言模型,也支持嵌入、重排、多模态等模型。它简化了各种 AI 模型的运行和集成,让开发者可以在云端或本地环境运行、推理,创建 AI 应用。
这套方案里,Xinference 只做两件事:
- Embedding:把切片变成向量,写进向量库;
- Rerank:把初步召回的候选片段重新排序,提高相关性。
Ollama 强在大语言模型的本地运行,对 Embedding 和 Rerank 的支持有限;Xinference 对这两类模型更完整,所以单独放在 GPU 服务器 B。
二、登录 GPU 服务器 B
用 XShell 或 FinalShell 连接第二台 AutoDL 实例:
- 主机:AutoDL 控制台复制的 SSH 地址;
- 端口:控制台分配的端口;
- 用户名:
root; - 密码:控制台复制的密码。
首次连接输入 yes 保存指纹。登录后先开学术加速:
source /etc/network_turbo学术加速只对当前终端有效,新开终端要重新执行。
三、安装 Xinference
先升级 pip,再装 1.5.0。最新版可能和部分依赖冲突,先固定一个能跑通的版本:
python -m pip install --upgrade pip
pip install 'xinference==1.5.0'
安装 PyTorch。先装一个基础版本,再按 CUDA 11.8 升级:
pip install -i https://pypi.tuna.tsinghua.edu.cn/simple torch
pip install --upgrade torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118
装完确认 CUDA 可用:
python -c "import torch; print(torch.cuda.is_available())"返回 True 再继续。返回 False 说明驱动、CUDA 或 PyTorch 版本不匹配,先解决这个,不要急着启动模型。
启动 Xinference:
xinference-local --host 0.0.0.0 --port 6006AutoDL 只开放 6006,所以服务监听 6006;外部通过隧道访问。
四、Windows 上访问 Xinference
在 Windows 上用 AutoDL 的隧道工具,把本地 6006 映射到 GPU 的 6006:
- 下载 AutoDL 的 SSH 隧道工具;
- 粘贴 SSH 指令和密码;
- 代理到本地端口填 6006;
- 打开
http://127.0.0.1:6006。
看到 Xinference 的 Web UI 就说明隧道通了。
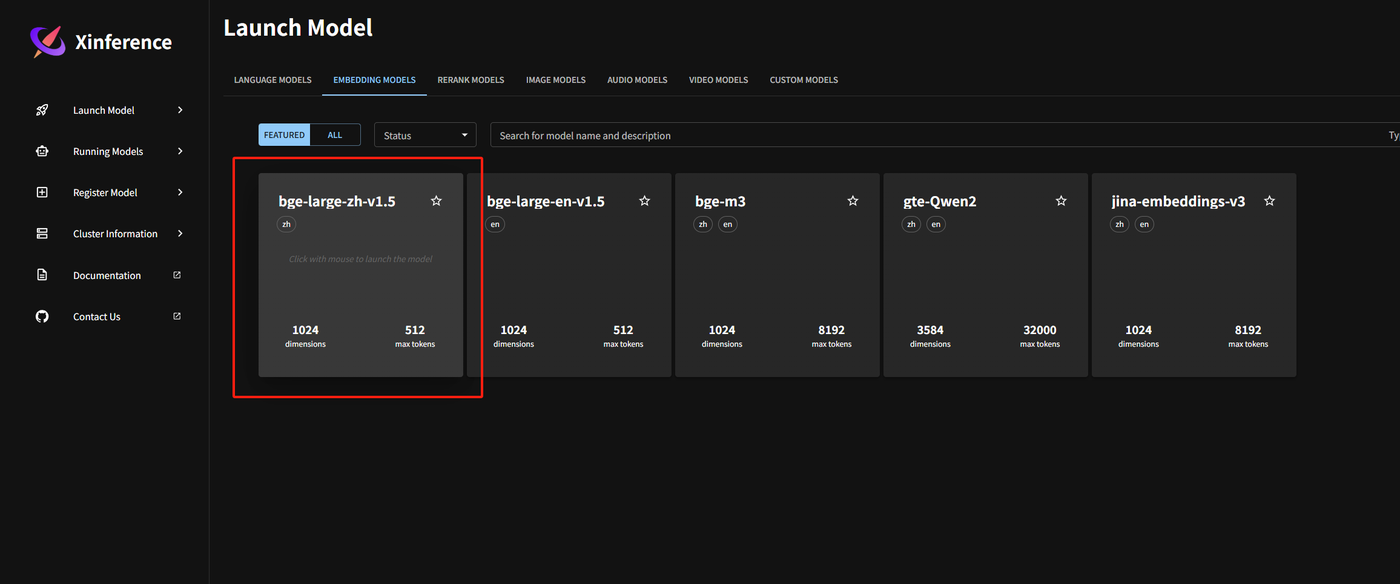
图 1:Xinference 的 Launch Model 页面,Embedding 模型里能看到 bge-large-zh-v1.5。
五、部署 Embedding 模型
在 Launch Model → EMBEDDING MODELS 里选 bge-large-zh-v1.5,点开后确认参数:
- Replica:1;
- Device:GPU;
- GPU Idx:0(单卡);
- Worker Ip:单机留空;
- Model UID:默认
bge-large-zh-v1.5,不要改; - Download hub:按网络情况选 HuggingFace 或其他镜像;
- Model Path:用默认下载路径,或填本地模型目录。
点启动后,到 Running Models → EMBEDDING MODELS 里确认状态。bge-large-zh-v1.5 是 1024 维、512 max tokens,这两个数字后面在 Dify 里要对得上。
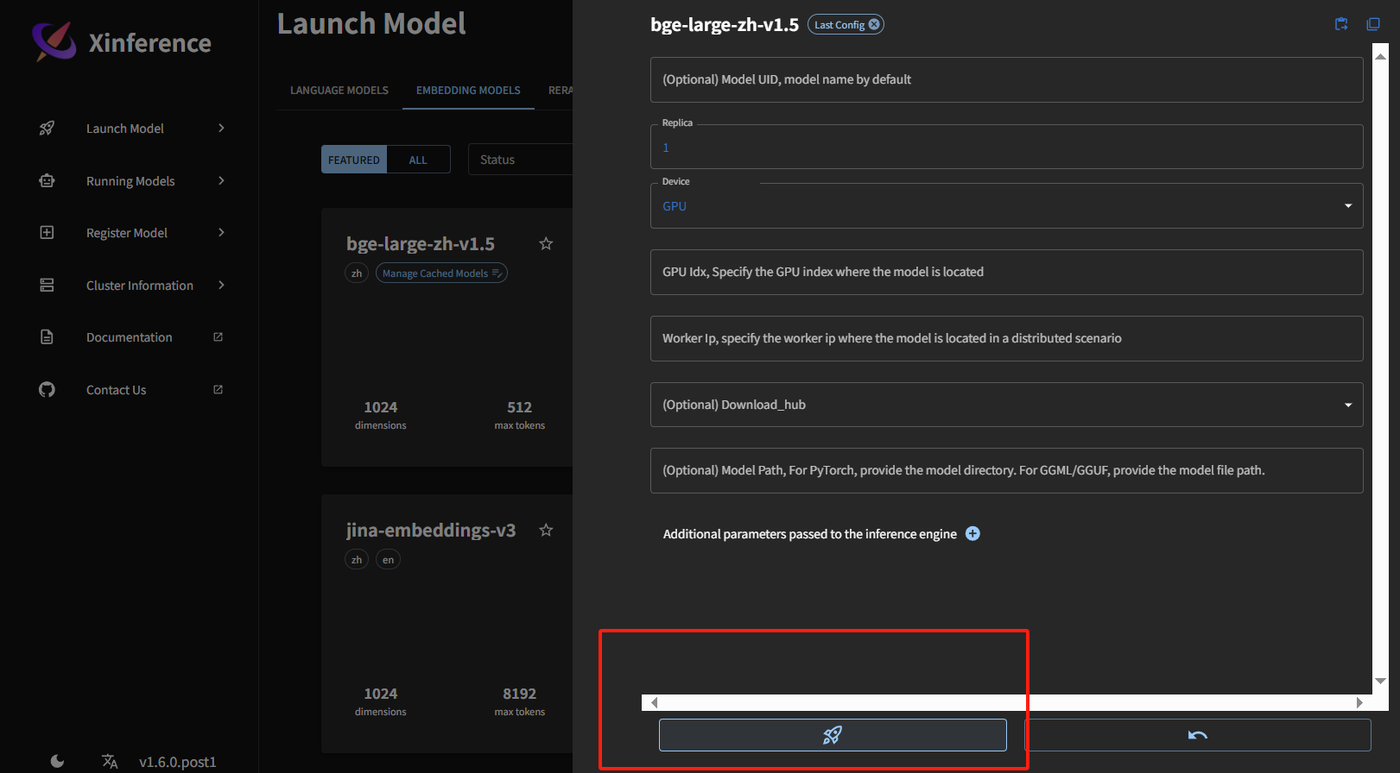
图 2:Xinference 启动 bge-large-zh-v1.5:1024 维、512 max tokens。
六、部署 Rerank 模型
再下 Rerank 模型,比如 bge-reranker-base 或 bge-reranker-large,在 Launch Model → RERANK MODELS 里启动。
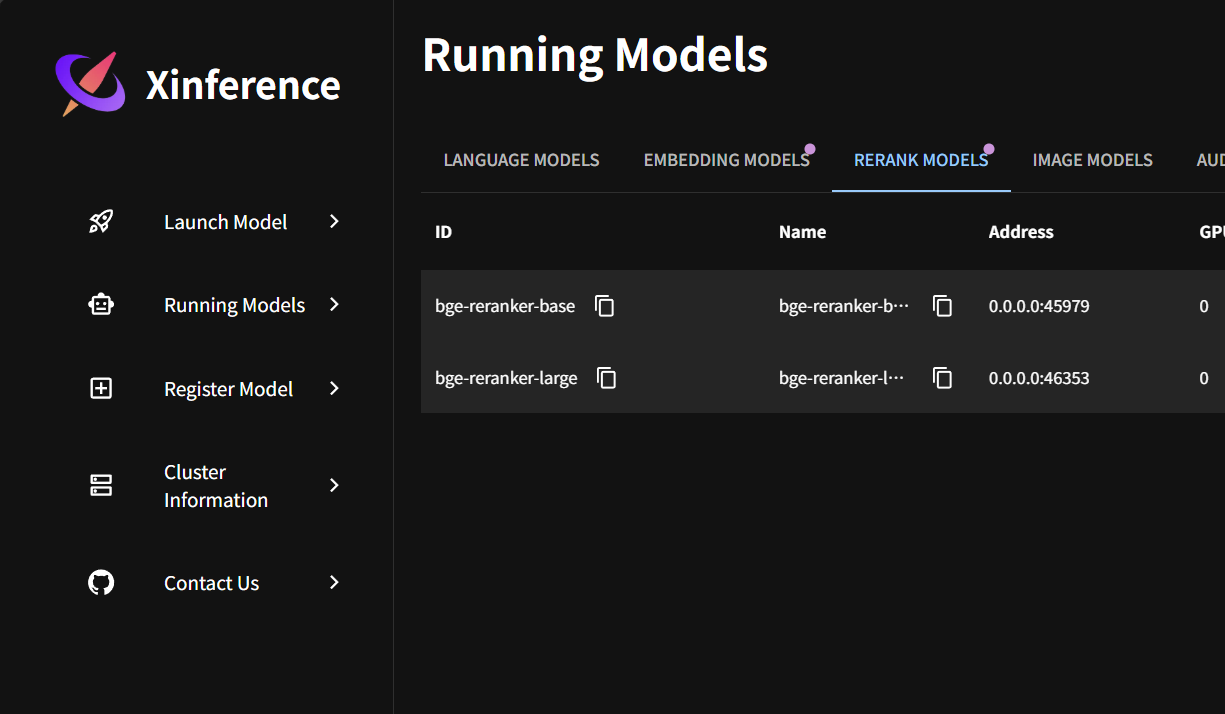
图 3:Xinference 的 Rerank 模型列表,bge-reranker-base / large。
Rerank 不是越多越好。它会对每个候选片段做一次打分,top-k 越大、延迟越高;先用 top 20 左右,观察效果和耗时,再决定要不要加。
七、xoscar 兼容问题
如果启动模型时报:
Server error: 500 - [address=0.0.0.0:51032, pid=12889] MainActorPool.append_sub_pool() got an unexpected keyword argument 'start_method'是 xoscar 版本不兼容。降级到 0.6.2,补依赖后重启 Xinference:
pip install xoscar==0.6.2
pip install sentence-transformers sentencepiece transformers torch
xinference-local --host 0.0.0.0 --port 6006
重启后回到 Web UI,重新启动模型;如果模型还在 Running Models 里,先停掉再启动。
八、把 6007 隧道打到 Dify 服务器
Dify 服务器上的 6006 已经被 Ollama 占用,所以 Xinference 用 6007:
ssh -CNg -L 6007:127.0.0.1:6006 root@<AutoDL SSH地址> -p <端口>在 Dify 服务器上测试:
curl http://127.0.0.1:6007/v1/models返回模型列表,说明隧道和 Xinference 都通了。如果没有返回,先查隧道进程,再查 GPU 上的 Xinference 服务。
九、在 Dify 里接入 Xinference
Dify:设置 → 模型供应商 → 安装 Xorbits Inference(Xinference 的供应商插件)。
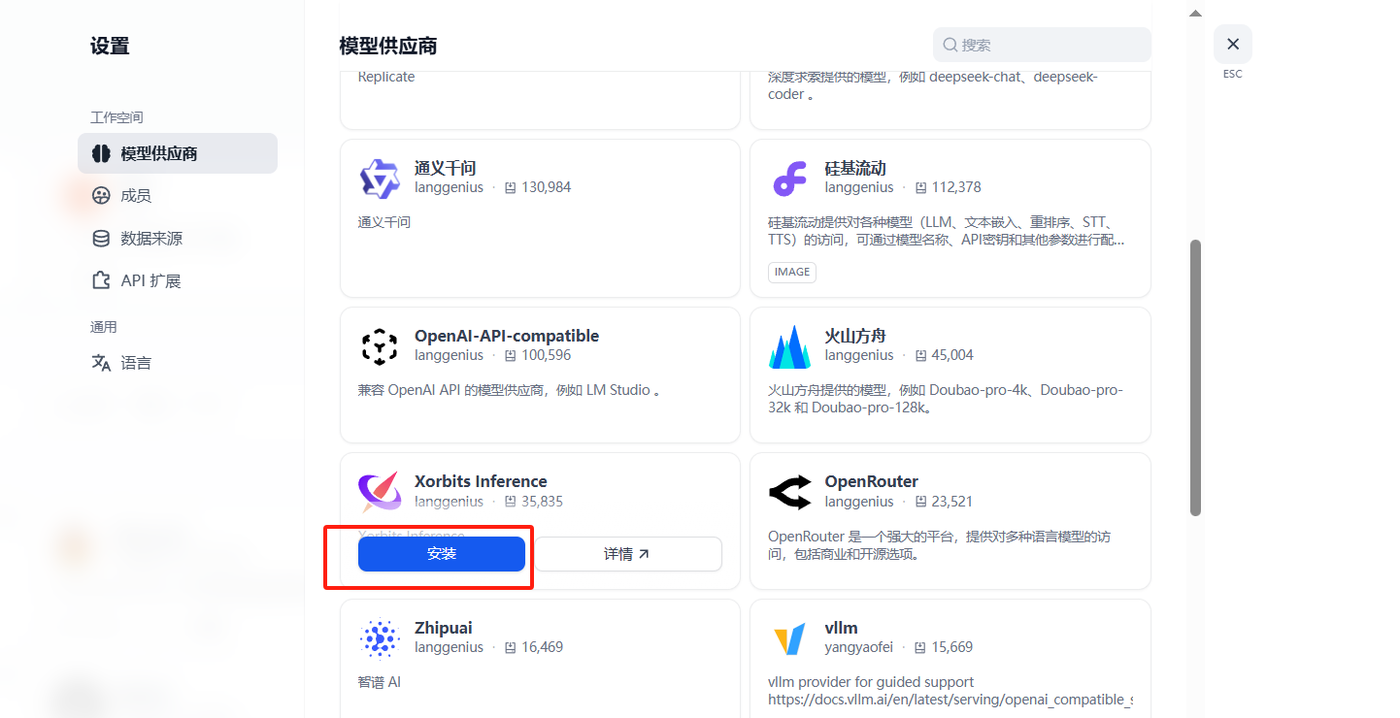
图 4:Dify 里安装 Xorbits Inference 供应商,接 Xinference 的嵌入与重排。
然后添加模型:
- Embedding:模型名和 UID 填
bge-large-zh-v1.5,上下文 512; - Rerank:模型名和 UID 填
bge-reranker-base或你下载的版本; - Base URL:
http://<Dify服务器内网IP>:6007。
名称和 ID 必须跟 Xinference 里完全一致,大小写、连字符都不能改。保存后到模型列表里确认开关是开的。
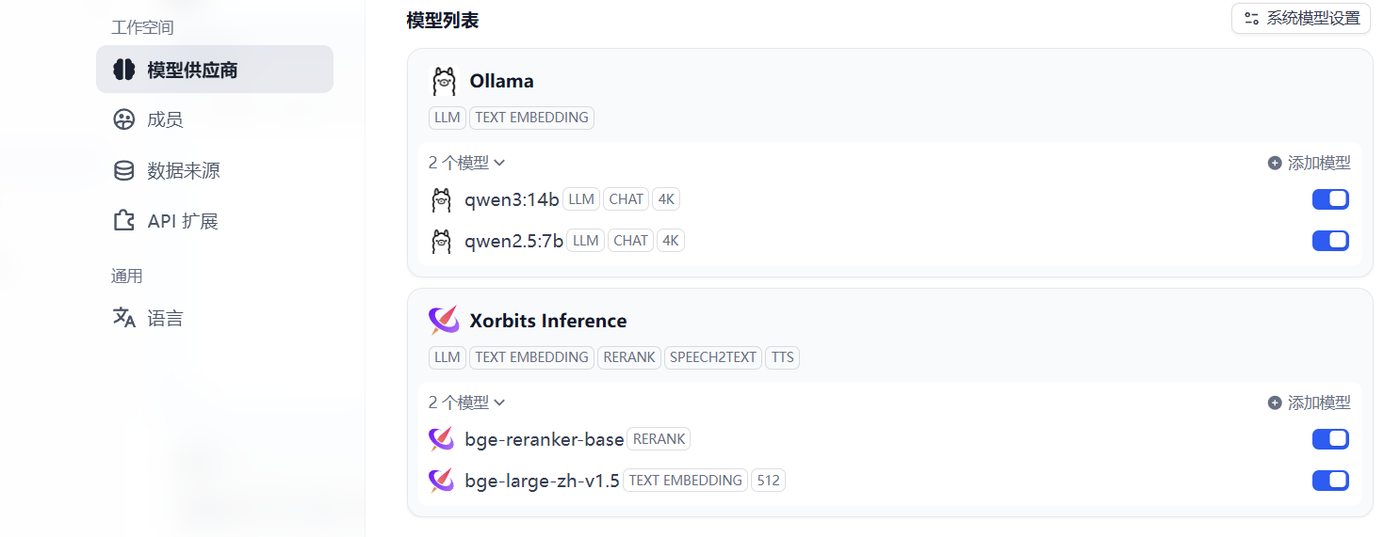
图 5:Dify 里最终能看到两组模型:Ollama 的 qwen3:4b,以及 Xorbits Inference 的 bge-large-zh-v1.5 和 bge-reranker-base。
十、验收
- Xinference 的 Running Models 里有 bge-large-zh-v1.5 和 reranker;
- Dify 服务器上
curl http://127.0.0.1:6007/v1/models有返回; - Dify 模型供应商里两个模型都能看到,开关是开的;
- 建一个知识库,上传文档,检索能出切片;
- 打开 Rerank,问一个跨段落的问题,对比开/关时引用片段的相关性。
如果 Dify 里看不到模型,先查 6007 隧道,再查模型 UID 是否和 Xinference 完全一致。Rerank 不生效时,检查知识库的检索设置里是否真的选中了 rerank 模型。
十一、常见报错与处置
| 现象 | 原因 | 处置 |
|---|---|---|
启动报 start_method |
xoscar 版本不兼容 | pip install xoscar==0.6.2 后重启 |
| 模型下载失败 | 网络或下载源不可达 | 开学术加速;换下载源;重试 |
| Dify 里模型名对不上 | UID 改过,或大小写不一致 | 用 Xinference 里的原始 UID,逐字对齐 |
| 6007 隧道起不来 | 本地 6007 被占用 | 换一个本地端口,Dify 里同步改 |
| Rerank 很慢 | 候选片段太多 | 降 top-k;换更小的 reranker;按场景决定是否开启 |
| 显存不足 | embedding 和 rerank 同时占卡 | 错峰启动;换小模型;加显存 |
| Dify 用 127.0.0.1 连不上 | 容器内的 127.0.0.1 不是宿主机 | Base URL 用 Dify 服务器内网 IP |
| 模型启动后立刻退出 | 依赖缺失或 CUDA 不匹配 | 看 Xinference 日志;补 sentence-transformers 等依赖 |
十二、成本与边界
Embedding 和 Rerank 模型比大语言模型小,但仍占显存。bge-large-zh-v1.5 和 reranker 同时跑,24GB 显存足够;并发上来后要观察显存和延迟。
Rerank 提升相关性,但增加一次模型调用和延迟。不是所有场景都需要开:知识库问答、客服系统值得开;对响应时间极敏感的场景可以先不开,或只对 top-k 较小的结果做重排。
十三、系列小结
四篇的主线:先看场景和拓扑,再起 Dify,接着用 Ollama 提供大语言模型,最后用 Xinference 提供 Embedding 和 Rerank。
三条链路接起来,Dify 里才能做出「能检索、能重排、能回答」的知识库应用。下一步:在 Dify 里建知识库,上传文档,先用 qwen3:4b + bge-large-zh-v1.5 跑通问答,再打开 Rerank 对比效果。

这个内容实在是太精彩啦