AI项目博客
大型语言模型(LLM)虽然强大,但有两个关键限制:
- 有限的上下文——它们无法一次性摄取整个语料库
- 静态知识——它们的训练数据在某个时间点被冻结
检索通过在查询时获取相关的外部知识来解决这些问题。这是**检索增强生成(RAG)**的基础:使用特定上下文的信息来增强 LLM 的回答。
知识库是用于检索的文档或结构化数据的存储库。
如果你需要自定义知识库,可以使用 Spring AI Alibaba 的文档加载器和向量存储从你自己的数据构建。
如果你已经有一个知识库(例如 SQL 数据库、CRM 或内部文档系统),你不需要重建它。你可以:
将其连接为 Agent 的工具用于 Agentic RAG
查询它并将检索到的内容作为上下文提供给 LLM(两步 RAG)
从检索到 RAG
检索允许 LLM 在运行时访问相关上下文。但大多数实际应用更进一步:它们将检索与生成集成以产生基于事实的、上下文感知的答案。
这是**检索增强生成(RAG)**的核心思想。检索管道成为结合搜索和生成的更广泛系统的基础。
检索流程
典型的检索工作流如下:
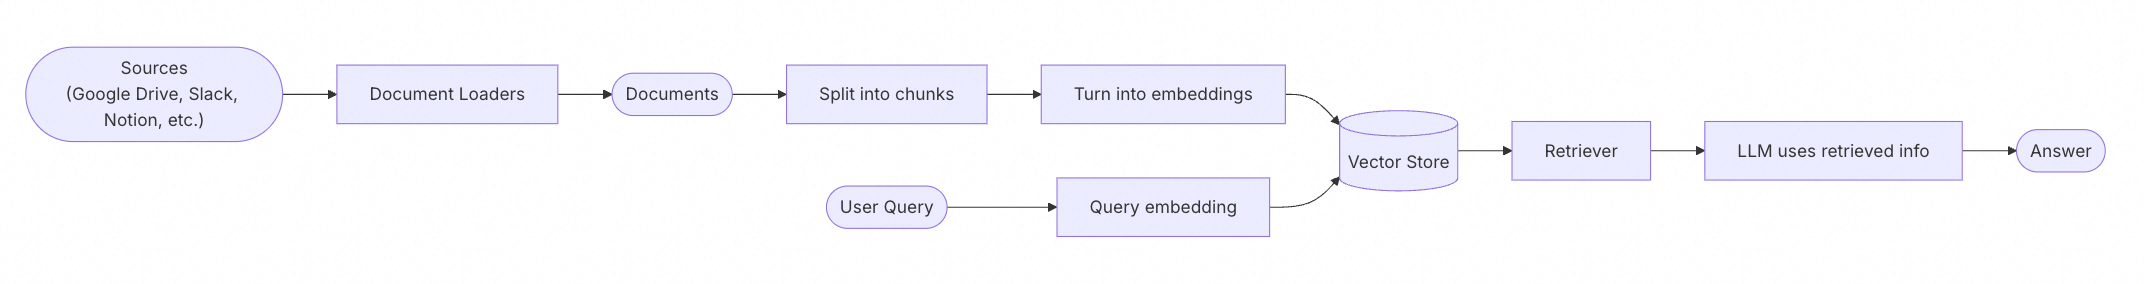
每个组件都是模块化的:你可以交换加载器、分割器、嵌入或向量存储,而无需重写应用程序的逻辑。
构建模块
在 Spring AI Alibaba 中,你可以使用以下组件构建 RAG 系统:
文档加载器和解析器
从外部源(文件、数据库、云存储、在线平台等)摄取数据,返回标准化的文档对象。Spring AI Alibaba 提供了丰富的 Document Reader 和 Document Parser 实现,支持 PDF、Word、Markdown、GitHub、Notion、语雀等多种数据源和格式。
文本分割器
将大型文档分解为更小的块,这些块可以单独检索并适合模型的上下文窗口。文本分割是 ETL 管道中的关键步骤,详见 ETL Pipeline。
嵌入模型
嵌入模型将文本转换为数字向量,使得具有相似含义的文本在向量空间中靠近在一起。Spring AI Alibaba 支持多种 Embedding Model 实现,包括 DashScope、OpenAI、Ollama 等。
向量存储
用于存储和搜索嵌入的专用数据库。Spring AI Alibaba 支持多种向量数据库,包括 Milvus、Pinecone、Redis、Elasticsearch 等。更多实现请查看 向量数据库文档。
检索器
检索器是一个接口,给定非结构化查询返回文档。Spring AI 提供了模块化的 RAG 架构,支持查询转换、查询扩展、文档后处理等高级功能,详见 Retrieval Augmented Generation。
RAG 可以以多种方式实现,具体取决于你的系统需求。我们在下面的部分概述每种类型。
| 架构 | 描述 | 控制性 | 灵活性 | 延迟 | 使用场景示例 |
|---|---|---|---|---|---|
| 两步 RAG | 检索总是在生成之前发生。简单且可预测 | ✅ 高 | ❌ 低 | ⚡ 快 | FAQ、文档机器人 |
| Agentic RAG | LLM 驱动的 Agent 决定何时以及如何在推理过程中检索 | ❌ 低 | ✅ 高 | ⏳ 可变 | 具有多工具访问的研究助手 |
| 混合 RAG | 结合两种方法的特点,包含验证步骤 | ⚖️ 中 | ⚖️ 中 | ⏳ 可变 | 带质量验证的领域特定问答 |
信息
延迟:延迟在两步 RAG中通常更可预测,因为 LLM 调用的最大次数是已知且有上限的。这种可预测性假设 LLM 推理时间是主要因素。但是,实际延迟也可能受检索步骤性能的影响——例如 API 响应时间、网络延迟或数据库查询——这些可能因使用的工具和基础设施而异。
在两步 RAG中,检索步骤总是在生成步骤之前执行。这种架构简单且可预测,适合许多应用,其中检索相关文档是生成答案的明确前提。
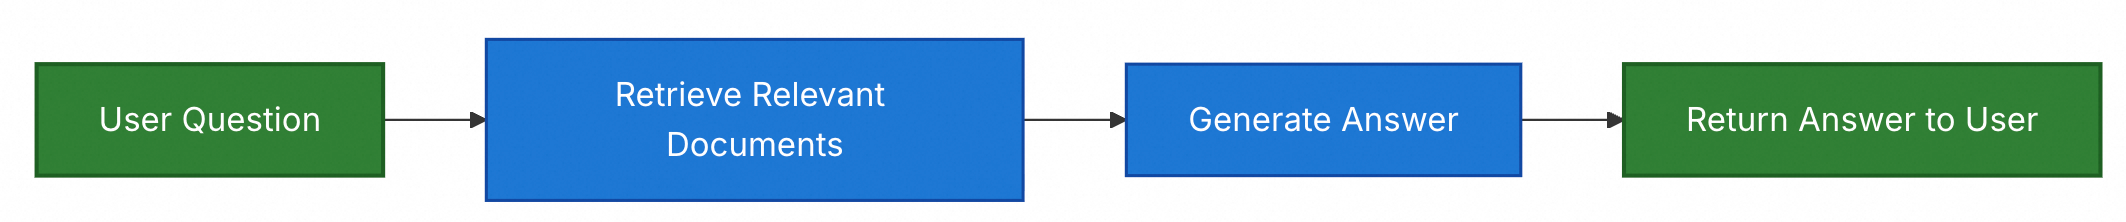
Spring AI 提供了开箱即用的 QuestionAnswerAdvisor 和 RetrievalAugmentationAdvisor,简化两步 RAG 的实现。这些 Advisor 自动处理检索和上下文增强,详见 Retrieval Augmented Generation。
使用 MessagesModelHook 实现
通过 MessagesModelHook 在模型调用前检索文档并添加到消息中:
import com.alibaba.cloud.ai.graph.agent.ReactAgent;
import com.alibaba.cloud.ai.graph.agent.hook.messages.MessagesModelHook;
import com.alibaba.cloud.ai.graph.agent.hook.messages.AgentCommand;
import com.alibaba.cloud.ai.graph.agent.hook.messages.UpdatePolicy;
import com.alibaba.cloud.ai.graph.agent.hook.HookPosition;
import com.alibaba.cloud.ai.graph.agent.hook.HookPositions;
import com.alibaba.cloud.ai.graph.RunnableConfig;
import org.springframework.ai.document.Document;
import org.springframework.ai.vectorstore.VectorStore;
import org.springframework.ai.chat.messages.Message;
import org.springframework.ai.chat.messages.SystemMessage;
import org.springframework.ai.chat.messages.UserMessage;
import org.springframework.ai.chat.messages.AssistantMessage;
import java.util.ArrayList;
import java.util.List;
import java.util.stream.Collectors;

// 假设你已经有一个配置好的向量存储
VectorStore vectorStore = ...; // 配置你的向量存储(如Milvus、Pinecone等)

// 创建 RAG Hook:在模型调用前检索文档并添加到消息中
@HookPositions({HookPosition.BEFORE_MODEL})
class RAGMessagesHook extends MessagesModelHook {
  private final VectorStore vectorStore;
  private static final int TOP_K = 5;

  public RAGMessagesHook(VectorStore vectorStore) {
      this.vectorStore = vectorStore;
  }

  @Override
  public String getName() {
      return "rag_messages_hook";
  }

  @Override
  public AgentCommand beforeModel(List<Message> previousMessages, RunnableConfig config) {
      // 从消息中提取用户问题
      String userQuestion = extractUserQuestion(previousMessages);
      if (userQuestion == null || userQuestion.isEmpty()) {
          return new AgentCommand(previousMessages);
      }

      // Step 1: 检索相关文档
      List<Document> relevantDocs = vectorStore.similaritySearch(
          org.springframework.ai.vectorstore.SearchRequest.builder()
              .query(userQuestion)
              .topK(TOP_K)
              .build()
      );

      // Step 2: 构建上下文
      String context = relevantDocs.stream()
          .map(Document::getText)
          .collect(Collectors.joining("

"));

      // Step 3: 构建增强的消息列表
      List<Message> enhancedMessages = new ArrayList<>();

      // 添加系统提示(包含检索到的上下文)
      String systemPrompt = String.format("""
          你是一个有用的助手。基于以下上下文回答问题。
          如果上下文中没有相关信息,请说明你不知道。

          上下文:
          %s
          """, context);
      enhancedMessages.add(new SystemMessage(systemPrompt));

      // 保留原有的消息
      enhancedMessages.addAll(previousMessages);

      // 使用 REPLACE 策略替换消息
      return new AgentCommand(enhancedMessages, UpdatePolicy.REPLACE);
  }

  private String extractUserQuestion(List<Message> messages) {
      // 从消息列表中提取最后一个用户消息
      for (int i = messages.size() - 1; i >= 0; i--) {
          Message msg = messages.get(i);
          if (msg instanceof UserMessage) {
              return ((UserMessage) msg).getText();
          }
      }
      return null;
  }
}

// 创建带有 RAG Hook 的 Agent
ReactAgent ragAgent = ReactAgent.builder()
  .name("rag_agent")
  .model(chatModel)
  .hooks(new RAGMessagesHook(vectorStore))
  .build();

// 调用 Agent
AssistantMessage response = ragAgent.call("Spring AI Alibaba支持哪些模型?");
System.out.println("答案: " + response.getText());
使用 ModelInterceptor 实现
通过 ModelInterceptor 检索文档后附加到 systemPrompt:
import com.alibaba.cloud.ai.graph.agent.ReactAgent;
import com.alibaba.cloud.ai.graph.agent.interceptor.ModelInterceptor;
import com.alibaba.cloud.ai.graph.agent.interceptor.ModelRequest;
import com.alibaba.cloud.ai.graph.agent.interceptor.ModelResponse;
import com.alibaba.cloud.ai.graph.agent.interceptor.ModelCallHandler;
import org.springframework.ai.document.Document;
import org.springframework.ai.vectorstore.VectorStore;
import org.springframework.ai.chat.messages.SystemMessage;
import java.util.List;
import java.util.stream.Collectors;

// 假设你已经有一个配置好的向量存储
VectorStore vectorStore = ...; // 配置你的向量存储(如Milvus、Pinecone等)

// 创建 RAG Interceptor:检索文档后附加到 systemPrompt
class RAGModelInterceptor extends ModelInterceptor {
  private final VectorStore vectorStore;
  private static final int TOP_K = 5;

  public RAGModelInterceptor(VectorStore vectorStore) {
      this.vectorStore = vectorStore;
  }

  @Override
  public ModelResponse interceptModel(ModelRequest request, ModelCallHandler handler) {
      // 从用户消息中提取查询
      String userQuery = extractUserQuery(request);
      if (userQuery == null || userQuery.isEmpty()) {
          return handler.call(request);
      }

      // Step 1: 检索相关文档
      List<Document> relevantDocs = vectorStore.similaritySearch(
          org.springframework.ai.vectorstore.SearchRequest.builder()
              .query(userQuery)
              .topK(TOP_K)
              .build()
      );

      // Step 2: 构建上下文
      String context = relevantDocs.stream()
          .map(Document::getText)
          .collect(Collectors.joining("

"));

      // Step 3: 增强 systemPrompt
      String enhancedSystemPrompt = String.format("""
          你是一个有用的助手。基于以下上下文回答问题。
          如果上下文中没有相关信息,请说明你不知道。

          上下文:
          %s
          """, context);

      // 合并原有的 systemPrompt 和检索到的上下文
      SystemMessage enhancedSystemMessage;
      if (request.getSystemMessage() == null) {
          enhancedSystemMessage = new SystemMessage(enhancedSystemPrompt);
      } else {
          enhancedSystemMessage = new SystemMessage(
              request.getSystemMessage().getText() + "

" + enhancedSystemPrompt
          );
      }

      // 创建增强的请求
      ModelRequest enhancedRequest = ModelRequest.builder(request)
          .systemMessage(enhancedSystemMessage)
          .build();

      // 调用处理器
      return handler.call(enhancedRequest);
  }

  private String extractUserQuery(ModelRequest request) {
      // 从消息列表中提取用户查询
      return request.getMessages().stream()
          .filter(msg -> msg instanceof org.springframework.ai.chat.messages.UserMessage)
          .map(msg -> ((org.springframework.ai.chat.messages.UserMessage) msg).getText())
          .reduce((first, second) -> second) // 获取最后一个用户消息
          .orElse("");
  }

  @Override
  public String getName() {
      return "rag_model_interceptor";
  }
}

// 创建带有 RAG Interceptor 的 Agent
ReactAgent ragAgent = ReactAgent.builder()
  .name("rag_agent")
  .model(chatModel)
  .interceptors(new RAGModelInterceptor(vectorStore))
  .build();

// 调用 Agent
AssistantMessage response = ragAgent.call("Spring AI Alibaba支持哪些模型?");
System.out.println("答案: " + response.getText());
使用 AgentHook 实现(只检索一次)
如果不想在每次 Agent reasoning 循环中都检索 RAG,可以使用 AgentHook 在 Agent 开始时只检索一次,然后将检索结果存储到状态中供后续使用:
import com.alibaba.cloud.ai.graph.agent.ReactAgent;
import com.alibaba.cloud.ai.graph.agent.hook.AgentHook;
import com.alibaba.cloud.ai.graph.agent.hook.HookPosition;
import com.alibaba.cloud.ai.graph.agent.hook.HookPositions;
import com.alibaba.cloud.ai.graph.agent.interceptor.ModelInterceptor;
import com.alibaba.cloud.ai.graph.agent.interceptor.ModelRequest;
import com.alibaba.cloud.ai.graph.agent.interceptor.ModelResponse;
import com.alibaba.cloud.ai.graph.agent.interceptor.ModelCallHandler;
import com.alibaba.cloud.ai.graph.OverAllState;
import com.alibaba.cloud.ai.graph.RunnableConfig;
import org.springframework.ai.document.Document;
import org.springframework.ai.vectorstore.VectorStore;
import org.springframework.ai.chat.messages.SystemMessage;
import java.util.List;
import java.util.Map;
import java.util.Optional;
import java.util.concurrent.CompletableFuture;
import java.util.stream.Collectors;

// 假设你已经有一个配置好的向量存储
VectorStore vectorStore = ...; // 配置你的向量存储(如Milvus、Pinecone等)

// 在 Agent 开始时检索文档(只执行一次)
@HookPositions({HookPosition.BEFORE_AGENT})
class RAGAgentHook extends AgentHook {
  private final VectorStore vectorStore;
  private static final int TOP_K = 5;
  private static final String RAG_CONTEXT_KEY = "rag_context";

  public RAGAgentHook(VectorStore vectorStore) {
      this.vectorStore = vectorStore;
  }

  @Override
  public String getName() {
      return "rag_agent_hook";
  }

  @Override
  public CompletableFuture<Map<String, Object>> beforeAgent(OverAllState state, RunnableConfig config) {
      // 从状态中提取用户问题
      Optional<Object> messagesOpt = state.value("messages");
      if (messagesOpt.isEmpty()) {
          return CompletableFuture.completedFuture(Map.of());
      }

      @SuppressWarnings("unchecked")
      List<org.springframework.ai.chat.messages.Message> messages =
          (List<org.springframework.ai.chat.messages.Message>) messagesOpt.get();

      // 提取最后一个用户消息作为查询
      String userQuery = messages.stream()
          .filter(msg -> msg instanceof org.springframework.ai.chat.messages.UserMessage)
          .map(msg -> ((org.springframework.ai.chat.messages.UserMessage) msg).getText())
          .reduce((first, second) -> second) // 获取最后一个
          .orElse("");

      if (userQuery.isEmpty()) {
          return CompletableFuture.completedFuture(Map.of());
      }

      // Step 1: 检索相关文档(只执行一次,在整个 Agent 执行过程中)
      List<Document> relevantDocs = vectorStore.similaritySearch(
          org.springframework.ai.vectorstore.SearchRequest.builder()
              .query(userQuery)
              .topK(TOP_K)
              .build()
      );

      // Step 2: 构建上下文
      String context = relevantDocs.stream()
          .map(Document::getText)
          .collect(Collectors.joining("

"));

      config.metadata().ifPresent(meta -> {
		meta.put(RAG_CONTEXT_KEY, context);
	});

      // Step 3: 将检索到的上下文存储到状态中,供后续 ModelInterceptor 使用
      // 存储到 state 中,ModelInterceptor 可以通过 request.getContext() 访问
      return CompletableFuture.completedFuture(Map.of());
  }
}

// 在模型调用时使用存储的上下文
class RAGContextInterceptor extends ModelInterceptor {
  private static final String RAG_CONTEXT_KEY = "rag_context";

  @Override
  public ModelResponse interceptModel(ModelRequest request, ModelCallHandler handler) {
      // 从请求上下文中获取检索到的 RAG 上下文
      // RAG 上下文在 AgentHook 的 beforeAgent 中已经存储到状态中
      Map<String, Object> context = request.getContext();
      String ragContext = (String) context.get(RAG_CONTEXT_KEY);

      if (ragContext == null || ragContext.isEmpty()) {
          // 如果没有检索到上下文,直接调用处理器
          return handler.call(request);
      }

      // 增强 systemPrompt
      String enhancedSystemPrompt = String.format("""
          你是一个有用的助手。基于以下上下文回答问题。
          如果上下文中没有相关信息,请说明你不知道。

          上下文:
          %s
          """, ragContext);

      // 合并原有的 systemPrompt 和检索到的上下文
      SystemMessage enhancedSystemMessage;
      if (request.getSystemMessage() == null) {
          enhancedSystemMessage = new SystemMessage(enhancedSystemPrompt);
      } else {
          enhancedSystemMessage = new SystemMessage(
              request.getSystemMessage().getText() + "

" + enhancedSystemPrompt
          );
      }

      // 创建增强的请求
      ModelRequest enhancedRequest = ModelRequest.builder(request)
          .systemMessage(enhancedSystemMessage)
          .build();

      return handler.call(enhancedRequest);
  }

  @Override
  public String getName() {
      return "rag_context_interceptor";
  }
}

// 创建带有 RAG Hook 和 Interceptor 的 Agent
ReactAgent ragAgent = ReactAgent.builder()
  .name("rag_agent")
  .model(chatModel)
  .hooks(new RAGAgentHook(vectorStore))
  .interceptors(new RAGContextInterceptor())
  .build();

// 调用 Agent(RAG 检索只会在 Agent 开始时执行一次)
AssistantMessage response = ragAgent.call("Spring AI Alibaba支持哪些模型?");
System.out.println("答案: " + response.getText());
三种方式对比:
| 方式 | 执行时机 | 检索次数 | 适用场景 |
|---|---|---|---|
| MessagesModelHook | 每次模型调用前 | 每次 reasoning 循环 | 需要根据每次推理动态检索 |
| ModelInterceptor | 每次模型调用前 | 每次 reasoning 循环 | 需要访问完整请求信息 |
| AgentHook | Agent 开始时 | 只检索一次 | 优化性能,避免重复检索 |
选择建议:
- 如果查询在 Agent 执行过程中不会变化,使用 AgentHook 可以显著提升性能
- 如果需要根据每次推理的结果动态调整检索,使用 MessagesModelHook 或 ModelInterceptor
所有方式都能实现两步 RAG:检索文档 → 增强上下文 → 生成答案。
构建知识库
使用 ETL 管道(Extract、Transform、Load)可以轻松构建知识库。Spring AI 提供了统一的 ETL 接口,支持链式处理:
import org.springframework.ai.document.Document;
import org.springframework.ai.reader.TextReader;
import org.springframework.ai.transformer.splitter.TokenTextSplitter;
import org.springframework.ai.vectorstore.VectorStore;
import org.springframework.core.io.FileSystemResource;
import org.springframework.core.io.Resource;
import java.util.List;

// 1. 加载文档
Resource resource = new FileSystemResource("path/to/document.txt");
TextReader textReader = new TextReader(resource);
List<Document> documents = textReader.get();

// 2. 分割文档为块
TokenTextSplitter splitter = new TokenTextSplitter();
List<Document> chunks = splitter.apply(documents);

// 3. 将块添加到向量存储
vectorStore.add(chunks);

// 现在你可以使用向量存储进行检索
List<Document> results = vectorStore.similaritySearch("查询文本");
更多关于 ETL 管道的详细说明和高级用法,请参考 ETL Pipeline 文档。
本文整理自 Spring AI Alibaba 官方文档《检索增强生成 RAG》:https://java2ai.com/docs/frameworks/agent-framework/advanced/rag