AI项目博客
「企业级大模型私有化部署」系列第 3 篇。目标:在 AutoDL 的 RTX 4090 上装 Ollama,跑 qwen3:4b,再通过 SSH 隧道接进 Dify。
结论:Ollama 负责「把大模型跑起来」,Dify 负责「把大模型用起来」。中间那根线是 SSH 隧道;隧道没通,Dify 里怎么配都看不到模型。
一、AutoDL 是什么
AutoDL 是面向开发者和企业的 GPU 算力平台,提供 RTX 4090、3090、A 系列等显卡,按小时计费。它的资源比较紧俏,一台 4090 每小时约 2 元,建议早上开机、晚上关机,长期保存用快照。
这套方案需要两台 GPU 服务器:一台装 Ollama,一台装 Xinference。两台都选 RTX 4090 24GB,单卡足够跑 qwen3:4b 和 bge 系列模型。
二、租赁 GPU 服务器
2.1 选服务器和镜像
进入 AutoDL 控制台,创建实例:
- 地区:按可用资源选,示例选西北 B 区;
- GPU:RTX 4090,单卡 24GB;
- GPU 数量:1;
- 计费方式:按量计费;
- 镜像:PyTorch 2.1.2 / Python 3.10 / CUDA 11.8(按平台当前可选版本为准)。
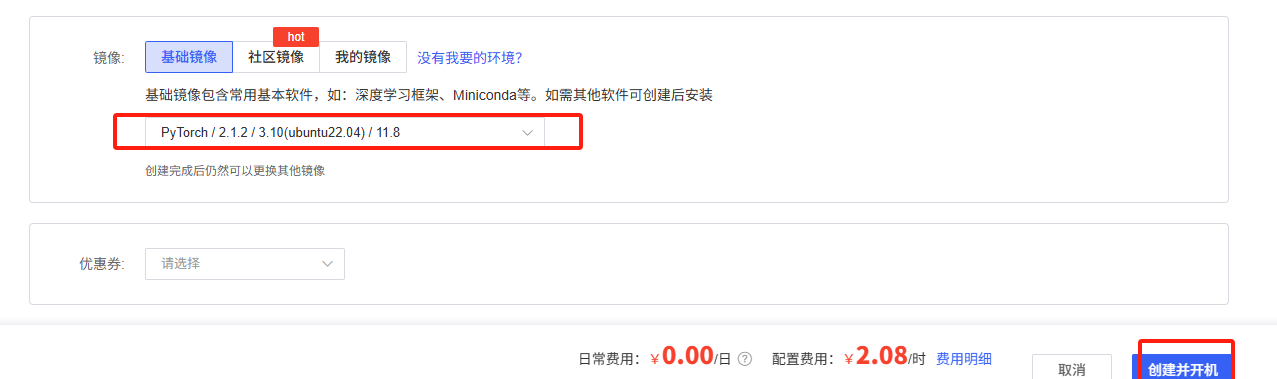
图 1:AutoDL 创建实例时选 PyTorch 镜像(示例 2.1.2 / Python 3.10 / CUDA 11.8)。
AutoDL 只开放 6006 端口,所以 Ollama 和 Xinference 都监听 6006,再用 SSH 隧道映射到 Dify 服务器。不要想着把 11434 直接开到公网,既不通也不安全。
2.2 登录与克隆实例
创建完成后,复制 SSH 登录指令,用 XShell 或 FinalShell 连接。默认用户名是 root,密码在控制台复制;首次连接输入 yes 保存指纹。
第二台 GPU 服务器不用重新配环境:在关机状态下,用「克隆实例」复制一个副本,改个名称即可。这样 Ollama 和 Xinference 两台机器的系统、CUDA、Python 版本一致,排错时少一个变量。
实例的目录约定:系统盘 / 放代码,实例关机数据不丢,但会随保存镜像一起保存;数据盘 /root/autodl-tmp 读写快,实例关机数据也不丢,但不会随镜像保存。大模型文件放数据盘。
注意:实例连续关机 15 天可能会被释放,释放后数据不可恢复;长期不用要保存镜像或快照。
2.3 开学术加速
AutoDL 提供学术资源加速,主要解决 GitHub、HuggingFace 等资源下载慢的问题。在终端执行:
source /etc/network_turbo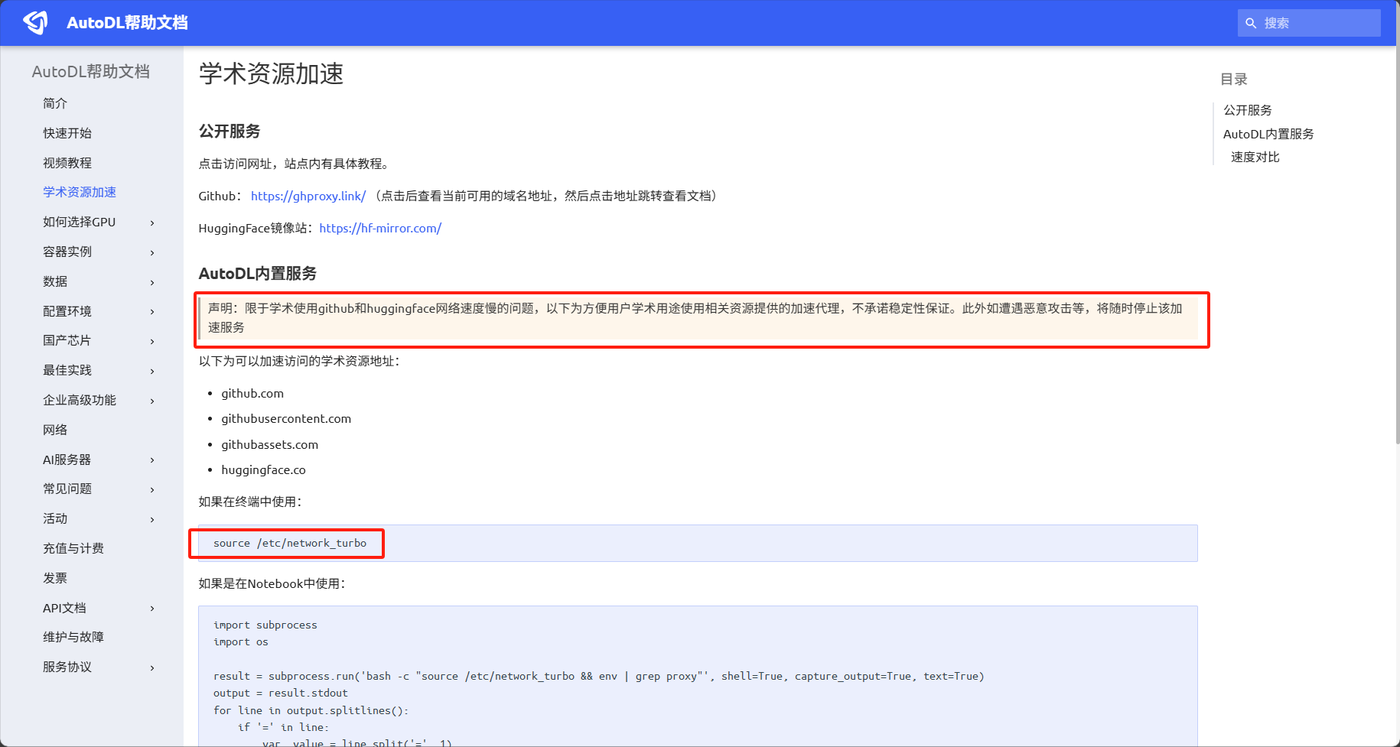
图 2:AutoDL 的学术加速,在终端执行 source /etc/network_turbo。
它只影响当前终端,新开终端要重新执行;它不改变你的网络出口,也不保证稳定性,下载完就可以关掉。
三、Ollama 是什么
Ollama 是 GitHub 上的开源项目,定位是「本地运行大模型的集成框架」。它把模型权重、配置和必要数据封装进 Modelfile 定义的包中,实现模型的下载、启动和本地推理自动化。支持 macOS、Linux、Windows,安装过程都很简单。
官网是 https://ollama.com,模型库在 https://ollama.com/library,可以查看有哪些模型、多大、上下文多长。
四、安装并启动 Ollama
登录 GPU 服务器 A,开学术加速,然后执行安装脚本:
source /etc/network_turbo
cd /data/dify/   # 没有目录先创建:sudo mkdir -p /data/dify
curl -fsSL https://ollama.com/install.sh | sh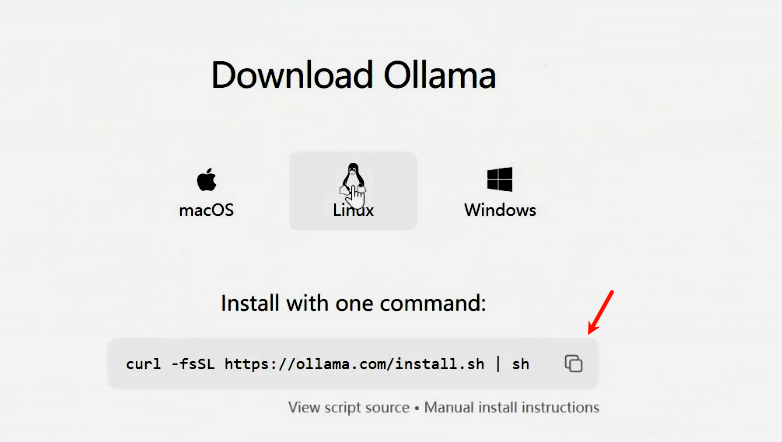
图 3:Ollama 官网提供一条安装命令,Linux 直接执行即可。
安装完成后启动服务。把监听地址限制在本机 6006:
OLLAMA_HOST=127.0.0.1:6006 ollama serve为什么只监听 127.0.0.1?因为对外只需要 SSH 隧道;直接监听 0.0.0.0 会把模型服务暴露到公网,任何人都能调。
如果希望服务在 SSH 断开后继续跑,用 screen 或 tmux 开一个会话再执行;不要直接依赖当前终端。
五、下载并运行模型
另开一个终端,下载并运行 qwen3:4b:
source /etc/network_turbo
OLLAMA_HOST=127.0.0.1:6006 ollama run qwen3:4b
qwen3:4b 大约 2.6GB,4K 上下文。下载完成后会直接进入对话,输入「你好」能回复就说明模型可用;按 Ctrl+D 退出对话。
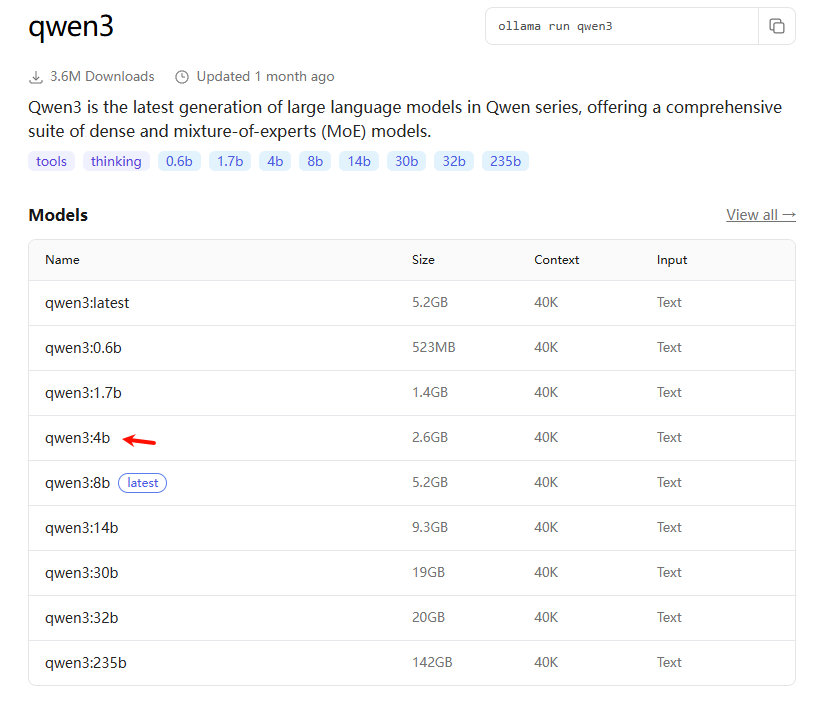
图 4:Ollama 模型库里的 qwen3:4b,约 2.6GB。
显存小或下载慢,可以换更小的模型:
OLLAMA_HOST=127.0.0.1:6006 ollama run qwen2.5:1.5b
OLLAMA_HOST=127.0.0.1:6006 ollama list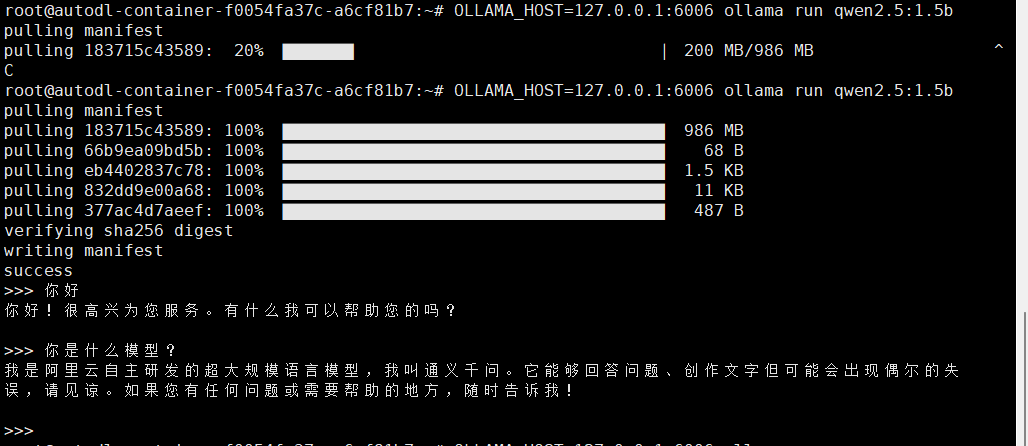
图 5:下载完成后直接对话;ollama list 能看到已安装的模型。
模型下载到数据盘,实例关机不丢;如果系统盘空间小,注意把 OLLAMA_MODELS 指到数据盘。
六、把 6006 隧道打到 Dify 服务器
在 Dify 服务器上执行:
ssh -CNg -L 6006:127.0.0.1:6006 root@<AutoDL SSH地址> -p <端口>没有任何输出就是正常。这个命令会把 Dify 服务器的 6006 转发到 GPU 服务器的 6006;终端要一直开着,关掉隧道就断。
也可以使用 AutoDL 的桌面隧道工具:下载工具,粘贴 SSH 指令和密码,把本地端口填 6006,确认即可。图形工具和命令行二选一。
在 Dify 服务器上测试:
curl http://127.0.0.1:6006/api/tags返回 JSON 里有 qwen3:4b,说明隧道和 Ollama 都通了。如果没有返回,先查隧道进程,再查 GPU 上的 ollama serve。
七、在 Dify 里接入 Ollama
Dify:设置 → 模型供应商 → 安装 Ollama(如果未安装)→ 添加模型。
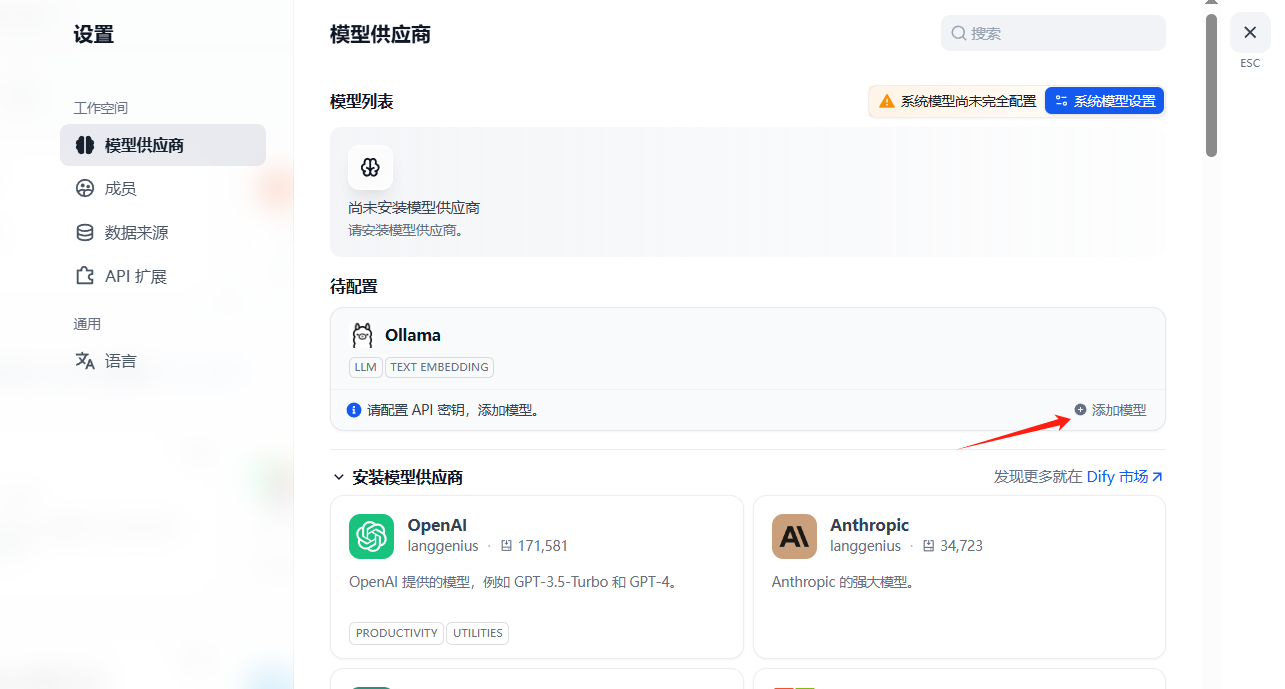
图 6:在 Dify 的 Ollama 供应商里点「添加模型」。
填写:
- 模型名称:
qwen3:4b,必须和ollama list里完全一致; - Base URL:
http://<Dify服务器内网IP>:6006; - 模型类型:LLM;
- 上下文长度:4096,按模型实际能力填。
保存后模型可能不会立刻出现,等一两分钟刷新。显示「配置成功」但列表为空,通常是在加载,不是失败;如果一直为空,检查内网 IP、端口和模型名。
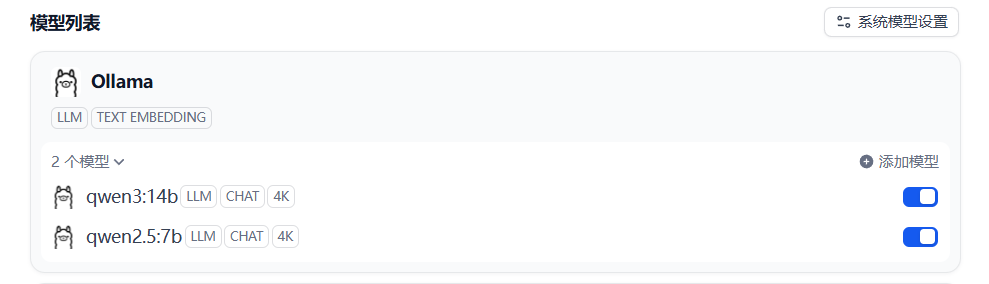
图 7:Dify 的 Ollama 供应商里能看到 qwen3:4b 和 qwen2.5:7b。
用同样的方法可以再加一个 qwen2.5:7b,做速度/质量的对比。模型名称必须与 Ollama 里的一致,不能只写 qwen3。
八、验收
- GPU 上
OLLAMA_HOST=127.0.0.1:6006 ollama list有 qwen3:4b; - Dify 服务器上
curl http://127.0.0.1:6006/api/tags有返回; - Dify 模型供应商里能看到 qwen3:4b,并且开关是开的;
- 在 Dify 里新建一个聊天应用,选 qwen3:4b,能正常回答;
- GPU 服务器
nvidia-smi能看到显存占用。
九、常见报错与处置
| 现象 | 原因 | 处置 |
|---|---|---|
| Dify 添加成功但看不到模型 | 模型还在加载,或 URL / 模型名不对 | 等一两分钟;核对内网 IP、6006 和模型名 |
curl 隧道地址无返回 |
隧道没开,或 GPU 上的 serve 没跑 | 重开隧道;在 GPU 上确认 ollama serve |
| 6006 被占用 | Xinference 也要用 6006 | Xinference 在 Dify 服务器上映射到 6007 |
| 模型下载慢 | 没有学术加速,或网络抖动 | source /etc/network_turbo;换小模型 |
| 显存不足 / OOM | 模型太大或并发太高 | 换 qwen2.5:1.5b;降低并发;换更大显存 |
| Dify 用 127.0.0.1 连不上 | Dify 在容器里,127.0.0.1 是容器自己 | Base URL 用 Dify 服务器的内网 IP |
| SSH 断开后模型服务停了 | 前台进程随终端退出 | 用 screen / tmux 或 systemd 托管 |
| 实例被释放 | 连续关机 15 天 | 保存镜像/快照;长期不用先备份 |
十、成本与边界
4090 按小时计费,跑一天的成本可能比一台轻量云服务器还高。不用就关机,长期保存用快照;模型文件放在数据盘,重置系统不会丢数据盘。
Ollama 适合快速验证和单机推理;并发上来后,要考虑 vLLM、TGI 这类推理框架,或者多卡/多实例。qwen3:4b 是入门尺寸,复杂任务换更大的模型,显存和成本会同步上升。
下一篇
大语言模型有了,知识库还缺 Embedding 和 Rerank。下一篇在第二台 GPU 服务器上装 Xinference,部署 bge-large-zh-v1.5 和 reranker,再接到 Dify 的 6007 端口。