
 AI项目博客
本系列共 9 篇,从空目录搭到可部署的 Python RAG 知识库。这是第 4 篇。
文件已经进了 MinIO,数据库里只有一条“待解析”的记录。这一篇把它变成一堆带标题路径的切片:解析五种格式、按标题和句子切块、把切片落库,再用定时任务兜住失败和卡死的任务。
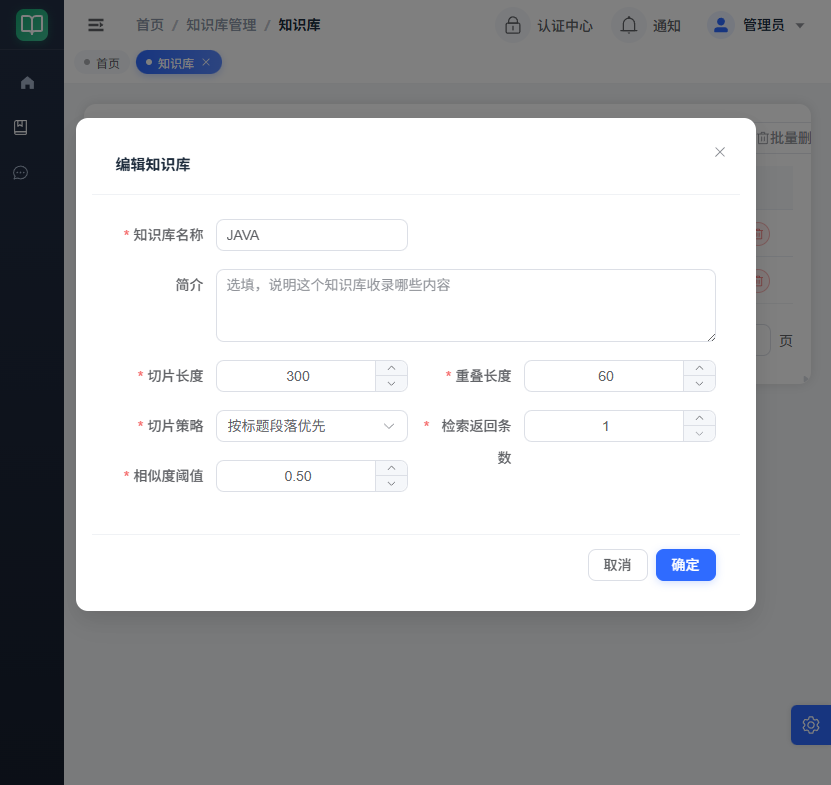
图:知识库参数,切片长度、重叠与切片策略决定解析结果。
一、解析器:纯函数,不碰数据库
解析层只做一件事:字节 → 带结构的文本块。ParsedBlock 里两个字段,text 是正文,title_path 是它所属的章节路径。
@dataclass(slots=True)

class ParsedBlock:

    title_path: str | None

    text: str

@dataclass(slots=True)

class ParsedDocument:

    blocks: list[ParsedBlock]

    char_count: int

def parse_document(file_type: str, content: bytes) -> ParsedDocument:

    if file_type == "txt":   return _parse_text(content)

    if file_type == "md":    return _parse_markdown(content)

    if file_type == "docx":  return _parse_docx(content)

    if file_type == "pdf":   return _parse_pdf(content)

    if file_type == "xlsx":  return _parse_xlsx(content)

    raise PlatformException(f"暂不支持的文件类型:{file_type}")
做成纯函数的好处:不依赖数据库、不依赖 MinIO,单测直接传字节。解析是 CPU 密集型操作,实际调用时要包 asyncio.to_thread,否则大 PDF 会卡住整个事件循环。
二、五种格式,各自注意什么
- txt:Windows 记事本常存成 GBK/GB18030,按 UTF-8 硬解会整篇乱码。先试
utf-8-sig,再试gb18030。另外要检查二进制特征,别让改了后缀的图片混进来。 - md:按
#的层级维护一个标题栈,遇到同级或更浅的标题先出栈,保证title_path是完整的“一级 > 二级”。 - docx:不能只读
document.paragraphs,因为表格在另一个列表里,直接读会丢掉表格内容,还会打乱顺序。要按文档 XML 的真实顺序遍历段落和表格;内容控件、修订插入也要递归进去,否则文字会静默消失。 - pdf:pypdf 只能读有文本层的 PDF。扫描件会得到空文本,这时明确报“不支持 OCR”,不要悄悄入库一份空文档。
- xlsx:首行当表头,每一行拼成“列名: 值;列名: 值”。多个 sheet 用表名做
title_path,单 sheet 不加,避免全是“Sheet1”噪音。
stack: list[str] = []

current_path: str | None = None

for raw_line in text.split("\n"):

    match = _MD_HEADING.match(raw_line.rstrip())

    if match:

        flush()                          # 先把上一节的正文冲出去

        level = len(match.group(1))

        while len(stack) >= level:       # 同级或更浅:先出栈

            stack.pop()

        stack.append(match.group(2).strip())

        current_path = " > ".join(stack)

    else:

        buffer.append(raw_line)
三、切片:按标题分,超长再按句子切
切片有三个原则:
- 不跨块合并:一段同时属于两节时,引用说不清出处;
- 超长回溯到句末:避免一句话被劈成两半;
- 相邻片留 overlap:防止答案正好横跨切分点。
def _split_text(text: str, chunk_size: int, overlap: int) -> list[str]:

    source = (text or "").strip()

    if not source:

        return []

    if len(source) <= chunk_size:

        return [source]

    pieces, start, length = [], 0, len(source)

    while start < length:

        end = min(start + chunk_size, length)

        if end < length:

            boundary = _find_boundary(source, start + chunk_size // 2, end)

            end = max(boundary, start + 1)       # 至少前进一个字符

        piece = source[start:end].strip()

        if piece:

            pieces.append(piece)

        if end >= length:

            break

        nxt = max(end - min(overlap, chunk_size - 1), start + 1)

        start = min(nxt, length)                 # overlap 再大也不能原地打转

    return pieces
_find_boundary 从后往前找句号、问号、感叹号、分号、换行,找到就切在它后面;找不到就硬切。overlap 必须小于 chunk_size,否则会死循环。
四、落库:同版本先删后插
解析成功后会覆盖“该文档该版本”的切片:先删旧切片和旧向量,再插入新切片。租户 ID 必须从文档继承,不能取请求上下文,因为补偿任务里没有用户。
async def replace_chunks(session, document, version, drafts):

    replaced_ids = ...  # 查同文档同版本的切片 ID

    if replaced_ids:

        async with session.begin_nested():    # 向量表异常别污染主事务

            await vector_store.delete_by_chunks(session, replaced_ids)

    await session.execute(delete(KbChunk).where(

        KbChunk.doc_id == document.id, KbChunk.version == version

    ))

    session.add_all([

        KbChunk(

            tenant_id=document.tenant_id, base_id=document.base_id,

            doc_id=document.id, version=version, chunk_no=draft.chunk_no,

            title_path=(draft.title_path or "")[:512] or None,

            content=draft.content, embed_status=0,

        ) for draft in drafts

    ])
五、状态机:没有消息队列也能补偿
解析状态只有四个:待解析(0)、解析中(1)、成功(2)、失败(3)。上传接口会立即触发一次解析,定时任务每 120 秒扫一遍“待解析”和“卡在解析中超过 10 分钟”的记录。
并发时最怕两件事:上传链路和扫描任务同时解析同一篇,导致切片出现双份。解决办法不是加锁,而是一条条件 UPDATE 原子抢占:
result = await session.execute(

    update(KbDocument)

    .where(

        KbDocument.id == document.id,

        or_(

            KbDocument.parse_status == 0,

            (KbDocument.parse_status == 1)

            & (KbDocument.updated_time < stale_before),

        ),

    )

    .values(parse_status=1)

)

await session.commit()

if not result.rowcount:

    return False        # 没抢到,直接退出
只有“待解析”或“僵死解析中”的文档能被抢到,其他任务会安静退出。失败时把 parse_status 置 3,并写清 parse_msg;下次成功时必须把 parse_msg 清空,否则页面会一直挂着上次的报错。
六、验证一下
上传一个带两级标题的 Markdown,然后查切片:
curl -s -X POST localhost:18015/kb/chunk/page \

  -H "satoken: 你的token" -H "Content-Type: application/json" \

-d '{"currentPage":1,"currentPageSize":20,"queryParams":{"docId":1}}'期望看到:chunkNo 从 1 开始递增,titlePath 是“一级 > 二级”,embedStatus 为 0(待向量化)。文档详情里的 parseStatus 应该变成 2。
七、本篇踩坑
- docx 只读 paragraphs 会丢表格和顺序。 必须按 XML 子节点顺序遍历。
- PDF 扫描件不要硬解析。 没有文本层就明确报错,空切片比报错更难排查。
- overlap 要严格小于片长。 否则下一片起点不前进,循环永远结束不了。
- 僵死任务必须能重新捡起。 进程崩溃后状态会停在“解析中”,扫描任务要按
updated_time兜底。
下一篇
切片有了,但还只是一堆文本。下一篇把每张切片变成 1024 维向量,写进 pgvector,并处理失败重试和状态回写。








