AI项目博客
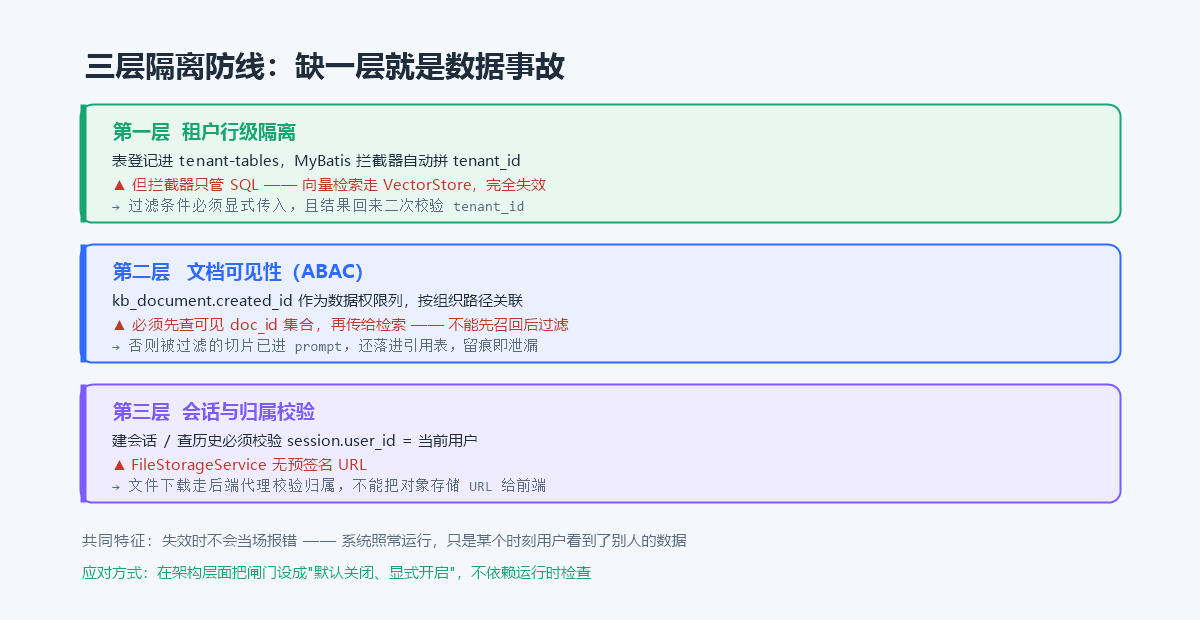
这个系统是对外多租户 SaaS,所以有两条不能破的红线:数据不能串租户,以及成本不能失控。前者是安全事故,后者是经营事故。
一、租户隔离靠拦截器,但有两处它管不到
先看配置:
platform:

  tenant:

    data-isolation:

      enabled: true

      # ⚠️ 新增业务表必须同步登记,否则租户拦截器不管它:不报错、只跨租户泄漏数据

      tenant-tables:

        - kb_knowledge_base

        - kb_document

        - kb_chunk

        - kb_qa_session

        - kb_qa_message

        - kb_qa_reference

        - kb_ai_invoke_log

        - kb_tenant_quota
登记之后,这些表的 SELECT / UPDATE / DELETE 会自动带上 tenant_id 条件,INSERT 由 PlatformBaseService.fillTenantId 收口。
但拦截器只管 MyBatis 的 SQL。有两处它管不到:
① 向量检索。它走 Spring AI 的 VectorStore,压根不经过 MyBatis,拦截器自然看不到这条查询。所以租户范围必须作为过滤表达式显式传入(见第二篇的 buildFilterExpression)。
② 平台共享表。sys_user、sys_org 这类表没有纳入隔离(因为大量 LEFT JOIN 取名会导致拦截器注入出问题),凡是直接查它们的地方都必须显式加 tenant_id。
1.1 数据权限:一期豁免
platform:

  data-permission:

    enabled: true

    # 一期不做文档级可见性,故 kb_* 与 sys_* 一律豁免;

    # 二期启用时把 kb_document 从这张表里移除即可

    ignore-tables:

      - sys_user

      # ...

      - kb_document

      - kb_chunk

      # ...
数据权限(ABAC)是按「创建人所属组织」过滤数据的机制。知识库的可见范围由「租户 + 知识库」决定,不走组织过滤,所以一期全部豁免。
但配置写了「二期启用时把 kb_document 从这里移除即可」——这是留了一条可逆的路:将来真要按组织隔离文档,改配置就能生效,不用改代码。
二、套餐与配额
2.1 上传时三道校验
@Override

public void assertCanUpload(long fileSizeBytes) {

    if (UserUtils.getTenantId() == null) {

        return;   // 平台超管不受租户配额约束

    }

    KbTenantQuotaEntity quota = currentOrInit();

    assertUsable(quota);

    int docLimit = quota.getDocLimit() == null ? 0 : quota.getDocLimit();

    if (docLimit > 0 && countDocuments() >= docLimit) {

        throw new PlatformException("文档数已达套餐上限(" + docLimit + " 份),"

                + "请删除不再需要的文档或升级套餐");

    }

    // 切片数此前只展示不校验 —— 切片才是存储与检索成本的主要来源,必须一起卡

    int chunkLimit = quota.getChunkLimit() == null ? 0 : quota.getChunkLimit();

    if (chunkLimit > 0 && countChunks() >= chunkLimit) {

        throw new PlatformException("切片数已达套餐上限(" + chunkLimit + " 条),"

                + "请清理不再需要的文档或升级套餐");

    }

    long storageLimitMb = quota.getStorageLimitMb() == null ? 0L : quota.getStorageLimitMb();

    if (storageLimitMb > 0) {

        long usedMb = totalStorageMb();

        // 按本次文件大小预估,向上取整:小于 1MB 的文件也至少占 1MB,

        // 避免连续上传小文件绕过限制

        long incomingMb = Math.max(1L, (fileSizeBytes + MB - 1) / MB);

        if (usedMb + incomingMb > storageLimitMb) {

            throw new PlatformException("存储空间不足:已用 " + usedMb + "MB,上限 "

                    + storageLimitMb + "MB,本次需要 " + incomingMb + "MB");

        }

    }

}「切片数必须一起卡」是注释里特意写的:切片才是存储与检索成本的主要来源。只卡文档数,一个 10MB 的 PDF 和一个 1KB 的 txt 算一样多,显然不合理。
存储按「向上取整、最少 1MB」估,否则连续上传几百个 10KB 的小文件,每次算下来都是 0MB,可以无限绕过限制。
2.2 套餐本身要有约束力
/**

 * 套餐本身是否可用(启用 + 未过期)。

 *

 * <p>这两个字段此前只被读出来展示、没参与校验 —— 表现是「看板显示已到期,

 * 但上传与提问照常成功」。停用与过期都是运营侧的明确动作,必须有实际约束力。</p>

 */

private void assertUsable(KbTenantQuotaEntity quota) {

    if (quota.getStatus() != null && quota.getStatus() == 0) {

        throw new PlatformException("知识库服务已停用,请联系管理员");

    }

    LocalDateTime expireTime = quota.getExpireTime();

    if (expireTime != null && expireTime.isBefore(LocalDateTime.now())) {

        throw new PlatformException("知识库套餐已于 " + expireTime.toLocalDate() + " 到期,"

                + "请续期后使用");

    }

}这是个很典型的坑:字段存在、页面上也展示了,但没参与任何校验。结果是运营把租户停用了,客户照样能用。
2.3 原子占用:一条 UPDATE 同时判断与计数
配额校验最容易写错的地方是「先查后写」:查询用了多少次 → 判断是否超限 → 再写回。这中间有窗口,并发请求会同时通过判断。
正确做法是把判断和计数合并到一条 UPDATE 里:
/**

 * 原子占用一次问答额度。

 *

 * <p>一条 UPDATE 同时完成「跨天归零 / 自增」与「未超限」两件事,

 * 返回受影响行数:0 表示已达上限。这样「判断」与「计数」之间不再有窗口。</p>

 */

private boolean tryConsumeQaQuota(Long quotaId, LocalDate today, int limit) {

    int rows = baseMapper.update(null, Wrappers.<KbTenantQuotaEntity>lambdaUpdate()

            .eq(KbTenantQuotaEntity::getId, quotaId)

            // 先算计数,再改日期,顺序不能颠倒

            .setSql("used_qa_count = CASE WHEN used_qa_date = '" + today

                    + "' THEN used_qa_count + 1 ELSE 1 END")

            .set(KbTenantQuotaEntity::getUsedQaDate, today)

            // 跨天(含首次使用)一律放行;同一天则要求未达上限

            .apply("(used_qa_date IS NULL OR used_qa_date <> {0} OR used_qa_count < {1})",

                    today, limit));

    return rows > 0;

}
调用处:
@Override

public void assertAndConsumeAsk() {

    Long tenantId = UserUtils.getTenantId();

    if (tenantId == null) {

        return;   // 平台超管不受租户配额约束

    }

    KbTenantQuotaEntity quota = currentOrInit(tenantId);

    assertUsable(quota);

    int limit = quota.getQaLimitDaily() == null ? 0 : quota.getQaLimitDaily();

    LocalDate today = LocalDate.now();

    if (limit <= 0) {

        // 不限量:仍要计数(看板要展示今日用量)

        bumpQaCount(quota.getId(), today);

        return;

    }

    if (!tryConsumeQaQuota(quota.getId(), today, limit)) {

        throw new PlatformException("今日问答次数已达上限(" + limit + " 次),"

                + "请明天再试或升级套餐");

    }

}
2.4 一个隐藏的坑:SET 的求值顺序
/** 不限量时只计数(跨天归零),失败只记日志:看板少一个数,不该让问答失败 */

private void bumpQaCount(Long quotaId, LocalDate today) {

    try {

        update(Wrappers.<KbTenantQuotaEntity>lambdaUpdate()

                .eq(KbTenantQuotaEntity::getId, quotaId)

                // SET 的求值顺序是从左到右:used_qa_count 必须写在 used_qa_date 之前,

                // 否则 used_qa_date 已先被改成今天,CASE 判断永远成立、跨天不再归零

                .setSql("used_qa_count = CASE WHEN used_qa_date = '" + today

                        + "' THEN used_qa_count + 1 ELSE 1 END")

                .set(KbTenantQuotaEntity::getUsedQaDate, today));

    } catch (Exception e) {

        log.warn("问答次数计数失败(不影响本次问答,但该租户计数会偏小):quotaId={}", quotaId, e);

    }

}这个坑很隐蔽。两段代码都用了同样的模式:used_qa_count 的赋值必须写在 used_qa_date 之前。因为 MySQL 的 SET 子句是从左到右求值的——如果先改日期,那么 CASE WHEN used_qa_date = today 永远成立,跨天归零就失效了,计数会一直累加。
症状是:昨天用了 40 次、今天只用了 5 次,系统却认为你今天用了 45 次,直接触顶。
另外注意 bumpQaCount 的异常被吞掉了——看板上少一个数,不该让本次问答失败。
2.5 默认套餐:全不限
/**

 * 全「不限」的默认套餐。

 *

 * <p>默认不限额是刻意的:新租户还没谈套餐就把功能锁死,会变成「接入即不可用」。

 * 真正的限额由运营侧按合同写入。</p>

 */

private KbTenantQuotaEntity defaultQuota() {

    KbTenantQuotaEntity quota = new KbTenantQuotaEntity();

    quota.setPlanCode(DEFAULT_PLAN_CODE);

    quota.setDocLimit(0);            // 0 = 不限

    quota.setChunkLimit(0);

    quota.setStorageLimitMb(0L);

    quota.setQaLimitDaily(0);

    quota.setEmbedTokenMonthly(0L);

    // ...

    quota.setStatus(1);

    return quota;

}默认不限额是刻意的:新租户还没谈套餐就把功能锁死,会变成”接入即不可用”。真正的限额由运营按合同写入。
三、补偿任务里的配额判断
向量化的补偿任务跑在调度线程里,租户上下文为空。这带来一个特殊问题:配额不能用”当前上下文”判断,必须按切片自身的租户判断。
@Override

public boolean canEmbed(Long tenantId) {

    if (tenantId == null) {

        return true;

    }

    KbTenantQuotaEntity quota = currentOrInit(tenantId);

    try {

        assertUsable(quota);

    } catch (PlatformException e) {

        // 套餐停用/过期同样意味着「不该再花钱向量化」,按余额不足处理

        log.warn("租户套餐不可用,跳过其切片的向量化:tenantId={},{}", tenantId, e.getMessage());

        return false;

    }

    long limit = quota.getEmbedTokenMonthly() == null ? 0L : quota.getEmbedTokenMonthly();

    if (limit <= 0) {

        return true;

    }

    long used = usedEmbedTokenThisMonth(tenantId);

    if (used >= limit) {

        log.warn("租户当月向量化 token 已达上限,跳过其切片:tenantId={},已用={},上限={}",

                tenantId, used, limit);

        return false;

    }

    return true;

}
调用处(在补偿任务里):
// 定时任务里没有登录用户,租户上下文为空 —— 租户拦截器因此不过滤,

// 正好能扫到所有租户的待向量化切片。这是刻意的:补偿任务本就要跨租户工作。

//

// 但正因如此,配额必须按切片自身的租户判断,不能用「当前上下文」。

// 额度用尽的租户直接跳过它的切片:不能抛异常 —— 那会让整个补偿任务失败,

// 其他租户的切片跟着一起积压。

Map<Long, Boolean> allowedByTenant = new HashMap<>();

List<KbChunkEntity> allowed = new ArrayList<>(candidates.size());

for (KbChunkEntity chunk : candidates) {

    boolean canEmbed = allowedByTenant.computeIfAbsent(chunk.getTenantId(),

            kbTenantQuotaService::canEmbed);

    if (canEmbed) {

        allowed.add(chunk);

    }

}「跳过而不是抛错」是这里的要害。抛异常会让整个补偿任务失败,其他租户的切片跟着一起积压——一个租户欠费,所有租户都停摆。
用 computeIfAbsent 缓存判断结果,避免同租户的切片反复查库。
3.1 用量统计用 SQL 聚合
/**

 * 文档总大小(MB,向上取整)。

 *

 * <p>用 SUM() 聚合而不是把 file_size 全查回来求和:文档上万时后者会把

 * 几十万行数据搬到应用内存里,只为算一个加法。</p>

 */

private long totalStorageMb() {

    List<Object> objects = kbDocumentMapper.selectObjs(

            Wrappers.<KbDocumentEntity>query().select("IFNULL(SUM(file_size), 0)"));

    // ...

}
3.2 计数走拦截器,不手写租户条件
/** 文档数(实时;有请求上下文时由拦截器补租户条件) */

private long countDocuments() {

    Long count = kbDocumentMapper.selectCount(null);

    return count == null ? 0L : count;

}
注意这里 selectCount(null) 看起来是”查全表”,实际上拦截器会补上 tenant_id 条件。注释里特意说明”有请求上下文时由拦截器补租户条件”——这是依赖拦截器的写法,如果哪天这个方法被调度线程调用,就会统计到所有租户,所以注释必须写清楚这个前提。
四、用量可视化
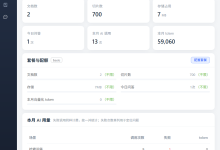
前端展示租户用量(文档数 / 切片数 / 存储 / 问答次数 / token),超过 80% 时预警。
预警的意义在于:配额拦截是”硬墙”,撞上去会直接中断服务;而 80% 预警给了租户提前扩容的时间窗口。对 SaaS 来说,让客户因为撞配额而中断业务,比让他多付点钱糟糕得多。
还有两个体验细节:
① 未配置向量模型时,页面显示「未启用」而不是点下去才报错。让使用者提前知道功能不可用,比让他点了按钮等几秒再看到错误好得多。
② 不限量时不显示剩余次数。dailyRemaining 返回 null 让前端不渲染这一项,而不是显示一个巨大的假数字。
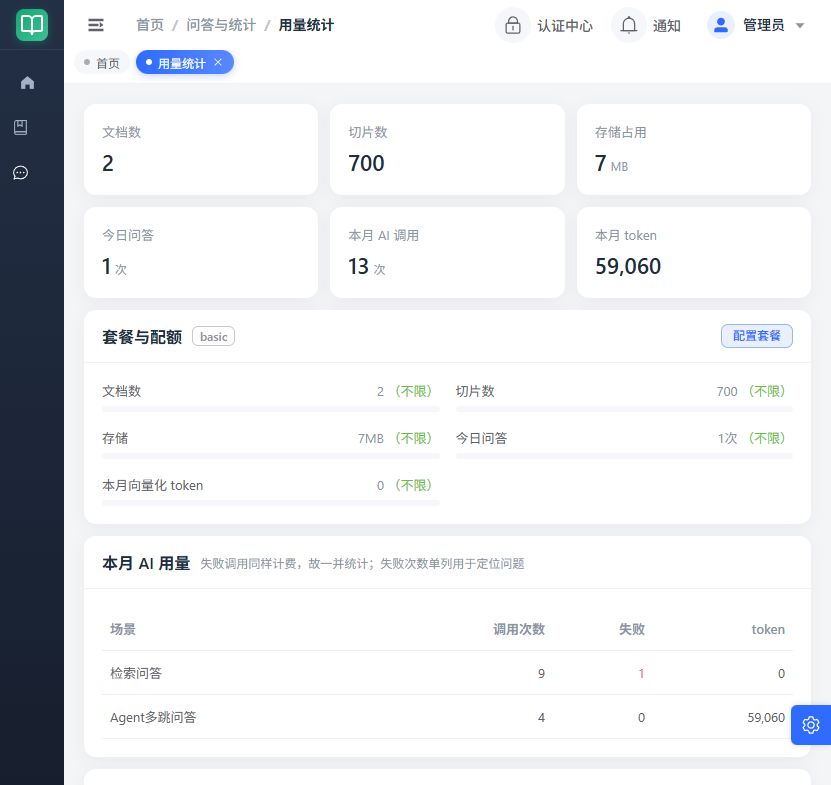
图:用量统计,文档/切片/存储/问答/调用按场景拆分,失败调用同样计费。
五、小结
两条红线的共同点是:它们失效的时候都不会当场报错。
租户隔离漏了一层,系统照常运行,只是某个时刻用户看到了别人的数据;成本失控也一样,功能一切正常,只是账单在涨。这类问题的应对方式只能是在架构层面把闸门设成「默认关闭、显式开启」,而不是依赖运行时检查。
四个具体的硬约束:
- 向量检索必须显式带租户条件——MyBatis 拦截器管不到它
- 配额要原子占用——一条 UPDATE 同时完成判断与计数,中间不能有窗口
- SET 子句顺序不能颠倒——先算计数再改日期,否则跨天归零失效
- 补偿任务的配额按切片自身租户判断——且跳过而非抛错,避免一个租户拖垮全部
下一篇讲 Agent 的设计,以及整仓升级 Spring Boot 时踩到的两个真实坑。