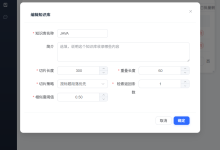
本系列共 9 篇,从空目录搭到可部署的 Python RAG 知识库。这是第 4 篇。 文件已经进了 MinIO,数据库里只有一条“待解析”的记录。这一篇把它变成一堆带标题路径的切片:解析五种格式、按标题和句子切块、把切片落库,再用定时任务兜住失败和卡死的任务。 图:知识库参数,切片长度、重叠与切片策略决定解析结果。 一、解析器:纯函数,不碰数据库 解析层只做一件事:字节 → 带结构的文本块。ParsedBlock 里两个字段,text…
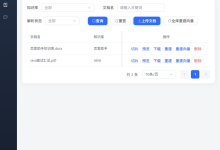
本系列共 9 篇,从空目录搭到可部署的 Python RAG 知识库。这是第 3 篇。 登录和数据库通了,现在开始做业务。这一篇完成后:能创建知识库、上传一份文件、在文档列表里看到它,并且重复上传同一个文件不会产生两条记录。 图:文档管理,上传后可切片、预览、重建。 一、知识库:先有一个“容器” 知识库表里除了名称、简介,还存了后续检索要用的参数:切片大小、重叠长度、topK、相似度阈值。这些参数跟着库走,而不是写死在代码里。 clas…
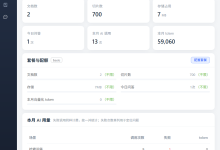
本系列共 9 篇,从空目录搭到可部署的 Python RAG 知识库。这是第 2 篇。 第 1 篇只让服务能启动;这一篇让它“认识人”和“存住数据”。完成后:不带 token 访问受保护接口返回 401,用认证中心的 ticket 换到本地 token 后能正常访问,并且所有查询都自动限定在当前租户内。 图:用量统计按租户统计文档、切片、存储、问答与 AI 调用,套餐配额单列。 一、先建表:8 张业务表 + 1 张向量表 业务数据放 P…
本系列共 9 篇,目标是从一个空目录开始,搭出一套能上传文档、能检索、能带出处回答的 Python AI 知识库。这是第 1 篇。 这一篇不碰业务,只做三件事:把项目骨架立起来、把配置和返回格式定好、让服务能启动并通过健康检查。听起来简单,但这三件事如果一开始没定好,后面每加一个接口都要返工。 图:服务跑起来后,知识库列表能看到两个库及切片与检索参数。 一、先看最终形态 本篇只创建最小的目录,后面每篇往里加东西: kb-api/ ├─ …
这一篇实现从「切片入库」到「双路召回融合」的完整链路。核心是一个容易被忽略的设计:为什么必须保留关键词召回。 一、切片入库 @Override @Transactional(rollbackFor = Exception.class) public void
Spring AI Alibaba 提供了构建 RAG 系统的核心组件和模块化架构: // ETL Pipeline 组件 import org.springframework.ai.document.Document; import or
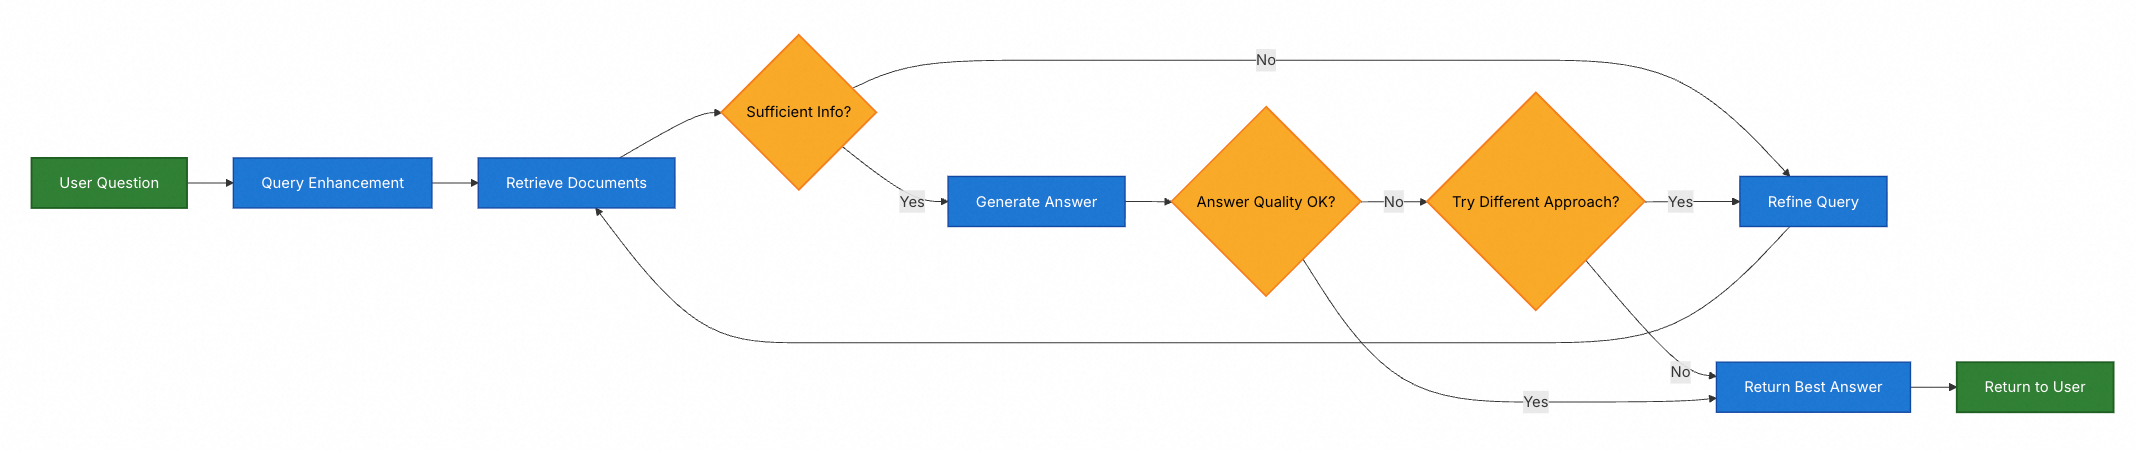
混合 RAG 结合了两步 RAG 和 Agentic RAG 的特点。它引入了中间步骤,如查询预处理、检索验证和生成后检查。这些系统比固定管道提供更多灵活性,同时保持对执行的一定控制。 典型组件包括: 查询增强:修改输入问题以提高检索质量。
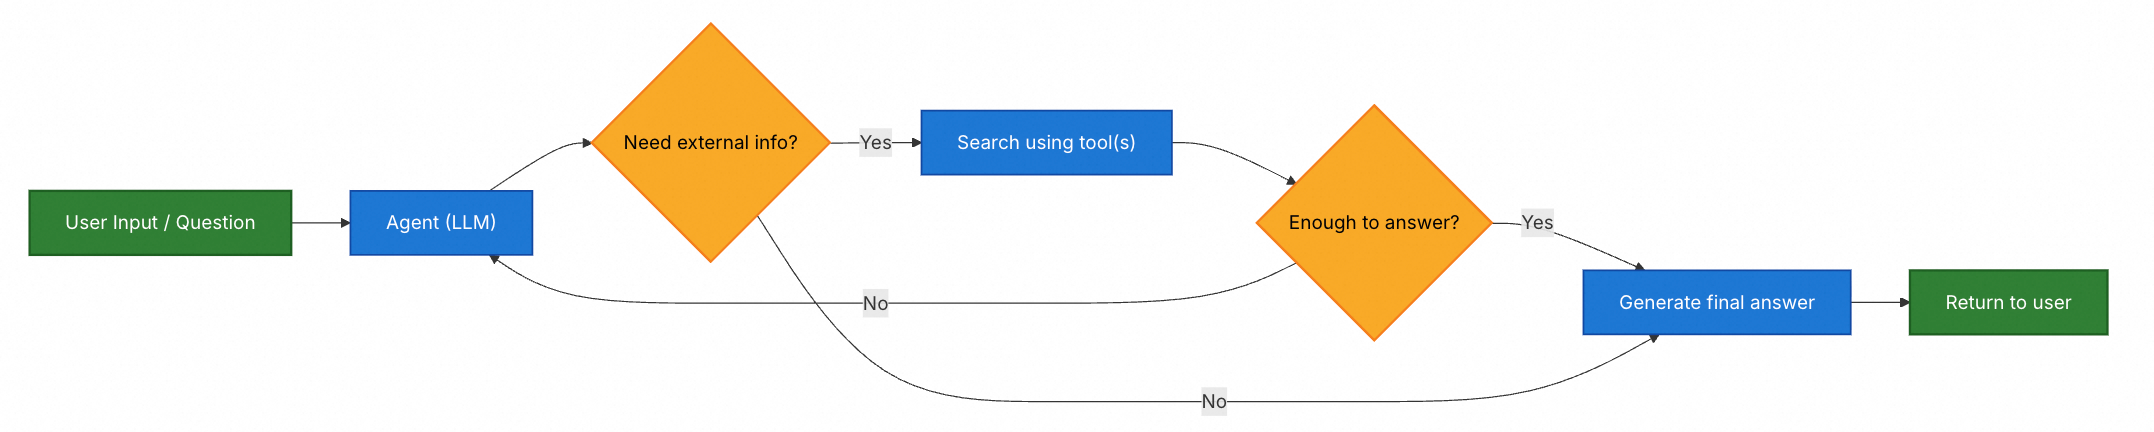
Agentic 检索增强生成(RAG)将检索增强生成的优势与基于 Agent 的推理相结合。Agent(由 LLM 驱动)不是在回答之前检索文档,而是逐步推理并决定在交互过程中何时以及如何检索信息。 提示Agent 启用 RAG 行为所需的
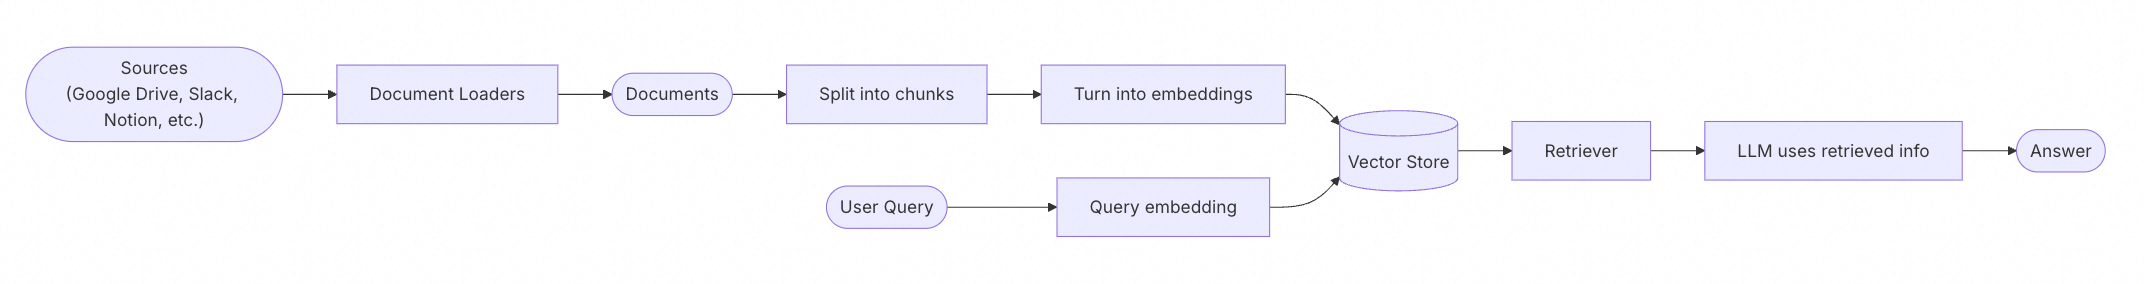
大型语言模型(LLM)虽然强大,但有两个关键限制: 有限的上下文——它们无法一次性摄取整个语料库静态知识——它们的训练数据在某个时间点被冻结 检索通过在查询时获取相关的外部知识来解决这些问题。这是**检索增强生成(RAG)**的基础:使用特

 AI项目博客
 admin
最新评论
干货满满!
江苏省 南京市 · IP 49.91.145.*
我要看文章
重庆市 · IP 116.168.9.*
这个内容实在是太精彩啦
重庆市 · IP 123.147.232.*